


Никакого облака, никаких GPU — никаких проблем: новая модель LFM2.5-2.6B от Liquid AI переносит мощных ИИ-агентов на такие миниатюрные устройства, как Raspberry Pi
Источник: VentureBeat · Carl Franzen


Ранее на этой неделе ИИ-стартап Liquid, основанный в 2023 году бывшими специалистами Массачусетского технологического института по компьютерным наукам, представил LFM2.5-2.6B — новую языковую модель с открытыми весами, разработанную специально для автономных (агентных) рабочих нагрузок.
В релизных материалах и недавнем интервью VentureBeat исследователи Liquid отметили, что LFM2.5-2.6B способна работать полностью на локальном оборудовании — от смартфонов и ноутбуков до Raspberry Pi — без использования облачного инференса или графических процессоров. Это открывает возможности для периферийного ИИ (edge AI) и предоставляет больше вариантов для компаний из регулируемых отраслей или работающих с конфиденциальной информацией, которую они не хотят передавать в облако.
Модель лучше всего подходит для высокообъемных, четко определенных локальных агентских задач — вызова функций (tool calling), управления документами, автоматизации календарей и рабочих процессов, постоянных фоновых рутин, а также для сред с ограниченным подключением, таких как транспортные средства и робототехника. При этом работу со сложным написанием кода лучше доверить более крупным моделям.
Даже для тех компаний, у которых нет подобных опасений, привлекательность запуска производительных специализированных агентов по цене практически одной лишь электроэнергии может сделать новую модель весьма востребованной.
Тем не менее, юридическим отделам предприятий стоит внимательно изучить кастомную лицензию на открытые веса — точно так же, как это было с более крупной пограничной моделью Kimi K3 от Moonshot, выпущенной в прошлом месяце.
Основные характеристики
LFM2.5-2.6B содержит 2,6 миллиарда параметров, поддерживает контекстное окно на 128 000 токенов и включает нативный вызов функций. Несколько необычное название объясняется сочетанием поколения модели (2.5) и количества параметров (2.6B).
Как дообученная модель, так и базовая контрольная точка (LFM2.5-2.6B-Base) для разработчиков, желающих провести точная настройка (fine-tune), уже доступны на Hugging Face с поддержкой «из коробки» основных стеков инференса, включая llama.cpp, MLX, vLLM, SGLang и ONNX. Это делает модель готовой к развертыванию на потребительском железе, корпоративной инфраструктуре и встраиваемых системах.
Liquid также предлагает фреймворк для дообучения с открытым исходным кодом под названием LEAP.
Компания не позиционирует LFM2.5-2.6B как конкурента крупнейшим пограничным моделям (frontier models). Вместо этого она выдвигает иной аргумент: достаточно мощная маленькая модель способна открыть те категории корпоративных приложений, где задержка, конфиденциальность, гибкость развертывания или затраты на инференс важнее абсолютного лидерства в бенчмарках.
«Я также считаю, что лучшие модели будут находиться в облаке, и в этом нет ничего плохого», — рассказал Максим Лабонн (Maxime Labonne), руководитель отдела пост-тренинга в Liquid AI, в интервью VentureBeat после запуска. — «Мы хотим создавать модели для другого типа пользователей, и лучше всего это описать так: вам следует использовать [периферийный ИИ], когда вы не можете использовать облачную модель».
Достаточно мала для Raspberry Pi
Отвечая на вопрос о минимально жизнеспособном оборудовании, Лабонн отметил, что модель работает «очень-очень хорошо» на центральных процессорах (CPU), а архитектура LFM2, лежащая в ее основе, изначально проектировалась с учетом производительности реальных CPU, а не бенчмарков GPU.
«Я думаю, лучший пример — это Raspberry Pi, — сказал он. — У нас есть множество демоверсий, которые показывают, что на самом деле на Raspberry Pi она работает довольно быстро».
Заявленные компанией показатели указывают на скорость декодирования около 220 токенов в секунду на чипе Apple M5 Max и 113 токенов в секунду на AMD Ryzen AI Max+ 395 при использовании менее 2,5 ГБ памяти, а также около 30 токенов в секунду на смартфоне. Пользователи могут протестировать модели на своих телефонах через Apollo — мобильное приложение Liquid AI.
На другом конце спектра развертывания Liquid AI заявляет, что при постоянной одновременной нагрузке на одном графическом процессоре Nvidia H100 модель выдает почти 15 000 токенов в секунду — примерно 1,3 миллиарда токенов в день с одной карты. Эти цифры получены на основе бенчмарков производителя и не были независимо проверены.
Для Лабонна объем памяти и скорость — это не просто удобство, а жесткие ограничения, которые определяют, что вообще может быть развернуто.
«Мы хотим показать, что это отличное соотношение: вы получаете уровень качества, сопоставимый с гораздо более крупными моделями, но в крошечном форм-факторе, — пояснил он. — Вы можете развернуть ее на целевых устройствах, куда другие модели вообще невозможно поместить».
Обучена для агентов, а не для чат-ботов
В Liquid AI заявляют, что LFM2.5-2.6B разрабатывалась с расчетом на то, что языковые модели все чаще используются через агентские фреймворки, а не традиционные интерфейсы для бесед.
«Модели больше не потребляются в чат-ботах. Они задействуются через агентские обвязки (harnesses), такие как OpenClaw или Hermes Agent, — отметил Лабонн. — Мы хотели убедиться, что эта модель хороша не только в математике или коде, но и в использовании инструментов».
Модель предобучена примерно на 34 триллионах токенов, ее словарь был увеличен вдвое до 128 тыс. токенов для лучшей поддержки нелатинских алфавитов, а также был проведен выделенный этап промежуточного обучения (mid-training) для расширения контекстного окна до 128 тыс. токенов для долгосрочных агентских рабочих процессов.
Пост-тренинг включает четырехэтапный конвейер: контролируемое дообучение (supervised fine-tuning), специализация учителей (обучение отдельных экспертных моделей для таких доменов, как следование инструкциям, математика, код и использование инструментов), многодоменная дистилляция «на политике» (MOPD) для объединения возможностей этих экспертов в единую модель-студент, и, наконец, агентное обучение с подкреплением.
На последнем этапе модель обучалась непосредственно внутри реальных производственных агентских обвязок — включая Hermes Agent и OpenClaw — на реалистичных продуктивных задачах, затрагивающих исследования, написание кода, управление документами, вызов инструментов и автоматизацию рабочих процессов. Это позволило подвергнуть ее воздействию реальных инструментов, системных промптов и паттернов взаимодействия таких обвязок.
Лабонн охарактеризовал модернизацию этого конвейера как «счастливую случайность»: улучшения вышли далеко за рамки запланированных агентских показателей.
«Благодаря этим новым методам обучения мы также стали намного лучше во всем остальном. Мы подтянули математику, следование инструкциям. На самом деле мы никогда не были сильны в коде — а с этим подходом мы даже в коде стали очень хороши», — добавил он.
Создание модели и обвязки
Примечательно, что Liquid AI также создала собственную агентскую обвязку, не полагаясь исключительно на существующие фреймворки, и продемонстрировала работу модели внутри нее на смартфоне — планирование и вызов инструментов происходили полностью на устройстве.
«Это обвязка, запущенная на телефоне, и я не знаю, есть ли какая-либо другая обвязка, работающая на смартфонах», — сказал Лабонн.
По его словам, у компании было две причины для этого. Первая — необходимость: нативных обвязок для телефонов просто не существовало. Вторая заключается в другой модели взаимодействия: современные обвязки ждут подсказки (промпта), в то время как Liquid AI стремится создать ассистентов, действующих самостоятельно.
«Нам нужны проактивные агенты. Нам нужны агенты, которые работают в фоновом режиме, проверяют, что вы делаете, смотрят ваш календарь и на основе этого контекста выполняют задачи, — пояснил он. — Сегодня этого по сути не существует».
Совместная разработка обвязки и модели также позволяет программному обеспечению компенсировать слабые места последней. «Все, в чем модель плоха, обвязка должна ей помочь преодолеть — предоставить максимум поддержки, чтобы сделать работу более надежной, — подчеркнул Лабонн. — Конечным пользователям все равно, работает ли это на уровне модели или обвязки. Им нужно, чтобы задача в итоге была выполнена».
Тем не менее, модель работает «из коробки» с уже устоявшимися обвязками, включая Hermes Agent, OpenClaw и Pi, если они развернуты за любой эндпоинтом, совместимым с OpenAI.
Меняйте обвязку, а не модель
Говоря о корпоративном развертывании, Лабонн заявил, что этот релиз знаменует смену парадигмы в том, для чего могут использоваться маленькие модели. По его словам, до сих пор локальные модели имели экономический смысл главным образом в качестве узкоспециализированных настроенных решений — обученных выполнять одну задачу с качеством облачных моделей, но гораздо быстрее и дешевле. Агентные возможности меняют этот расчет, поскольку ту же самую модель можно перепрофилировать, меняя окружающие ее инструменты, а не саму модель.
«У вас может быть помощник по календарю, и вы можете использовать ту же модель для создания ассистента для встреч, который будет записывать все сказанное и суммировать это — чем-то похоже на Granola, например, — сказал он. — Вы не меняете модель; вы просто меняете обвязку. Вы просто меняете инструменты вокруг нее. Это обеспечивает гораздо большую универсальность, а также делает процесс намного проще и дешевле».
Тем не менее, для производственных развертываний он по-прежнему рекомендует дообучение, когда это возможно: «Если вы не дообучаете модель, вы упускаете часть ее потенциала в плане качества. Если вы настроите ее хорошо, она сравняется по производительности с GPT и Claude — по крайней мере, если ваша задача не является самой сложной в мире», — отметил он, добавив, что барьер для входа рухнул: «Порог для проведения дообучения сейчас супернизкий. Это очень доступно для каждого».
Как новинка соотносится с DeepSeek-V4-Flash, Gemma от Google и Qwen от Alibaba
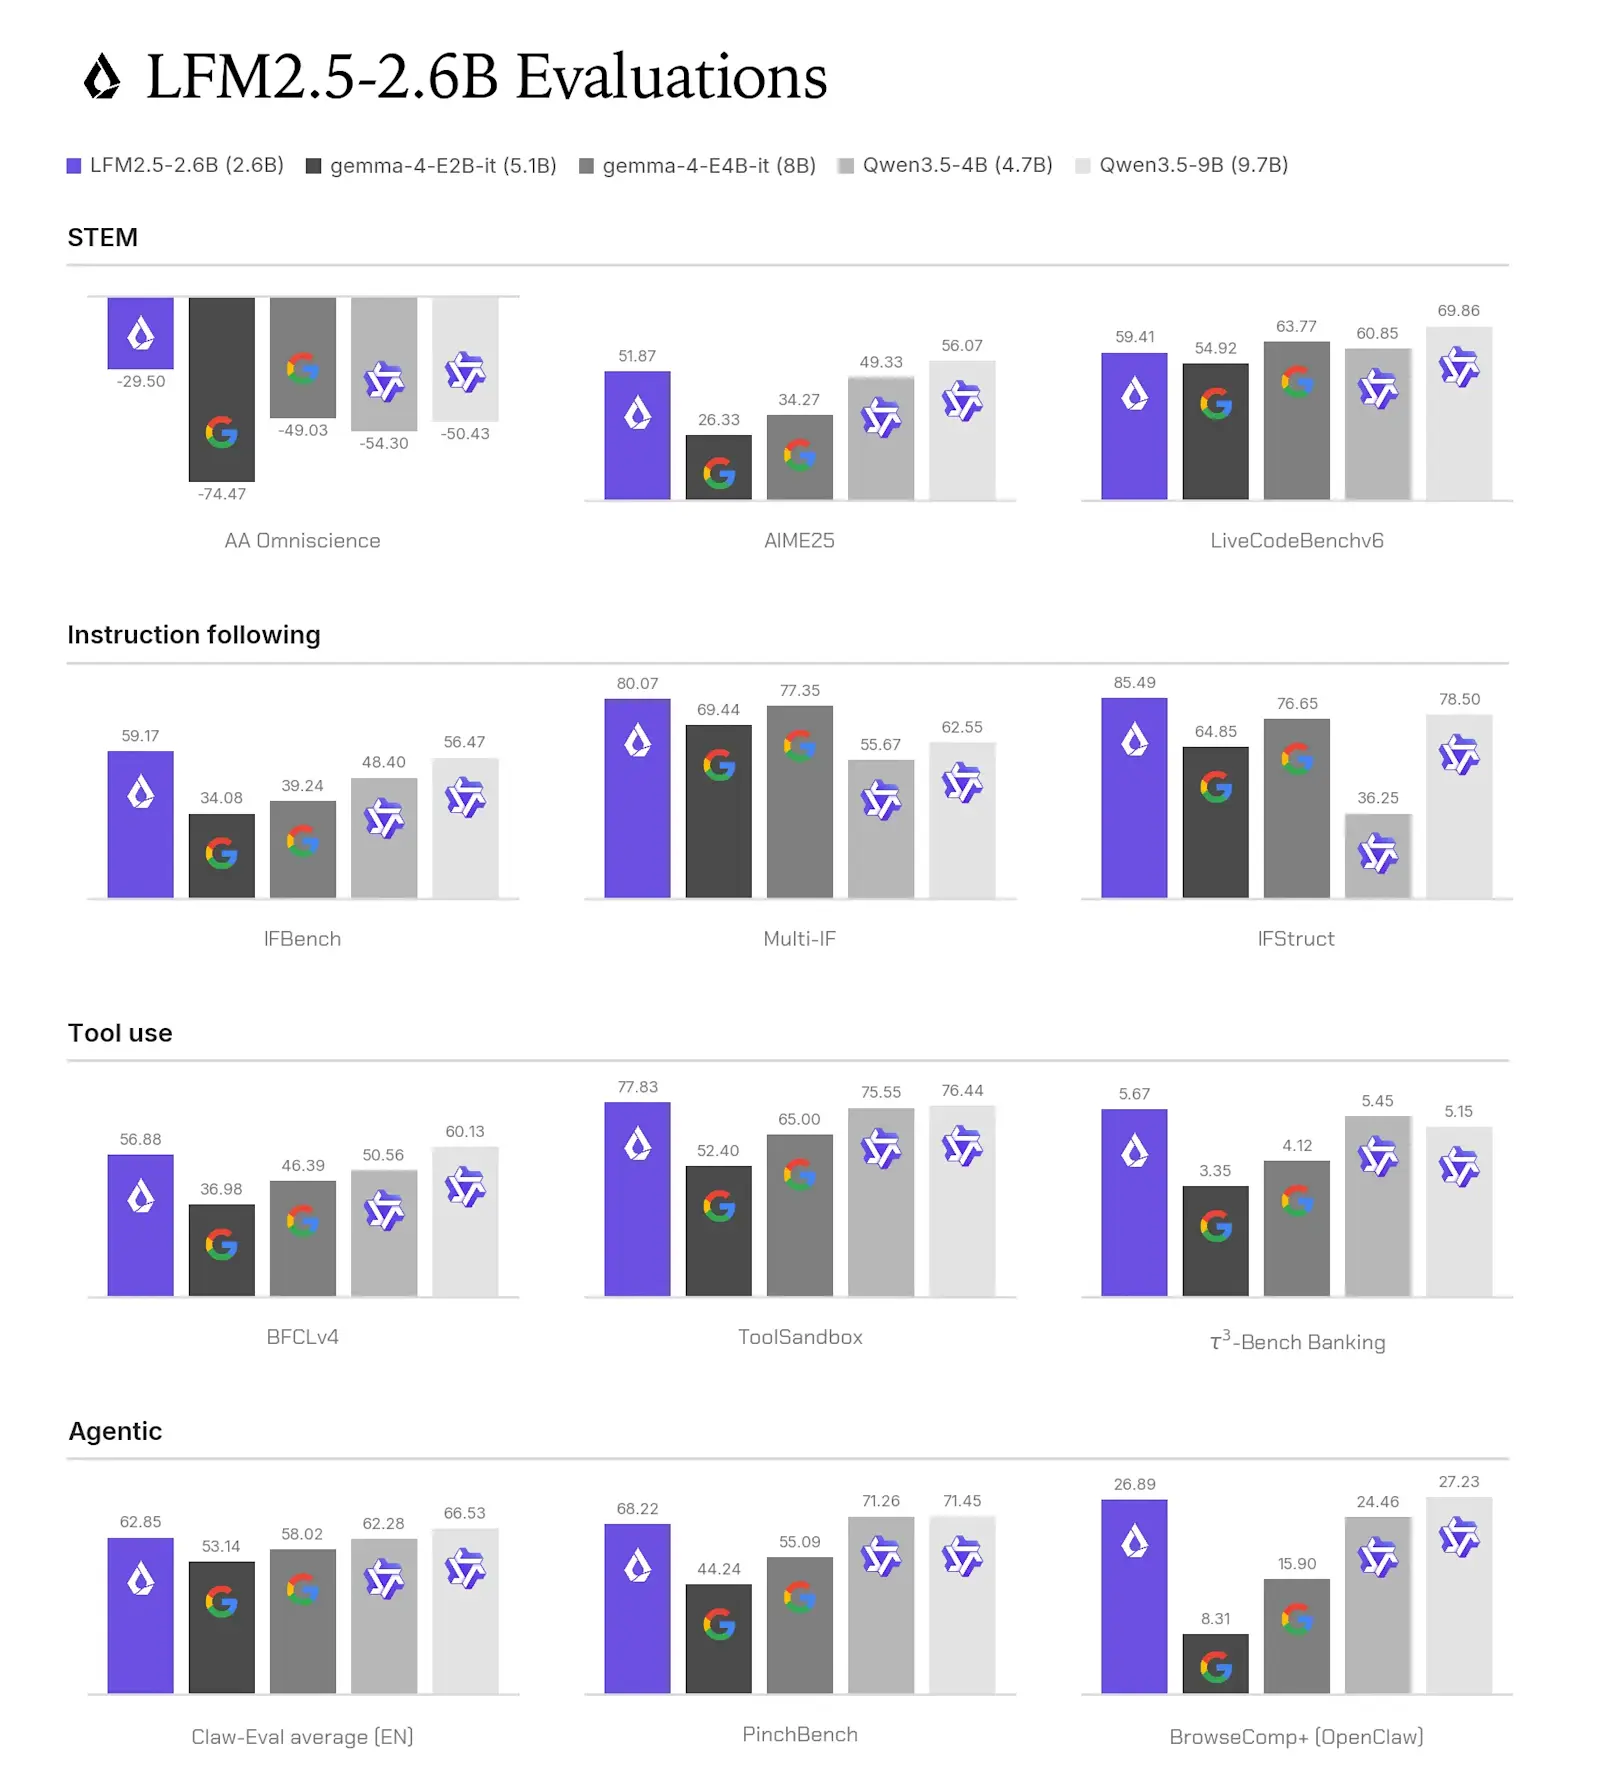
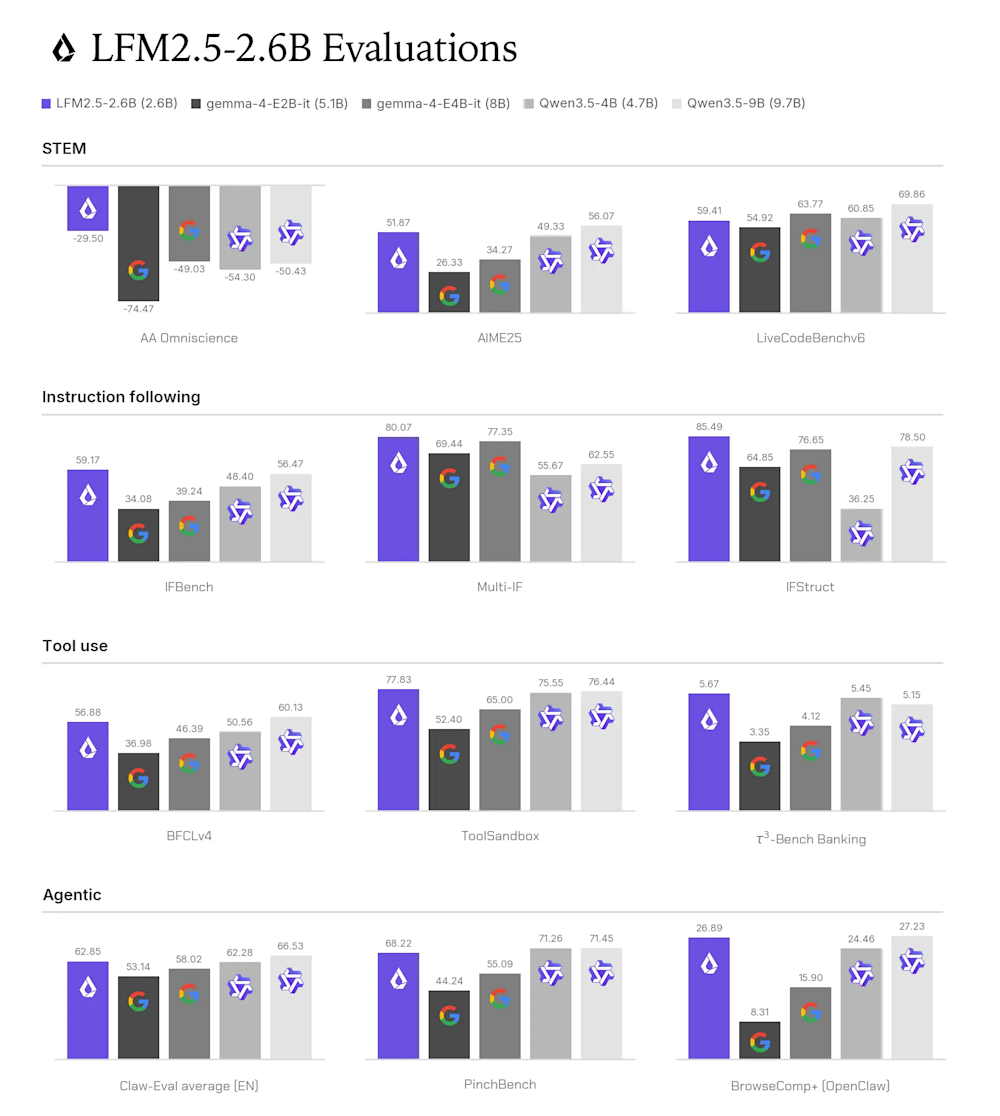
Liquid AI выпустила собственные сравнительные графики бенчмарков, противопоставляющие LFM2.5-2.6B тем моделям, которые предприятия чаще всего рассматривают для аналогичных периферийных развертываний: Gemma 4 E2B (5,1 млрд параметров) и E4B (8 млрд) от Google, а также Qwen3.5-4B (4,7 млрд) и Qwen3.5-9B (9,7 млрд) от Alibaba.
Отдельное тестирование, проведенное платформой локальных ИИ-клиентов Atomic Chat, показало, что LFM2.5-2.6B выполнила 35 вызовов функций для решения трех задач (проверка погоды и местного времени в шести городах, конвертация одного бюджета в шесть валют, проверка четырех отелей и бронирование на определенную дату) в 3,7 раза быстрее, чем DeepSeek-V4-Flash (модель с колоссальными 284 млрд параметров), которая взлетела на вершину OpenRouter после своего релиза на прошлой неделе.
Маленькие модели Gemma 4 являются мультимодальными генералистами, принимающими на вход изображения и аудио наряду с текстом, и используют архитектуру Per-Layer Embeddings, при которой для каждого токена активной остается лишь доля весов — именно поэтому Google продает их под видом «эффективного» размера (2,3B и 4,5B), несмотря на общий объем в 5,1B и 8B параметров. Семейство небольших моделей Qwen3.5 от Alibaba, выпущенное в марте, является нативно мультимодальным начиная с версии 4B и опирается на масштабируемое обучение с подкреплением в погоне за рассуждениями пограничного уровня — Alibaba заявляет, что модель 9B не уступает или превосходит гораздо более крупную модель OpenAI gpt-oss-120B на бенчмарках рассуждений.
LFM2.5-2.6B идет по более узкому пути: она работает только с текстом, является плотной (dense) и специализируется на агентской работе, при этом Liquid AI выпускает отдельные версии семейства LFM для работы с видеона и аудио, вместо того чтобы объединять все в одну контрольную точку.
Если обучение с подкреплением при пост-тренинге Qwen нацелено на рассуждения, то подход Liquid нацелен на использование инструментов внутри реальных агентских обвязок.
Результатом, согласно опубликованным компанией данным, является то, что самая маленькая модель в сравнении лидирует во всех тестах на следование инструкциям (IFBench, Multi-IF, IFStruct) и практически во всех тестах на использование инструментов (77,83 балла в ToolSandbox против 76,44 у Qwen3.5-9B, модели почти в четыре раза большего размера), уступая только этой 9B-модели в BFCLv4.
Источник: Liquid AI
В агентских оценках она превосходит обе модели Gemma по всем направлениям и практически идет вровень с Qwen: 26,89 балла в BrowseComp+ против 27,23 у Qwen3.5-9B. Она также демонстрирует лучший результат в AA Omniscience — бенчмарке знаний, который наказывает за галлюцинации.
Модели Qwen сохраняют преимущество там, где сосредоточен фокус их обучения: в математике (Qwen3.5-9B лидирует в AIME25) и написании кода, где более крупные модели сохраняют преимущество в LiveCodeBench, хотя Лабонн отметил, что этот разрыв меньше, чем можно было бы ожидать судя по числу параметров.
«В LiveCodeBench v6 мы, возможно, не лучшие среди этих моделей, но мы также и самые маленькие с большим отрывом. Тот факт, что мы конкурентоспособны с ними, для меня уже огромная победа», — сказал он.
Одно различие работает в другую сторону — лицензирование. Gemma 4 и Qwen3.5 поставляются под мягкой лицензией Apache 2.0 — изменение, на которое Google пошла специально для привлечения предприятий. DeepSeek-V4-Flash поставляется под аналогично мягкой лицензией MIT.
В то же время лицензия Liquid AI с привязкой к выручке (подробнее см. ниже) требует от крупных компаний заключения коммерческого соглашения. Предприяятия, превышающие пороговое значение, фактически жертвуют лицензионными ограничениями ради компактности и высокой производительности при вызове инструментов.
Лицензирование как коммерческий компромисс
LFM2.5-2.6B распространяется по лицензии LFM Open License v1.0, которая разрешает использование, модификацию и распространение — включая коммерческое использование — для организаций с годовым доходом менее 10 миллионов долларов. Коммерческое использование более крупными компаниями данной лицензией не покрывается и требует отдельного соглашения с Liquid AI; квалифицированные некоммерческие организации освобождаются от этого лимита в некоммерческих и исследовательских целях.
Лабонн охарактеризовал эту структуру как способ поддержания разработки моделей — «модели — это действительно наш ров [вокруг замка], поэтому мы должны подходить к их лицензированию разумно; иначе мы не сможем зарабатывать деньги, а значит, не сможем создавать новые модели», — охарактеризовав при этом порог как гибкий механизм на практике.
На вопрос о том, как компания вообще узнает, если крупное предприятие тихо развернет открытые веса, он ответил прямо: «Я думаю, это вопрос к нашему юридическому отделу, но лично я не знаю. И даже если ваш доход превышает 10 миллионов долларов, единственное, о чем мы вас просим, — это связаться с нами».
По его словам, компания сопровождает свои лицензированные релизы моделей свободно публикуемыми исследованиями, включая новые оценки структурированного вывода и метод обучения, который смягчает циклы повторения, характерные для небольших моделей (режим сбоя, в котором, по его словам, модели Qwen «несколько повинны»).
Маленькая модель, большие последствия для бизнеса
Запуск совпал с объявлением от MacPaw — украинской софтверной компании, создавшей CleanMyMac и Setapp, — о долгосрочном стратегическом партнерстве с Liquid AI для создания на устройстве ИИ-стека для Mac.
Liquid AI займется проектированием и доработкой базовых моделей для Eney (макос-ассистента от MacPaw), которые будут локально работать на кремниевых чипах Apple через инференс-движок Elix от MacPaw и слой памяти Mnemos. Результаты ожидаются позже в этом году.
Лабонн указал на эту сделку как на конкретное подтверждение аргумента о размере: «Одна из причин, почему они выбрали нас, заключается в том, что модель довольно мала, и у них нет такого бюджета памяти, чтобы запускать другие модели».
Релиз происходит на фоне того, как производители оборудования, разработчики операционных систем и компании, выпускающие корпоративное ПО, все активнее инвестируют в локальное выполнение ИИ, а агентские обвязки распространяются по всей индустрии. Ставка Liquid AI заключается в том, что именно экономика развертывания, а не сырой масштаб, определит важный сегмент этого рынка: агенты, работающие непрерывно, повсеместно и с нулевыми предельными затратами на токены.
Станут ли маленькие, высокооптимизированные агентские модели значимым сегментом корпоративного ИИ, в конечном итоге будет зависеть не столько от баллов в бенчмарках, сколько от операционной надежности. Однако последний релиз Liquid AI намекает на то, что следующий рубеж конкуренции заключается уже не просто в создании более крупных моделей — он заключается в создании моделей, достаточно маленьких и способных работать везде, где уже живут рабочие процессы предприятий.




