


Компактная и открытая модель Qwen3.5-9B от Alibaba превосходит gpt-oss-120B от OpenAI и способна работать на обычных ноутбуках


Несмотря на политическую турбулентность в сфере искусственного интеллекта в США, в Китае развитие ИИ продолжается полным ходом и без каких-либо заминок.
Ранее сегодня команда Qwen, занимающаяся исследованиями в области ИИ в технологическом гиганте Alibaba и сосредоточенная главным образом на разработке и выпуске растущего семейства мощных и способных языковых и мультимодальных ИИ-моделей с открытым исходным кодом Qwen, представила свою новейшую партию — серию малых моделей Qwen3.5, в которую вошли:
-
Qwen3.5-0.8B и 2B: две модели, оптимизированные для «крошечной» и «быстрой» производительности, предназначенные для прототипирования и развертывания на периферийных устройствах, где критически важен срок службы батареи.
-
Qwen3.5-4B: прочная мультимодальная база для легких агентов с нативной поддержкой контекстного окна в 262 144 токена.
-
Qwen3.5-9B: компактная модель для рассуждений, которая превосходит по ключевым сторонним бенчмаркам (включая многоязычные знания и рассуждения уровня выпускника вуза) конкурирующую американскую модель gpt-oss-120B с открытым исходным кодом от OpenAI, которая в 13,5 раза крупнее.
Если сопоставить это с общим положением дел, то данные модели находятся на уровне наименьших моделей общего назначения, выпускаемых в последнее время любой лабораторией мира. Они ближе к серии LFM2 от LiquidAI (ответвления MIT), также насчитывающей несколько сотен миллионов или миллиардов параметров, чем к предполагаемому триллиону параметров (настроек модели), которые, по сообщениям, используются во флагманских моделях от OpenAI, Anthropic и серии Gemini от Google.
Веса для этих моделей уже доступны по всему миру по лицензии Apache 2.0, что идеально подходит для корпоративного и коммерческого использования, включая настройку по мере необходимости, на Hugging Face и ModelScope.
Технология: гибридная эффективность и нативная мультимодальность
Техническая основа малой серии Qwen3.5 представляет собой отход от стандартных архитектур Transformer. Компания Alibaba перешла к эффективной гибридной архитектуре (Efficient Hybrid Architecture), которая объединяет сети Gated Delta Networks (форму линейного внимания) со разреженной смесью экспертов (Mixture-of-Experts, MoE).
Этот гибридный подход решает проблему «стены памяти», которая обычно ограничивает возможности небольших моделей. Благодаря использованию сетей Gated Delta Networks модели достигают более высокой пропускной способности и значительно меньшей задержки во время инференса.
Кроме того, эти модели являются нативно мультимодальными. В отличие от предыдущих поколений, где визуальный энкодер «прикручивался» к текстовой модели, Qwen3.5 обучалась с использованием раннего слияния (early fusion) на мультимодальных токенах. Это позволяет моделям размером 4B и 9B демонстрировать уровень визуального понимания (например, чтение элементов пользовательского интерфейса или подсчет объектов на видео), для которого раньше требовались модели, превосходящие их по размеру в десять раз.
Бенчмарки «малой» серии: производительность, бросающая вызов масштабу
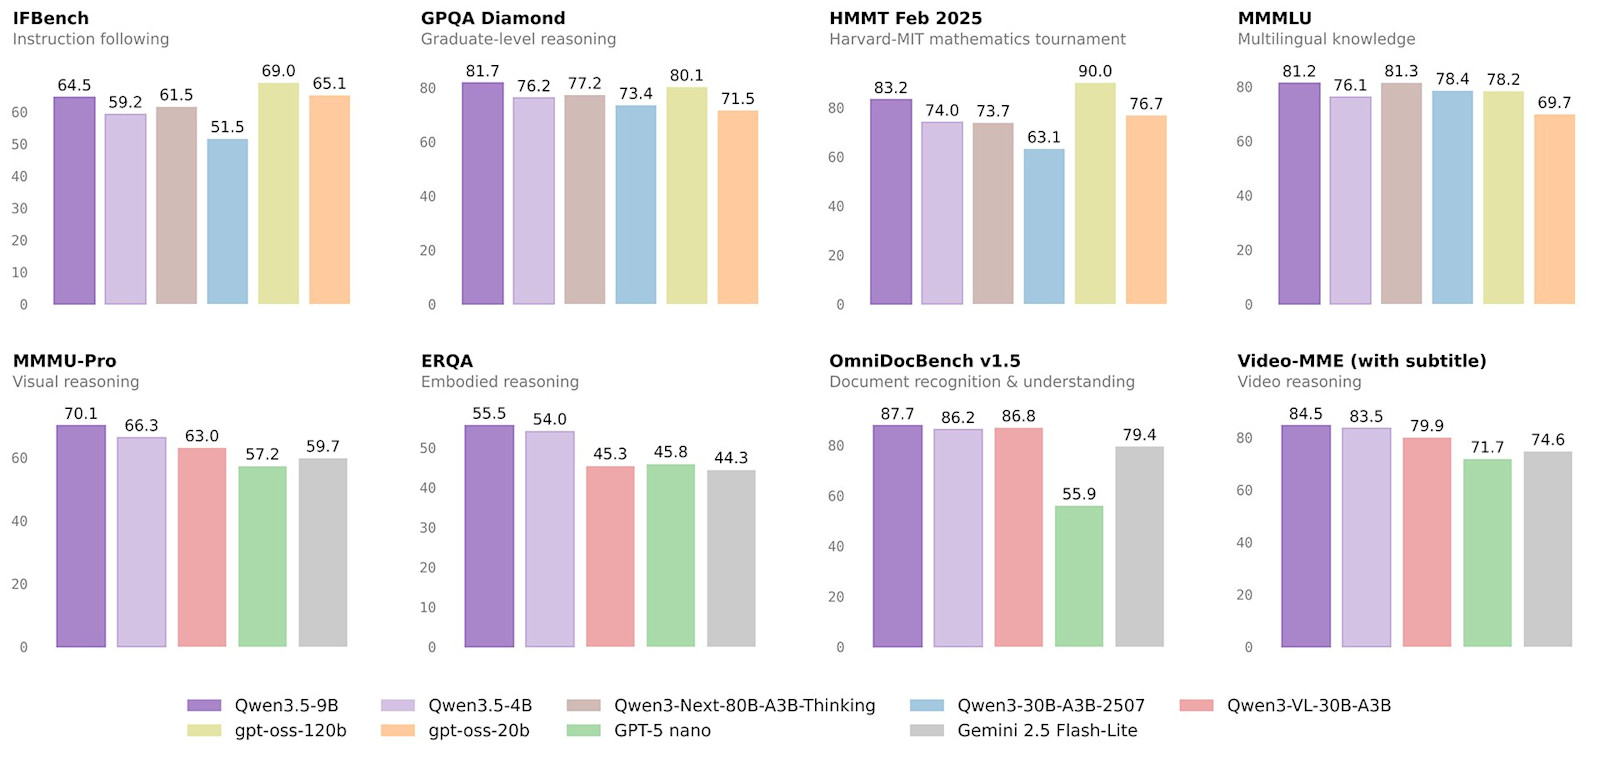
Недавно опубликованные данные бенчмарков наглядно показывают, насколько агрессивно эти компактные модели конкурируют с гораздо более крупными отраслевыми стандартами и зачастую превосходят их. Варианты Qwen3.5-9B и Qwen3.5-4B демонстрируют межпоколенческий скачок в эффективности, особенно в задачах мультимодальности и логического вывода.
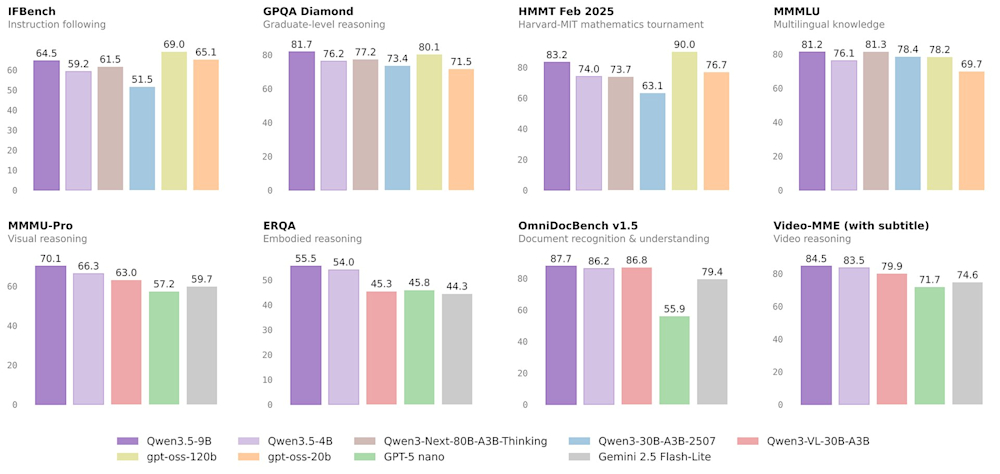
Результаты тестов серии малых моделей Qwen3.5 по сравнению с другими моделями аналогичного размера и класса. Источник: Alibaba Qwen
Мультимодальное превосходство: В бенчмарке визуального рассуждения MMMU-Pro модель Qwen3.5-9B набрала 70,1 балла, опередив Gemini 2.5 Flash-Lite (59,7) и даже специализированную Qwen3-VL-30B-A3B (63,0).
Рассуждения уровня выпускника вуза: В бенчмарке GPQA Diamond модель размером 9B набрала 81,7 балла, превзойдя gpt-oss-120b (80,1) — модель, количество параметров которой превышает ее показатели более чем в десять раз.
Понимание видео: Серия показывает элитную производительность в видеорассуждениях. В бенчмарке Video-MME (с субтитрами) Qwen3.5-9B набрала 84,5 балла, а 4B — 83,5 балла, значительно опередив Gemini 2.5 Flash-Lite (74,6).
Математические способности: В оценке HMMT за февраль 2025 года (математический турнир Гарвард-MIT) модель 9B набрала 83,2 балла, а вариант 4B — 74,0 балла, доказав, что для рассуждений по предметам STEM (наука, технология, инженерия и математика) высокого уровня больше не требуются массивные вычислительные кластеры.
Документы и многоязычные знания: Вариант 9B лидирует в распознавании документов в OmniDocBench v1.5 с результатом 87,7 балла. При этом он удерживает позиции в топ-рейтинге многоязычности на MMMLU с результатом 81,2 балла, опережая gpt-oss-120b (78,2).
Реакция сообщества: «больше интеллекта, меньше вычислений»
Сразу после выхода на прошлой неделе довольно компактной и мощной открытой модели Qwen3.5-Medium, способной работать на одном GPU, анонс серии малых моделей Qwen3.5 с еще меньшими требованиями к памяти и обработке вызвал мгновенный интерес у разработчиков, сфокусированных на ИИ с преобладанием локальной обработки («local-first»).
Лозунг «Больше интеллекта, меньше вычислений» нашел отклик у пользователей, ищущих альтернативу облачным моделям.
Эксперт в области ИИ и технологий Пол Кувер (Paul Couvert) из Blueshell AI выразил удивление индустрии по поводу этого скачка эффективности.
«Как это вообще возможно?! — написал Кувер в X. — Qwen выпустила 4 новые модели, причем версия 4B практически так же способна, как и предыдущая 80B A3B. А 9B так же хороша, как GPT OSS 120b, будучи при этом в 13 раз меньше!»
Анализ Кувера подчеркивает практические последствия этих архитектурных достижений:
-
«Они могут работать на любом ноутбуке»
-
«0.8B и 2B для вашего телефона»
-
«Офлайн и с открытым исходным кодом»
Как выразился разработчик Каран Кендре (Karan Kendre) из Kargul Studio: «эти модели [могут работать] локально на моем MacBook Air на чипе M1 бесплатно».
Это ощущение «потрясающей» доступности разделяют по всей экосистеме разработчиков. Один из пользователей отметил, что модель 4B, выступающая в качестве «надежной мультимодальной базы», меняет правила игры для мобильных разработчиков, которым необходимы возможности чтения с экрана без высоких накладных расходов на процессор.
Действительно, разработчик из Hugging Face Ксенова (Xenova) отметил, что новая серия малых моделей Qwen3.5 может запускаться даже прямо в веб-браузере пользователя и выполнять такие сложные операции, ранее требовавшие больших вычислительных ресурсов, как анализ видео.
Исследователи также высоко оценили выпуск базовых моделей (Base) наряду с версиями с инструктивным тюнингом (Instruct), отметив, что это обеспечивает необходимую поддержку для «реальных промышленных инноваций».
Появление базовых моделей особенно ценится корпоративными и исследовательскими командами, поскольку они представляют собой «чистый холст», на который не повлияла предвзятость конкретного набора данных RLHF (обучение с подкреплением на основе отзывов людей) или SFT (контролируемая тонкая настройка). Подобная предвзятость часто приводит к «отказам» или специфическим стилям общения, которые трудно исправить.
Теперь, благодаря базовым моделям, разработчики, заинтересованные в настройке модели под конкретные задачи и цели, получают более удобную отправную точку: они могут применить собственную настройку инструкций и пост-обучение, не избавляясь от чужих правок Alibaba.
Лицензирование: победа для открытой экосистемы
Компания Alibaba выпустила веса и файлы конфигурации для серии Qwen3.5 под лицензией Apache 2.0. Эта либеральная лицензия разрешает коммерческое использование, модификацию и распространение без выплаты роялти, устраняя «привязку к поставщику», характерную для проприетарных API.
-
Коммерческое использование: Разработчики могут интегрировать модели в коммерческие продукты без выплаты роялти.
-
Модификация: Команды могут проводить тонкую настройку (SFT) или применять RLHF для создания специализированных версий.
-
Распространение: Модели могут распространяться в локальных ИИ-приложениях, таких как Ollama.
Контекст новости: почему малый размер имеет такое значение именно сейчас
Выпуск малой серии Qwen3.5 происходит в момент «агентной переориентации» (Agentic Realignment). Мы отошли от простых чат-ботов; теперь цель — автономность. Автономный агент должен «думать» (рассуждать), «видеть» (обладать мультимодальностью) и «действовать» (использовать инструменты). Хотя делать это с помощью моделей с триллионами параметров непомерно дорого, локальная Qwen3.5-9B может выполнять такие циклы за долю этой стоимости.
Масштабируя обучение с подкреплением (RL) в средах с миллионами агентов, компания Alibaba наделила эти небольшие модели «суждением, согласованным с человеческим» (human-aligned judgment), что позволяет им решать многоэтапные задачи, например, упорядочивание элементов на рабочем столе или обратную разработку игровых видеоматериалов в код. Будь то модель 0.8B, работающая на смартфоне, или модель 9B, управляющая терминалом программирования, серия Qwen3.5 эффективно демократизирует «эпоху агентов».
Переход серии Qwen3.5 от «чат-ботов» к «нативным мультимодальным агентам» меняет то, как предприятия могут распространять интеллект. Перенеся сложные рассуждения на «периферию» (на индивидуальные устройства и локальные серверы), организации могут автоматизировать задачи, которые ранее требовали дорогих облачных API или обработки с высокой задержкой.
Стратегические корпоративные применения и аспекты
Модели размером от 0.8B до 9B перепроектированы для обеспечения эффективности и используют гибридную архитектуру, которая активирует только те части сети, которые необходимы для выполнения конкретной задачи.
-
Автоматизация визуальных рабочих процессов: Используя «попиксельную привязку» (pixel-level grounding), эти модели могут навигировать по пользовательским интерфейсам настольных ПК или мобильных устройств, заполнять формы и организовывать файлы на основе инструкций на естественном языке.
-
Сложный разбор документов: Имея показатели выше 90% в бенчмарках понимания документов, они могут заменить раздельные конвейеры распознавания текста (OCR) и разметки для извлечения структурированных данных из разнообразных форм и графиков.
-
Автономное программирование и рефакторинг: Предприятия могут загружать целые репозитории (до 400 000 строк кода) в контекстное окно размером 1M для готового к продакшену рефакторинга или автоматической отладки.
-
Периферийный анализ в реальном времени: Модели 0.8B и 2B предназначены для мобильных устройств, обеспечивая автономное создание кратких видеовывомок (до 60 секунд при 8 кадрах в секунду) и пространственные рассуждения без нагрузки на аккумулятор.
В таблице ниже показано, какие корпоративные функции могут извлечь наибольшую выгоду из развертывания локальных малоразмерных моделей.
|
Функция |
Основное преимущество |
Ключевой сценарий использования |
|
Разработка программного обеспечения |
Локальный интеллектуальный анализ кода |
Рефакторинг в масштабе всего репозитория и агентное программирование через терминал. |
|
Операции и IT |
Безопасная автоматизация |
Локальная автоматизация многоэтапных системных настроек и задач по управлению файлами. |
|
Продукты и UX |
Периферийное взаимодействие |
Интеграция нативных мультимодальных рассуждений непосредственно в мобильные/десктопные приложения. |
|
Данные и аналитика |
Эффективное извлечение |
Высококачественное распознавание текста (OCR) и извлечение структурированных данных из сложных визуальных отчетов. |
Несмотря на высокую функциональность этих моделей, их малый масштаб и «агентная» природа создают специфические операционные «флажки», за которыми команды должны следить.
-
Каскад галлюцинаций: В многоэтапных «агентных» рабочих процессах небольшая ошибка на раннем этапе может привести к «каскаду» сбоев, когда агент следует неверному или бессмысленному плану.
-
Отладка против написания кода с нуля (Greenfield): Хотя эти модели отлично справляются с написанием нового кода с чистого листа, им может быть трудно даваться отладка или модификация существующих сложных устаревших систем.
-
Требования к памяти и видеопамяти (VRAM): Даже «маленькие» модели (например, 9B) требуют значительного объема видеопамяти для высокопроизводительного инференса; «объем памяти» остается высоким, поскольку общее количество параметров все равно занимает пространство графического процессора.
-
Регулирование и локализация данных: Использование моделей от китайского провайдера может вызвать вопросы о локализации данных в определенных юрисдикциях, хотя открытая весовая версия по лицензии Apache 2.0 позволяет размещать их на «суверенных» локальных облаках.
Предприятиям следует уделять первоочередное внимание «проверяемым» задачам — таким как программирование, математика или следование инструкциям, — где результат может быть автоматически проверен по заранее определенным правилам во избежание «хакинга вознаграждения» или незаметных сбоев.




