


Новая открытая модель Qwen3.5 Medium от Alibaba обеспечивает производительность, близкую к Sonnet 4.5, на локальных компьютерах


Известная команда разработчиков искусственного интеллекта Qwen от компании Alibaba снова добилась успеха: чуть больше суток назад они выпустили серию средних моделей Qwen3.5, состоящую из четырех новых больших языковых моделей (LLM) с поддержкой агентного вызова инструментов. Три из них доступны для коммерческого использования предприятиями и независимыми разработчиками по стандартной открытой лицензии Apache 2.0:
-
Qwen3.5-35B-A3B
-
Qwen3.5-122B-A10B
-
Qwen3.5-27B
Разработчики могут скачать их прямо сейчас на Hugging Face и ModelScope. Четвертая модель, Qwen3.5-Flash, судя по всему, является проприетарной и доступна только через API Alibaba Cloud Model Studio, однако она по-прежнему предлагает серьезное преимущество в стоимости по сравнению с другими моделями на Западе (см. таблицу сравнения цен ниже).
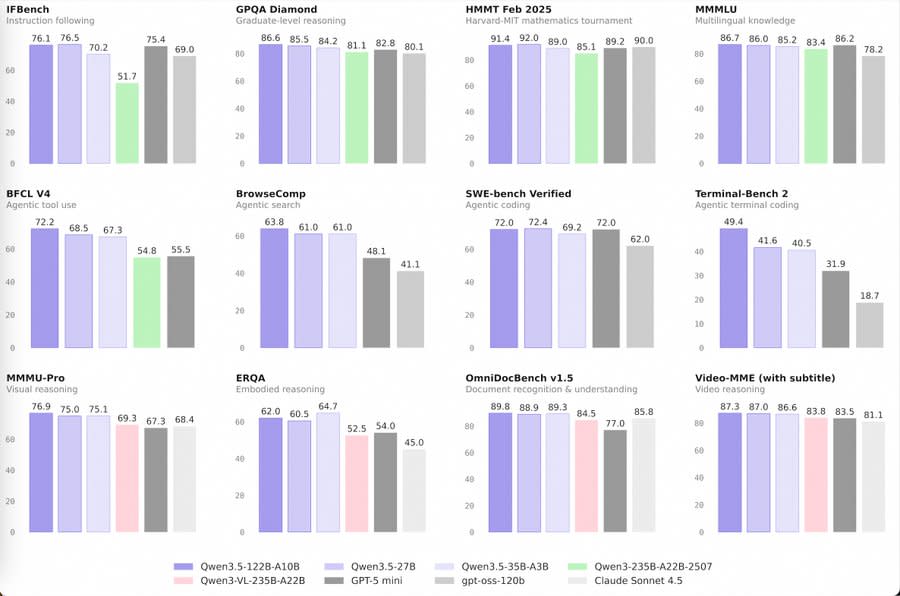
Главная неожиданность репортажа с открытым исходным кодом заключается в том, что эти модели демонстрируют сопоставимо высокую производительность в сторонних бенчмарках по сравнению с аналогичными по размеру проприетарными моделями от крупных американских стартапов, таких как OpenAI или Anthropic, фактически превосходя GPT-5-mini от OpenAI и Claude Sonnet 4.5 от Anthropic — последняя из которых была выпущена всего пять месяцев назад.
Кроме того, команда Qwen заявляет, что спроектировала эти модели так, чтобы они сохраняли высокую точность даже при «квантовании» — процессе, который дополнительно уменьшает их размер за счет сокращения количества значений, используемых для сохранения параметров модели.
Что еще более важно, этот релиз приносит контекстные окна «передового уровня» на настольные ПК. Флагманская модель Qwen3.5-35B-A3B теперь способна обрабатывать контекст длиной более 1 миллиона токенов на потребительских видеокартах с 32 ГБ видеопамяти. Хотя это доступно далеко не каждому, требования к вычислительным ресурсам здесь значительно ниже, чем у многих других сопоставимых по производительности вариантов.
Этот прорыв стал возможен благодаря практически безошибочной точности при 4-битных весах и квантовании кэша KV, что позволяет разработчикам обрабатывать огромные наборы данных без инфраструктуры серверного уровня.
Технологии: Силы Delta
В основе производительности Qwen 3.5 лежит сложная гибридная архитектура. В то время как многие модели полагаются исключительно на стандартные блоки Transformer, Qwen 3.5 объединяет сети Gated Delta Networks с разреженной системой « mixtures-of-experts» (MoE). Технические характеристики Qwen3.5-35B-A3B демонстрируют высокую эффективность дизайна:
-
Эффективность параметров: Хотя в общей сложности модель содержит 35 миллиардов параметров, для любого конкретного токена она задействует только 3 миллиарда.
-
Разнообразие экспертов: Слой MoE использует 256 экспертов, причем 8 маршрутизируемых экспертов и 1 общий эксперт помогают поддерживать производительность при одновременном снижении задержки инференса.
-
Практически безошибочное квантование: Серия сохраняет высокую точность даже при сжатии до 4-битных весов, что существенно снижает требования к объему памяти для локального развертывания.
-
Выпуск базовой модели: Стремясь поддержать исследовательское сообщество, Alibaba предоставила открытый доступ к базовой модели Qwen3.5-35B-A3B-Base наряду с версиями, настроенными под инструкции.
Продукт: Интеллект, который сначала «думает»
Qwen 3.5 в качестве состояния по умолчанию использует встроенный «режим размышления» (Thinking Mode). Перед выдачей окончательного ответа модель генерирует внутреннюю цепочку рассуждений, ограниченную тегами
-
Qwen3.5-27B: оптимизирована для высокой эффективности, поддерживает длину контекста более 800 тыс. токенов.
-
Qwen3.5-Flash: хостинговая версия промышленного уровня с длиной контекста по умолчанию в 1 миллион токенов и встроенными официальными инструментами.
-
Qwen3.5-122B-A10B: разработанная для графических процессоров серверного уровня (80 ГБ видеопамяти), эта модель поддерживает контекст длиной более 1 млн токенов, сокращая разрыв с крупнейшими в мире передовыми моделями.
Результаты бенчмарков подтверждают этот архитектурный сдвиг. Модель 35B-A3B заметно превосходит гораздо более крупных предшественников, таких как Qwen3-235B, а также упомянутые проприетарные GPT-5 mini и Sonnet 4.5 в таких категориях, как знания (MMMLU) и визуальное рассуждение (MMMU-Pro).
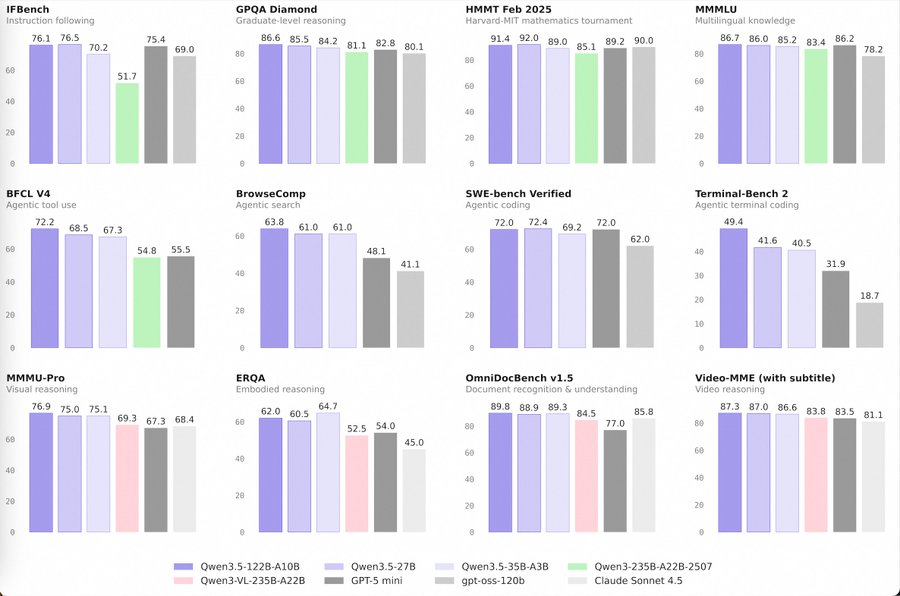
Сравнительная диаграмма бенчмарков средних моделей Alibaba Qwen3.5. Источник: Alibaba
Цены и интеграция API
Для тех, кто не размещает веса самостоятельно, Alibaba Cloud Model Studio предлагает конкурентоспособный API для модели Qwen3.5-Flash.
-
Входные данные: $0,1 за 1 млн токенов
-
Выходные данные: $0,4 за 1 млн токенов
-
Создание кэша: $0,125 за 1 млн токенов
-
Чтение из кэша: $0,01 за 1 млн токенов
API также отличается детализированной моделью ценообразования на вызовы инструментов: веб-поиск стоит $10 за 1 000 вызовов, а интерпретатор кода в настоящее время предоставляется бесплатно в течение ограниченного времени.
Благодаря этому Qwen3.5-Flash является одной из самых доступных по цене при работе через API среди всех основных LLM в мире. Ниже приведена таблица для сравнения:
|
Модель |
Входные данные |
Выходные данные |
Итоговая стоимость |
Источник |
|
Qwen 3 Turbo |
$0.05 |
$0.20 |
$0.25 |
|
|
Qwen3.5-Flash |
$0.10 |
$0.40 |
$0.50 |
|
|
deepseek-chat (V3.2-Exp) |
$0.28 |
$0.42 |
$0.70 |
|
|
deepseek-reasoner (V3.2-Exp) |
$0.28 |
$0.42 |
$0.70 |
|
|
Grok 4.1 Fast (reasoning) |
$0.20 |
$0.50 |
$0.70 |
|
|
Grok 4.1 Fast (non-reasoning) |
$0.20 |
$0.50 |
$0.70 |
|
|
MiniMax M2.5 |
$0.15 |
$1.20 |
$1.35 |
|
|
MiniMax M2.5-Lightning |
$0.30 |
$2.40 |
$2.70 |
|
|
Gemini 3 Flash Preview |
$0.50 |
$3.00 |
$3.50 |
|
|
Kimi-k2.5 |
$0.60 |
$3.00 |
$3.60 |
|
|
GLM-5 |
$1.00 |
$3.20 |
$4.20 |
|
|
ERNIE 5.0 |
$0.85 |
$3.40 |
$4.25 |
|
|
Claude Haiku 4.5 |
$1.00 |
$5.00 |
$6.00 |
|
|
Qwen3-Max (2026-01-23) |
$1.20 |
$6.00 |
$7.20 |
|
|
Gemini 3 Pro (≤200K) |
$2.00 |
$12.00 |
$14.00 |
|
|
GPT-5.2 |
$1.75 |
$14.00 |
$15.75 |
|
|
Claude Sonnet 4.5 |
$3.00 |
$15.00 |
$18.00 |
|
|
Gemini 3 Pro (>200K) |
$4.00 |
$18.00 |
$22.00 |
|
|
Claude Opus 4.6 |
$5.00 |
$25.00 |
$30.00 |
|
|
GPT-5.2 Pro |
$21.00 |
$168.00 |
$189.00 |
Что это значит для технических руководителей и лиц, принимающих решения в компаниях
С запуском средних моделей Qwen3.5 быстрая итерация и тонкая настройка, ранее доступные только хорошо финансируемым лабораториям, теперь открыты для локальной разработки во многих нетехнических компаниях, что фактически отделяет сложный искусственный интеллект от огромных капитальных затрат.
В масштабах всей организации эта архитектура меняет способы обработки и защиты данных. Возможность локального поглощения массивных хранилищ документов или часовых видеоматериалов позволяет проводить глубокий анализ на уровне компании без рисков для конфиденциальности при использовании сторонних API.
Запуская эти специализированные модели «Mixture-of-Experts» в рамках частного файрвола, организации могут сохранять суверенный контроль над своими данными, используя при этом встроенные режимы «мышления» и официальные возможности вызова инструментов для создания более надежных автономных агентов.
Первые пользователи на платформе Hugging Face высоко оценили способность модели «сокращать разрыв» в агентных сценариях, где раньше могли конкурировать только крупнейшие закрытые модели.
Этот сдвиг в сторону архитектурной эффективности в противовес чистому масштабу гарантирует, что интеграция ИИ останется экономичной, безопасной и достаточно гибкой, чтобы идти в ногу с меняющимися оперативными потребностями.




