


Google выпускает Gemma 4 на условиях лицензии Apache 2.0 — и это изменение лицензии может быть важнее бенчмарков


Последние два года предприятия, оценивающие модели с открытым весом, сталкивались со сложным выбором. Серия моделей Gemma от Google стабильно показывала высокую производительность, но ее пользовательская лицензия — с ограничениями на использование и условиями, которые Google могла изменить в любой момент — подталкивала многие команды к выбору Mistral или Qwen от Alibaba. Юридическая экспертиза добавляла сложностей. Специалисты по комплаенсу отмечали спорные моменты. И какой бы способной ни была Gemma 3, «открытость» со звездочкой — это не совсем открытость.
Gemma 4 полностью устраняет эти преграды. Новейшее семейство открытых моделей от Google DeepMind поставляется под стандартной лицензией Apache 2.0 — теми же мягкими условиями, которые используют Qwen, Mistral, Arcee и большая часть экосистемы моделей с открытым весом.
Никаких кастомных пунктов, никаких оговорок о «вредоносном использовании» (Harmful Use), требующих юридической интерпретации, никаких ограничений на распространение или коммерческое развертывание. Для корпоративных команд, которые ждали, когда Google начнет играть по тем же лицензионным правилам, что и остальной рынок, ожидание подошло к концу.
Тайминг примечателен. В то время как некоторые китайские лаборатории искусственного интеллекта (в первую очередь новейшие модели Qwen от Alibaba — Qwen3.5 Omni и Qwen 3.6 Plus) начали отходить от полностью открытых релизов своих новейших разработок, Google движется в противоположном направлении — открывая свой самый мощный релиз Gemma на сегодняшний день и прямо заявляя, что архитектура опирается на исследования ее коммерческой линейки Gemini 3.
Четыре модели, два уровня: от периферийных устройств до рабочей станции в рамках одного семейства
Gemma 4 выходит в виде четырех различных моделей, разделенных на два уровня развертывания. Уровень «рабочих станций» включает в себя плотную модель с 31 млрд параметров (31B) и модель «Михель-оф-Эксперт» (MoE) с 26 млрд параметров и активными 4 млрд (26B A4B) — обе поддерживают ввод текста и изображений с окном контекста в 256 тыс. токенов. «Периферийный» уровень (edge) состоит из E2B и E4B — компактных моделей, разработанных для телефонов, встраиваемых устройств и ноутбуков, поддерживающих текст, изображения и аудио с окном контекста в 128 тыс. токенов.
В соглашении об именовании стоит разобраться. Префикс «E» обозначает «эффективные параметры»: модель E2B имеет 2,3 миллиарда эффективных параметров, но 5,1 миллиарда общих, поскольку каждый слой декодера несет собственную небольшую таблицу встраивания (эмбеддингов) с помощью метода, который Google называет Per-Layer Embeddings (PLE). Эти таблицы занимают много места на диске, но дешевы в вычислениях, поэтому модель работает как модель с 2 млрд параметров, технически веся больше.
Буква «А» в обозначении 26B A4B расшифровывается как «активные параметры» (active parameters) — только 3,8 миллиарда из 25,2 миллиарда общих параметров MoE-модели активируются во время инференса (вывода), что означает уровень интеллекта класса 26B при вычислительных затратах, сопоставимых с моделью на 4B.
Для IT-руководителей, рассчитывающих требования к графическим процессорам (GPU), это напрямую трансформируется в гибкость развертывания. MoE-модель может работать на потребительских GPU и должна быстро появиться в таких инструментах, как Ollama и LM Studio. Плотная модель на 31B требует больше ресурсов — например, NVIDIA H100 или RTX 6000 Pro для неквантованной генерации, но Google также выпускает контрольные точки с поддержкой квантования (Quantization-Aware Training, QAT) для поддержания качества при меньшей точности. В Google Cloud обе модели для рабочих станций теперь могут работать в полностью бессерверной конфигурации через Cloud Run с графическими процессорами NVIDIA RTX Pro 6000, переходя в спящий режим при простаивании.
Ставка на MoE: 128 маленьких экспертов для экономии на затратах на инференс
Архитектурные решения внутри модели 26B A4B заслуживают особого внимания команд, оценивающих экономику инференса. Вместо того чтобы следовать шаблону недавних крупных MoE-моделей, использующих горстку крупных экспертов, Google остановился на 128 маленьких экспертах, активируя восемь на каждый токен плюс одного постоянного общего эксперта. В результате получается модель, которая конкурирует по бенчмаркам с плотными моделями в диапазоне 27B–31B, работая при этом примерно со скоростью модели на 4B во время инференса.
Это не просто курьез для бенчмарков — это напрямую влияет на стоимость обслуживания. Модель, обеспечивающая рассуждения уровня 27B при пропускной способности уровня 4B, означает меньше GPU, меньшую задержку и более дешевый инференс на токен в продакшене. Для организаций, использующих помощников по написанию кода, конвейеры обработки документов или многошаговые агентские рабочие процессы, вариант MoE может стать самым практичным выбором в семействе.
Обе модели для рабочих станций используют механизм гибридного внимания (hybrid attention), который чередует локальное скользящее внимание с полным глобальным вниманием, причем последний слой всегда является глобальным. Такая конструкция обеспечивает окно контекста в 256K при сохранении управляемого потребления памяти — важный фактор для команд, обрабатывающих длинные документы, кодовые базы или многошаговые разговоры с агентами.
Встроенная мультимодальность: зрение, аудио и вызов функций с нуля
Предыдущие поколения открытых моделей обычно рассматривали мультимодальность как дополнение. Визуальные энкодеры прикреплялись к текстовым основам. Аудио требовало внешнего конвейера автоматического распознавания речи (ASR), такого как Whisper. Вызов функций (function calling) опирался на инжиниринг промптов и надежду на то, что модель будет сотрудничать. Gemma 4 объединяет все эти возможности на архитектурном уровне.
Все четыре модели обрабатывают ввод изображений с переменным соотношением сторон с настраиваемыми бюджетами визуальных токенов — значительное улучшение по сравнению со старым визуальным энкодером Gemma 3n, который испытывал трудности с OCR (распознаванием текста) и пониманием документов. Новый энкодер поддерживает бюджеты от 70 до 1 120 токенов на изображение, позволяя разработчикам балансировать между детализацией и вычислениями в зависимости от задачи.
Низкие бюджеты подходят для классификации и создания подписей; более высокие — для распознавания текста, разбора документов и детального визуального анализа. Ввод нескольких изображений и видео (обрабатываемых как последовательности кадров) поддерживается нативно, обеспечивая визуальные рассуждения по нескольким документам или скриншотам.
Две периферийные модели добавляют нативную обработку аудио — автоматическое распознавание речи и перевод речи в текст, и всё это прямо на устройстве. Аудиоэнкодер был сжат до 305 миллионов параметров по сравнению с 681 миллионом в Gemma 3n, в то время как длительность кадра уменьшилась со 160 мс до 40 мс для более быстрой транскрипции. Для команд, создающих голосовые приложения, которым необходимо хранить данные локально (например, в здравоохранении, выездном обслуживании или многоязычном взаимодействии с клиентами), запуск ASR, перевода, рассуждений и вызова функций в рамках одной модели на телефоне или периферийном устройстве является подлинным архитектурным упрощением.
Вызов функций также встроен по умолчанию во все четыре модели, основываясь на разработках из релиза FunctionGemma от Google конца прошлого года. В отличие от предыдущих подходов, которые полагались на следование инструкциям для принуждения моделей к структурированному использованию инструментов, вызов функций в Gemma 4 был заложен в модель с самого начала и оптимизирован для многошаговых агентских сценариев с несколькими инструментами. Это проявляется в агентских бенчмарках, но, что более важно, снижает нагрузку на инжиниринг промптов, которую обычно несут корпоративные команды при создании агентов, использующих инструменты.
Бенчмарки в контексте: какое место занимает Gemma 4 в переполненном поле
Цифры бенчмарков четко рассказывают историю поколенческого прогресса. Плотная модель с 31 млрд параметров набирает 89,2% в AIME 2026 (строгий тест на математические рассуждения), 80,0% в LiveCodeBench v6 и достигает рейтинга Эло на Codeforces в 2 150 — показатели, которые еще недавно соответствовали передовому уровню проприетарных моделей. В сфере работы с изображениями MMMU Pro достигает 76,9%, а MATH-Vision — 85,6%.
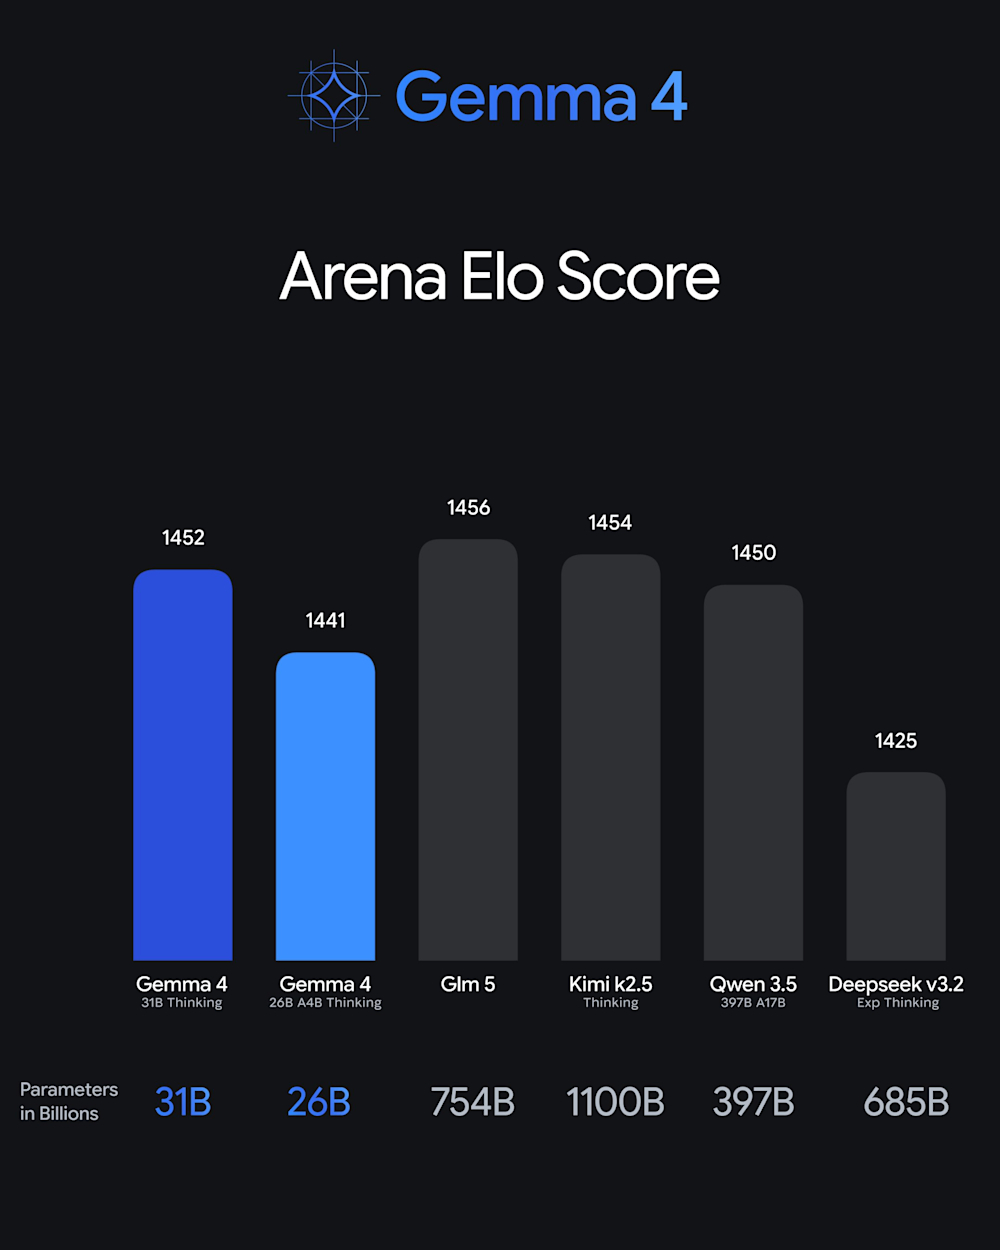
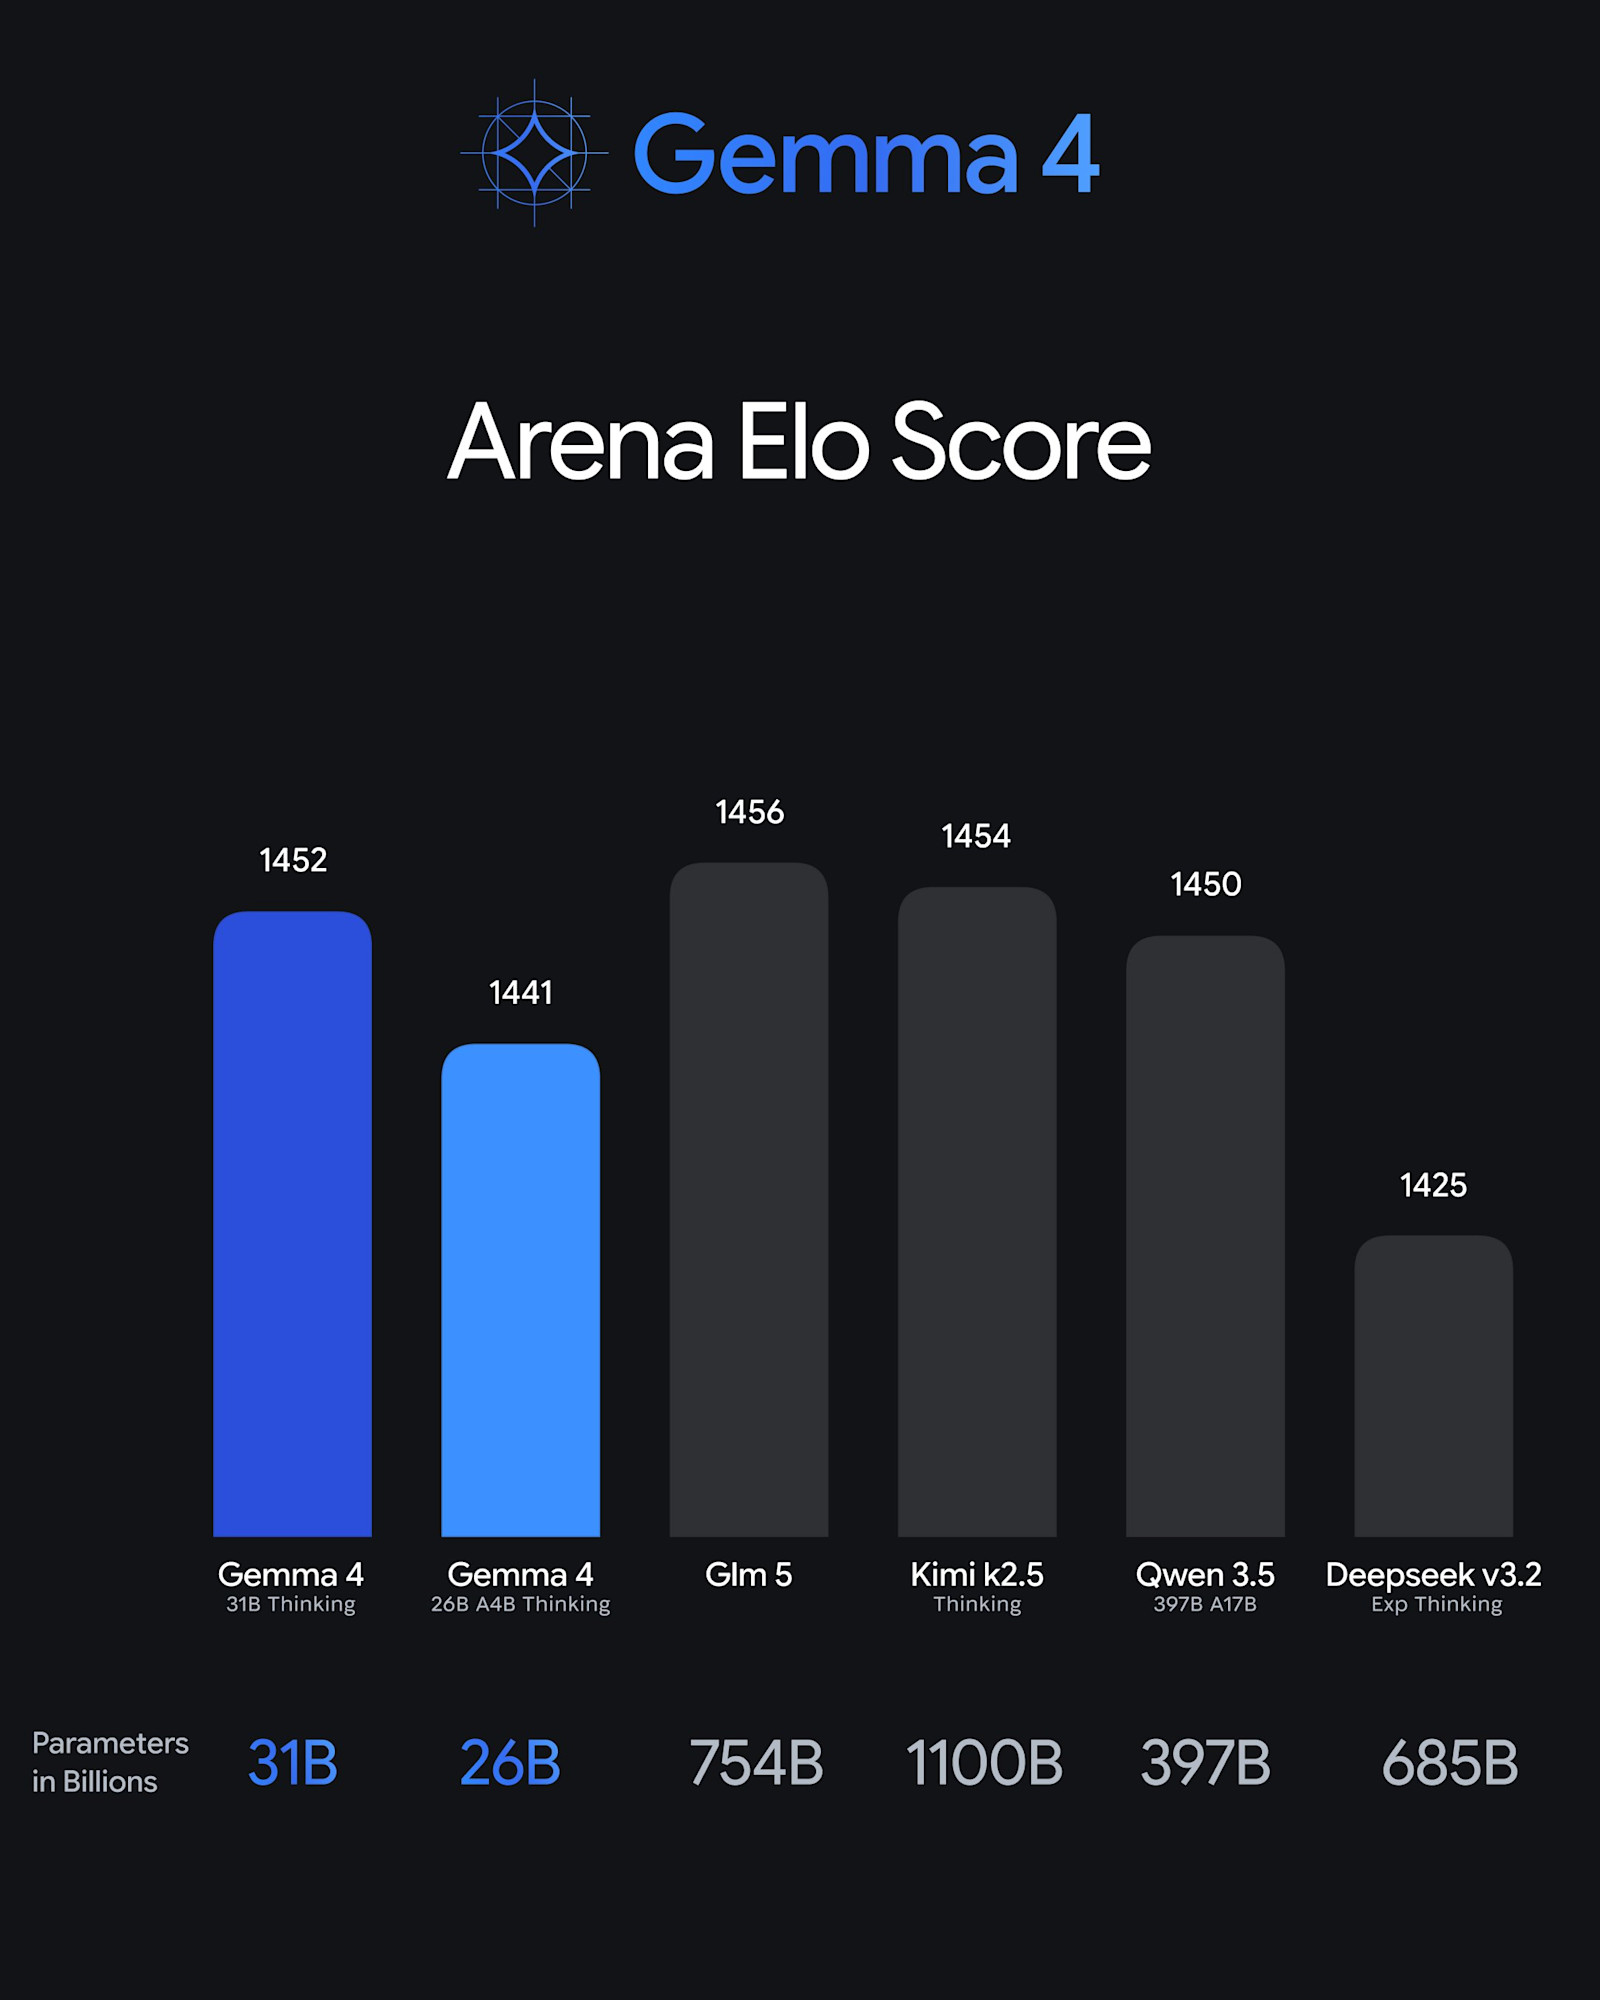
Диаграмма бенчмарка оценок Эло Google Gemma 4. Источник: Google
Для сравнения, Gemma 3 27B набрала 20,8% в AIME и 29,1% в LiveCodeBench без режима размышлений.
Модель MoE идет близко: 88,3% в AIME 2026, 77,1% в LiveCodeBench и 82.3% в GPQA Diamond — бенчмарке научных рассуждений уровня аспирантуры. Разрыв в производительности между MoE и плотной вариантами невелик, учитывая значительное преимущество архитектуры MoE в стоимости инференса.
Периферийные модели превосходят свой весовой класс. Модель E4B набирает 42,5% в AIME 2026 и 52,0% в LiveCodeBench — мощно для модели, работающей на GPU T4. E2B, будучи еще меньше, показывает соответственно 37,5% и 44,0%. Обе модели значительно превосходят Gemma 3 27B (без режима размышлений) в большинстве бенчмарков, несмотря на то, что составляют лишь малую часть ее размера, благодаря встроенной возможности рассуждения.
Эти цифры необходимо оценивать в условиях все более конкурентного ландшафта открытых весов. Qwen 3.5, GLM-5 и Kimi K2.5 агрессивно конкурируют в этом диапазоне параметров, и рынок движется быстро. Что отличает Gemma 4, так это не столько какой-то отдельный бенчмарк, сколько их комбинация: сильные рассуждения, нативная мультимодальность для текста, зрения и аудио, вызов функций, контекст 256K и по-настоящему мягкая лицензия — и всё это в едином семействе моделей с возможностями развертывания от периферийных устройств до бессерверного облака.
За чем корпоративным командам стоит следить дальше
Google выпускает как предобученные базовые модели, так и варианты с инструктивной настройкой (instruction-tuned), что важно для организаций, планирующих дообучение под конкретные домены. Базовые модели Gemma исторически были надежной основой для кастомного обучения, а лицензия Apache 2.0 теперь снимает любые сомнения по поводу того, можно ли коммерчески развертывать производные дообученные версии.
Бессерверный вариант развертывания через Cloud Run с поддержкой GPU заслуживает внимания команд, которым необходима емкость инференса, масштабируемая до нуля. Оплата только за реальные вычисления во время инференса — вместо поддержания постоянно работающих экземпляров GPU — может существенно изменить экономику развертывания открытых моделей в продакшене, особенно для внутренних инструментов и приложений с низким трафиком.
Google намекнула, что это может быть неполное семейство Gemma 4, и в дальнейшем, вероятно, появятся дополнительные размеры моделей. Но комбинация, доступная сегодня — модели рассуждений класса рабочих станций и мультимодальные модели периферийного класса, все под Apache 2.0, все опирающиеся на исследования Gemini 3 — представляет собой самый полный релиз открытой модели, когда-либо выпускавшийся Google. Для корпоративных команд, которые ждали, когда открытые модели Google начнут конкурировать как по условиям лицензирования, так и по производительности, оценка наконец-то может начаться без предварительного звонка юристам.




