


Новая модель с открытым исходным кодом Trinity-Large-Thinking от Arcee — это редкая и мощная ИИ-модель американского производства, которую предприятия могут скачивать и настраивать


За годы, прошедшие с момента дебюта ChatGPT в конце 2022 года, эстафета создания моделей с открытым исходным кодом переходила из рук в руки между несколькими компаниями — от Meta и ее семейств Llama до китайских лабораторий вроде Qwen и z.ai. Однако в последнее время китайские компании начали возвращаться к проприетарным моделям. В то же время американские лаборатории, такие как Cursor и Nvidia, выпускают собственные варианты китайских моделей, что ставит под вопрос будущее этого технологического направления.
Один из ответов: Arcee, базирующаяся в Сан-Франциско лаборатория, которая на этой неделе представила ИИ Trinity-Large-Thinking — текстовую модель для рассуждений с 399 миллиардами параметров, выпущенную под бескомпромиссной открытой лицензией Apache 2.0. Это обеспечивает полную кастомизацию и коммерческое использование кем угодно — от инди-разработчиков до крупных корпораций.
Этот релиз — больше, чем просто новый набор весов в сообществе разработчиков ИИ-кода Hugging Face. Это стратегическая ставка на то, что «американские открытые веса» смогут стать суверенной альтернативой все более закрытым или ограниченным передовым моделям 2025 года.
Этот шаг происходит как раз в тот момент, когда предприятия выражают все большую обеспокоенность по поводу зависимости от архитектур китайской разработки для критически важной инфраструктуры, создавая спрос на отечественного лидера, которым Arcee намерена стать.
Как написал Клеман Деланг (Clément Delangue), соучредитель и генеральный директор Hugging Face, в личных сообщениях на X: «Силой США всегда были их стартапы, так что, возможно, именно на них нам стоит рассчитывать в плане лидерства в сфере ИИ с открытым исходным кодом. Arcee доказывает, что это возможно!»
Зарождение передовой лаборатории из 30 человек
Чтобы понять значимость релиза Trinity, необходимо понять саму создавшую ее лабораторию. Штаб-квартира Arcee AI находится в Сан-Франциско, а команда насчитывает всего 30 человек.
В то время как конкуренты вроде OpenAI и Google работают с тысячами инженеров и многомиллиардными бюджетами на вычисления, Arcee определяет себя через то, что технический директор Лукас Аткинс (Lucas Atkins) называет «инженерией в условиях ограничений».
Компания впервые привлекла к себе внимание в 2024 году после получения 24 миллионов долларов в рамках раунда Серии А под руководством Emergence Capital, в результате чего общий объем привлеченного капитала составил чуть менее 50 миллионов долларов. В начале 2026 года команда пошла на огромный риск: они выделили 20 миллионов долларов — почти половину всего финансирования — на единственный 33-дневный цикл обучения Trinity Large.
Используя кластер из 2048 графических процессоров NVIDIA B300 Blackwell, обеспечивавших вдвое большую скорость по сравнению с предыдущим поколением Hopper, Arcee поставила будущее компании на карту в расчете на то, что разработчикам необходима передовая модель, которой они смогут по-настоящему владеть.
Эта ставка «на все» стала мастер-классом по эффективности использования капитала, доказав, что небольшая сфокусированная команда способна развернуть полный конвейер и стабилизировать обучение без бесконечных резервов.
Инженерия в условиях жестких архитектурных ограничений
Trinity-Large-Thinking примечательна крайней разреженностью (sparsity) своего механизма внимания. Хотя модель содержит в общей сложности 400 миллиардов параметров, ее архитектура «смеси экспертов» (Mixture-of-Experts) означает, что для каждого конкретного токена активно лишь 1,56% (или 13 миллиардов) параметров.
Это позволяет модели обладать глубокими знаниями массивной системы, сохраняя при этом скорость инференса и операционную эффективность гораздо меньшей модели — она работает примерно в 2–3 раза быстрее своих аналогов на том же «железе». Обучение столь разреженной модели сопряжено со значительными трудностями в обеспечении стабильности.
Чтобы предотвратить ситуацию, когда несколько экспертов становятся «победителями», в то время как остальные остаются необученным «мертвым грузом», Arcee разработала метод SMEBU (Soft-clamped Momentum Expert Bias Updates).
Этот механизм гарантирует специализацию экспертов и их равномерное распределение по общему веб-корпусу. Архитектура также включает в себя гибридный подход, чередующий слои локального и глобального скользящего внимания в соотношении 3:1 для поддержания производительности в сценариях с длинным контекстом.
Программа данных и синтетические рассуждения
Партнерство Arcee с другим стартапом DatologyAI обеспечило обучающую программу объемом более 10 триллионов отобранных токенов. Тем не менее, корпус для обучения полномасштабной модели был расширен до 20 триллионов токенов, разделенных поровну между отфильтрованными веб-данными и высококачественными синтетическими данными.
В отличие от типичных синтетических данных на основе имитации, где меньшая модель просто учится подражать более крупной, DatologyAI использовала методы синтетического переписывания сырого веб-текста (например, статей Википедии или блогов) для сжатия информации.
Этот процесс помог модели научиться рассуждать о концепциях и информации, а не просто заучивать точные строки токенов.
Для обеспечения соответствия нормативным требованиям огромные усилия были направлены на исключение защищенных авторским правом книг и материалов с неясным лицензированием, что привлекает корпоративных клиентов, опасающихся рисков, связанных с интеллектуальной собственностью мейнстримных LLM.
Такой подход, основанный на данных, позволил модели масштабироваться без ущерба для чистоты и значительно улучшить производительность при выполнении сложных задач, таких как математические вычисления и многоэтапное использование агентированных инструментов.
Переход от болтливых чат-ботов к агентам-рассуждателям
Определяющей характеристикой этого официального релиза стал переход от стандартной инструкции (instruct-модели) к модели рассуждений (reasoning-модели).
Реализовав фазу «размышления» (thinking) перед генерацией ответа — аналогично внутренним циклам в более ранней Trinity-Mini, — Arcee ответила на главную критику своего январского предварительного (Preview) релиза.
Ранние пользователи предварительной модели отмечали, что она иногда испытывала трудности с многошаговыми инструкциями в сложных средах и могла «разочаровывать» при решении агентских задач.
Обновление «Thinking» эффективно стирает этот разрыв, обеспечивая создание того, что Arcee называет «агентами с долгосрочным планированием» (long-horizon agents), которые способны поддерживать согласованность при многошаговых вызовах инструментов без потери качества.
Этот процесс рассуждения обеспечивает лучшую контекстную когерентность и более точное следование инструкциям в условиях ограничений. Это имеет прямые последствия для Maestro Reasoning — производной модели Trinity на 32B параметров, которая уже используется в ориентированных на аудит отраслях для обеспечения прозрачных трассировок «от мысли к ответу».
Цель состояла в том, чтобы уйти от «болтливых» или неэффективных чат-ботов к надежным, недорогим и высококачественным агентам, сохраняющим стабильность в долгосрочных циклах.
Геополитика и аргументы в пользу американских открытых весов
Значимость приверженности Arcee лицензии Apache 2.0 усиливается уходом ее основных конкурентов с рынка моделей с открытыми весами.
В течение 2025 года китайские исследовательские лаборатории, такие как Qwen от Alibaba и z.ai (она же Zhupai), задавали темп в разработке высокоэффективных MoE-архитектур.
Однако по мере вступления в 2026 год эти лаборатории начали переориентироваться на проприетарные корпоративные платформы и специализированные подписки, демонстрируя отход от чистого развития сообщества.
Фрагментация некогда плодовитых команд — например, уход ключевых техлидов из лаборатории Qwen компании Alibaba — оставила пустоту в высшем сегменте рынка открытых весов. В США это движение столкнулось с собственным кризисом.
Подразделение Meta Llama заметно отступило с позиций на передовой после неоднозначной реакции на Llama 4 в апреле 2025 года, когда сообщалось о проблелях с качеством и манипуляциях с бенчмарками.
Для разработчиков, полагавшихся на эпоху доминирования Llama 3, отсутствие актуальной открытой модели на 400B+ параметров создало острую потребность в альтернативе, которую и восполнила Arcee.
Бенчмарки и сравнение Trinity-Large-Thinking от Arcee с другими американскими передовыми ИИ-моделями с открытым исходным кодом
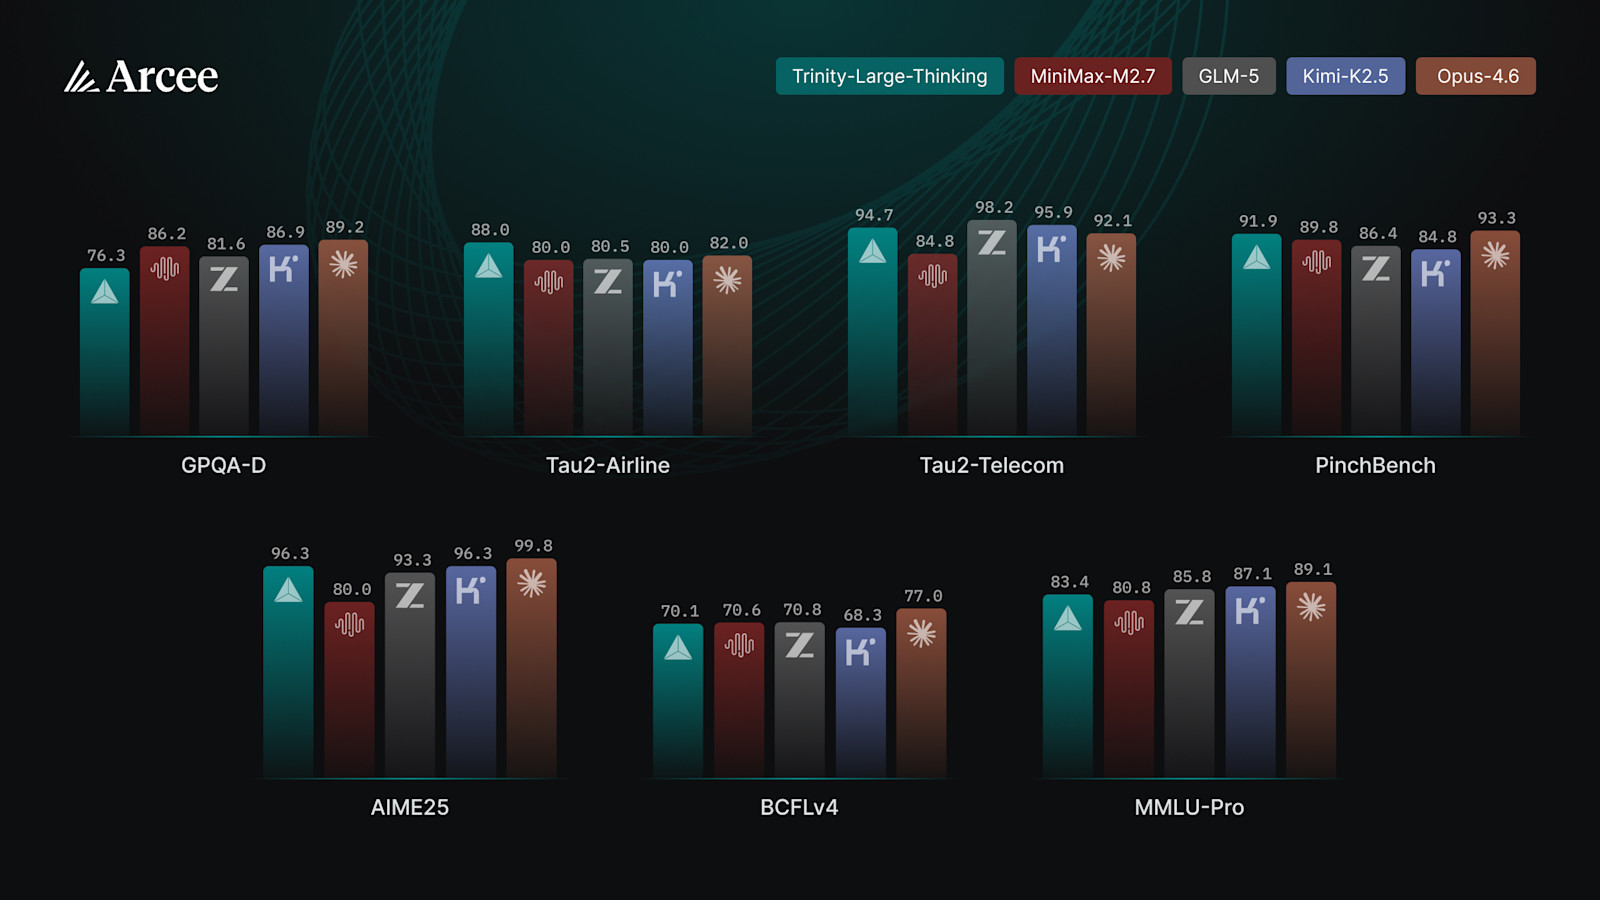
Показатели Trinity-Large-Thinking в тестах, ориентированных на агентов, подтверждают ее статус полноценного конкурента на передовой. В бенчмарке PinchBench, являющемся критически важной метрикой для оценки возможностей моделей в автономных агентских задачах, Trinity набрала 91,9 балла, расположившись сразу за проприетарным лидером рынка Claude Opus 4.6 (93.3).
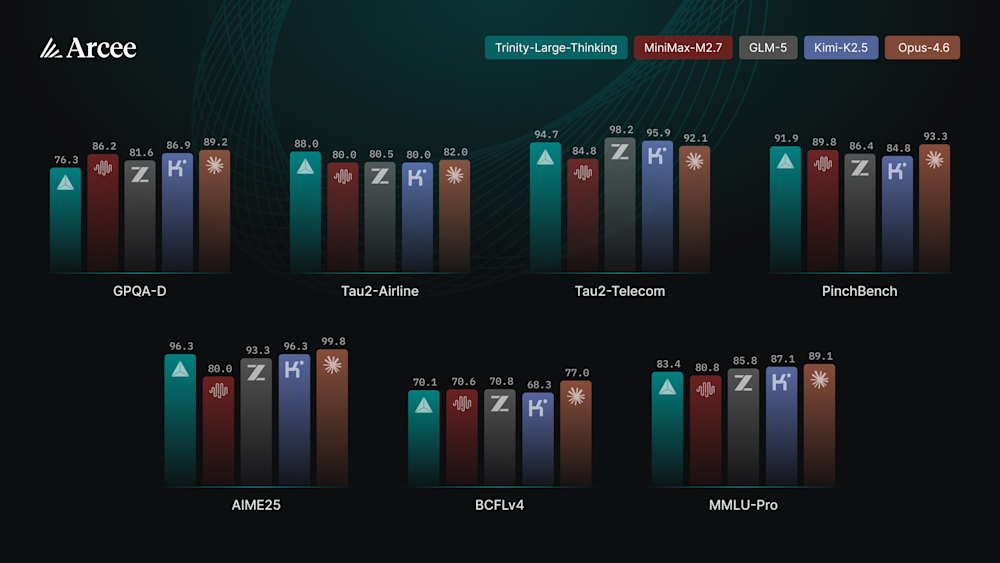
Сравнительная диаграмма бенчмарков Arcee Trinity-Large-Thinking. Источник: Arcee
Эта конкурентоспособность отражена и в IFBench, где результат Trinity в 52,3 балла находится в непосредственной близости от 53,1 балла Opus 4.6. Это указывает на то, что ориентированное на рассуждения обновление «Thinking» успешно справилось с препятствиями в следовании инструкциям, которые наблюдались у более ранней превью-версии модели.
Широкие возможности модели в области технических рассуждений также выводят ее в высший эшелон текущего рынка открытого исходного кода. Она зафиксировала результат 96.3 в AIME25, сравнявшись с высокоуровневой Kimi-K2.5 и опередив других крупных конкурентов, таких как GLM-5 (93.3) и MiniMax-M2.7 (80.0).
Хотя в сложных бенчмарках по кодированию, таких как SWE-bench Verified, по-прежнему лидируют лучшие закрытые модели (Trinity набирает 63.2 против 75.6 у Opus 4.6), колоссальная разница в стоимости за токен позиционирует Trinity как более жизнеспособный уровень суверенной инфраструктуры для предприятий, стремящихся развернуть эти возможности в продакшене.
Что касается других предложений США среди передовых моделей с открытым исходным кодом, то gpt-oss от OpenAI достигает максимума в 120 миллиардов параметров. Кроме того, стоит упомянуть Google с семейством Gemma (Gemma 4 была выпущена на этой неделе) и семейство Granite от IBM, несмотря на их более низкие показатели в бенчмарках. Семейство Nemotron от Nvidia также заслуживает внимания, но представляет собой дообученные и прошедшие посттренировку варианты Qwen.
|
Бенчмарк |
Arcee Trinity-Large |
gpt-oss-120B (High) |
IBM Granite 4.0 |
Google Gemma 4 |
|
GPQA-D |
76.3% |
80.1% |
74.8% |
84.3% |
|
Tau2-Airline |
88.0% |
65.8%* |
68.3% |
76.9% |
|
PinchBench |
91.9% |
69.0% (IFBench) |
89.1% |
93.3% |
|
AIME25 |
96.3% |
97.9% |
88.5% |
89.2% |
|
MMLU-Pro |
83.4% |
90.0% (MMLU) |
81.2% |
85.2% |
Так как же предприятию сделать выбор среди всего этого многообразия?
Arcee Trinity-Large-Thinking — лучший выбор для организаций, создающих автономных агентов. Ее разреженная архитектура на 400B превосходно справляется с «размышлениями» над многошаговой логикой, сложной математикой и долгосрочным использованием инструментов. Активируя лишь часть своих параметров, она предоставляет высокоскоростной движок рассуждений для разработчиков, которым требуются возможности планирования уровня GPT-4o в рамках экономичного фреймворка с открытым исходным кодом.
С другой стороны, gpt-oss-120B служит оптимальной золотой серединой для предприятий, которым требуется высокая производительность рассуждений, но в приоритете стоят более низкие эксплуатационные расходы и гибкость развертывания.
Поскольку модель задействует всего 5,1 миллиарда параметров за один проход вперед, она идеально подходит для таких технических задач, как генерация соревновательного кода и продвинутое математическое моделирование, которые должны выполняться на ограниченном оборудовании, например, на одном графическом процессоре H100.
Ее настраиваемый уровень рассуждений (с режимами «Low», «Medium» и «High») делает ее лучшим выбором для производственных сред, где задержка и точность должны динамически балансироваться в зависимости от различных задач.
Для более масштабных высокопроизводительных приложений основные роли играют Google Gemma 4 и IBM Granite 4.0. Gemma 4 предлагает наибольшую «плотность интеллекта» для общих знаний и научной точности, что делает ее самым универсальным вариантом для R&D и высокоскоростных интерфейсов чата.
В то же время IBM Granite 4.0 создана для «круглосуточных» корпоративных нагрузок. Она использует гибридную архитектуру, которая устраняет узкие места контекста при обработке массивных документов. Для компаний, озабоченных соблюдением юридических норм и эффективностью оборудования, Granite остается самым надежным фундаментом для масштабных систем RAG и анализа документов.
Владение как функция для регулируемых отраслей
В сложившейся обстановке выбор лицензии Apache 2.0 компанией Arcee является осознанным шагом для дифференциации. В отличие от ограничительных лицензий сообщества, используемых некоторыми конкурентами, Apache 2.0 позволяет предприятиям по-настоящему владеть своим стеком интеллекта без «черноящичных» предвзятостей чат-бота общего назначения.
«Разработчикам и предприятиям нужны модели, которые они могут изучать, дообучать, размещать, дистиллировать и которыми они могут владеть», — отметил Лукас Аткинс в анонсе релиза.
Это владение критически важно в контексте «горького урока» обучения небольших моделей: обычно сначала необходимо обучить массивную передовую модель, чтобы сгенерировать высококачественные синтетические данные и логиты, необходимые для создания эффективных дочерних моделей.
Кроме того, Arcee выпустила Trinity-Large-TrueBase — сырую контрольную точку размером 10 триллионов токенов. TrueBase предоставляет редкий «неиспорченный» взгляд на фундаментальный интеллект до применения настройки инструкций и обучения с подкреплением. Для исследователей в строго регулируемых отраслях, таких как финансы и оборона, TrueBase открывает возможности для аутентичных аудитов и пользовательского выравнивания (alignment) с чистого листа.
Вердикт сообщества и будущее дистилляции
Реакция со стороны сообщества разработчиков оказалась в целом положительной, отражая стремление к созданию моделей американского производства с большим количеством открытых весов.
В сети X исследователи отмечали революционный характер релиза, подчеркивая, что «безумно низкие» цены для модели такого размера станут благом для сообщества разработчиков агентов.
На платформе инференса открытых ИИ-моделей OpenRouter Trinity-Large-Preview закрепилась в качестве открытой модели №1 по использованию в США, обработав более 80,6 миллиарда токенов в пиковые дни, такие как 1 марта 2026 года.
Близость результатов Trinity-Large-Thinking и Claude Opus 4.6 в PinchBench (91.9 против 93.3) выглядит особенно поразительно на фоне стоимости. При цене в 0,90 доллара за миллион выходных токенов Trinity примерно на 96% дешевле Opus 4.6, которая стоит 25 долларов за миллион выходных токенов.
Стратегия Arcee теперь сосредоточена на переносе этих уроков предварительного и пост-обучения вниз по стеку. Большая часть работы, вложенная в Trinity Large, теперь перекочует в модели Mini и Nano, обновляя линейку компактных решений компании за счет дистилляции рассуждений передового уровня.
В то время как глобальные лаборатории переориентируются на проприетарную изоляцию, Arcee позиционирует Trinity как суверенный уровень инфраструктуры, который разработчики наконец смогут контролировать и адаптировать для долгосрочных агентских воркфлоу.




