


Открытые ИИ-модели IBM Granite 4.0 Nano могут работать локально прямо в вашем браузере


В индустрии, где размер модели часто считается мерилом ее интеллекта, IBM выбирает иной путь — путь, в котором ценятся эффективность, а не гигантомания, и доступность, а не абстракция.
114-летний технологический гигант выпустил сегодня четыре новые модели Granite 4.0 Nano, количество параметров в которых варьируется от 350 миллионов до 1,5 миллиарда. Это лишь малая доля от размеров серверных аналогов от таких компаний, как OpenAI, Anthropic и Google.
Эти модели созданы максимально доступными: версии на 350M могут комфортно работать на ЦП современного ноутбука с 8–16 ГБ оперативной памяти, в то время как моделям на 1,5B для плавной работы обычно требуется графический процессор (GPU) как минимум с 6–8 ГБ видеопамяти — либо достаточное количество системной памяти и файл подкачки для инференса только на ЦП. Это делает их отличным выбором для разработчиков, создающих приложения на потребительском «железе» или на периферии (edge), без необходимости полагаться на облачные вычисления.
Фактически, самые маленькие из них могут работать локально прямо в вашем веб-браузере, как написал в социальной сети X Джошуа Лохнер (Joshua Lochner), известный как Xenova, создатель Transformer.js и инженер по машинному обучению в Hugging Face.
Все модели Granite 4.0 Nano выпускаются под лицензией Apache 2.0 — они идеально подходят для исследователей, корпоративных и независимых разработчиков, в том числе для коммерческого использования.
Они обладают нативной совместимостью с llama.cpp, vLLM и MLX, а также сертифицированы по стандарту ISO 42001 для разработки ответственного ИИ — стандарту, в создании которого пионером выступала IBM.
Но в данном случае малый размер не означает меньшие возможности — скорее, это признак более умного проектирования.
Эти компактные модели созданы не для дата-центров, а для периферийных устройств, ноутбуков и локального инференса, где вычислительные ресурсы ограничены, а задержка имеет критическое значение.
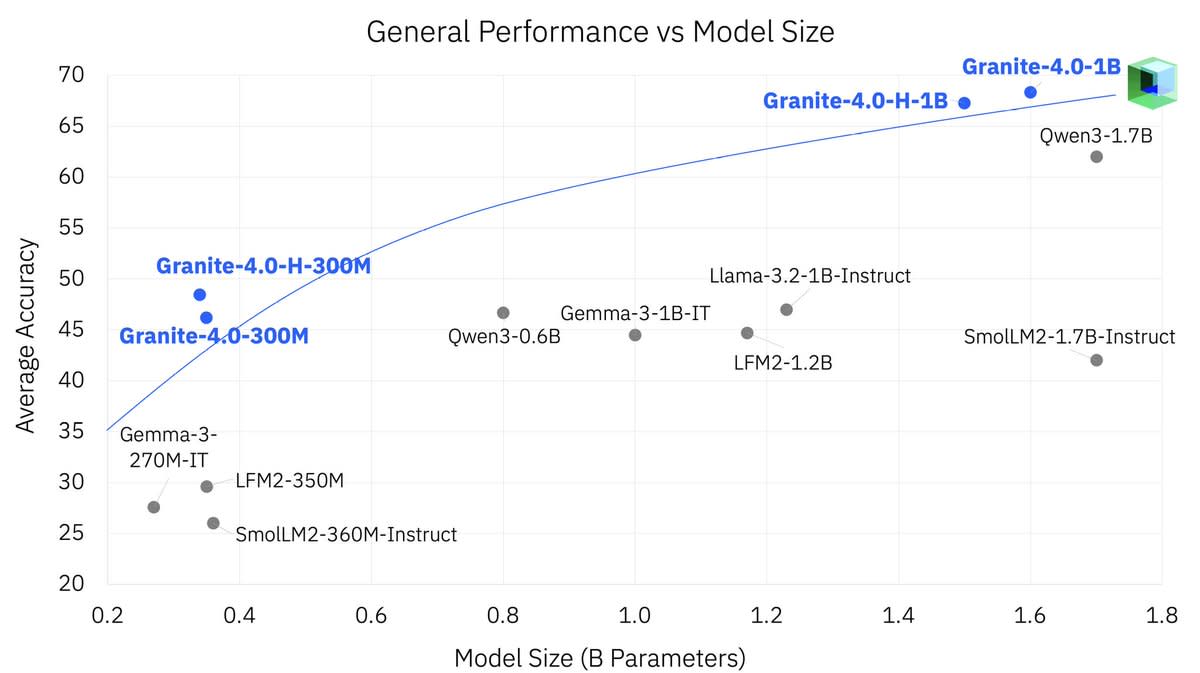
И несмотря на свой скромный размер, модели Nano показывают результаты в бенчмарках, которые соперничают с производительностью более крупных моделей из той же категории или даже превосходят их.
Этот релиз сигнализирует о стремительном формировании нового рубежа в сфере ИИ, где доминируют не гигантские масштабы, а стратегическое масштабирование.
Что именно выпустила IBM?
Семейство Granite 4.0 Nano включает четыре модели с открытым исходным кодом, которые теперь доступны на платформе Hugging Face:
-
Granite-4.0-H-1B (~1,5 млрд параметров) — гибридная архитектура SSM
-
Granite-4.0-H-350M (~350 млн параметров) — гибридная архитектура SSM
-
Granite-4.0-1B — вариант на базе трансформера, количество параметров ближе к 2B
-
Granite-4.0-350M — вариант на базе трансформера
Модели H-серии — Granite-4.0-H-1B и H-350M — используют гибридную архитектуру пространств состояний (SSM), которая сочетает в себе эффективность и высокую производительность, что идеально подходит для периферийных сред с низкими задержками.
В то время как стандартные варианты на основе трансформеров — Granite-4.0-1B и 350M — предлагают более широкую совместимость с такими инструментами, как llama.cpp, и предназначены для сценариев, где гибридная архитектура пока не поддерживается.
На практике трансформерная модель 1B ближе к параметрам 2B, но по производительности сопоставима со своим гибридным аналогом, предоставляя разработчикам гибкость с учетом их ограничений во время выполнения.
«Гибридный вариант — это полноценная модель на 1B. Однако негибридный вариант ближе к 2B, но мы решили сохранить название в соответствии с гибридным вариантом, чтобы связь между ними была более очевидной», — пояснила Эмма (Emma), руководитель отдела продуктового маркетинга Granite, во время сессии «Задайте мне вопрос» (AMA) на Reddit в сообществе r/LocalLLaMA.
Конкурентоспособный класс компактных моделей
IBM выходит на переполненный и быстро развивающийся рынок малых языковых моделей (SLMs), составляя конкуренцию таким решениям, как Qwen3, Gemma от Google, LFM2 от LiquidAI и даже плотным моделям от Mistral в категории до 2 миллиардов параметров.
В то время как OpenAI и Anthropic фокусируются на моделях, требующих кластеров GPU и сложной оптимизации инференса, семейство Nano от IBM нацелено непосредственно на разработчиков, которые хотят запускать производительные LLM на локальном или ограниченном «железе».
В ходе бенчмарк-тестирования новые модели IBM стабильно занимают лидирующие позиции в своем классе. Согласно данным, опубликованным в сети X Дэвидом Коксом (David Cox), вице-президентом по моделям ИИ в IBM Research:
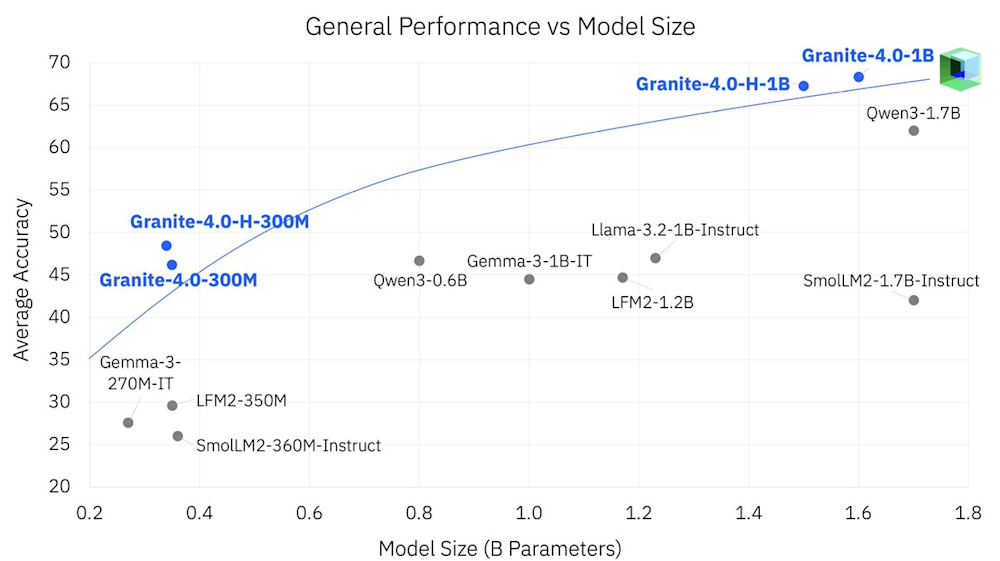
Бенчмарки производительности моделей Granite 4.0 Nano от IBM, опубликованные в октябре 2025 года. Источник: IBM
-
В тесте IFEval (следование инструкциям) модель Granite-4.0-H-1B набрала 78,5 балла, опередив Qwen3-1.7B (73,1) и другие модели с 1–2 млрд параметров.
-
В тесте BFCLv3 (вызов функций/инструментов) лидировала Granite-4.0-1B с результатом 54,8 балла — это лучший показатель в своем классе размеров.
-
В тестах на безопасность (SALAD и AttaQ) модели Granite набрали более 90%, превзойдя сопоставимых по размеру конкурентов.
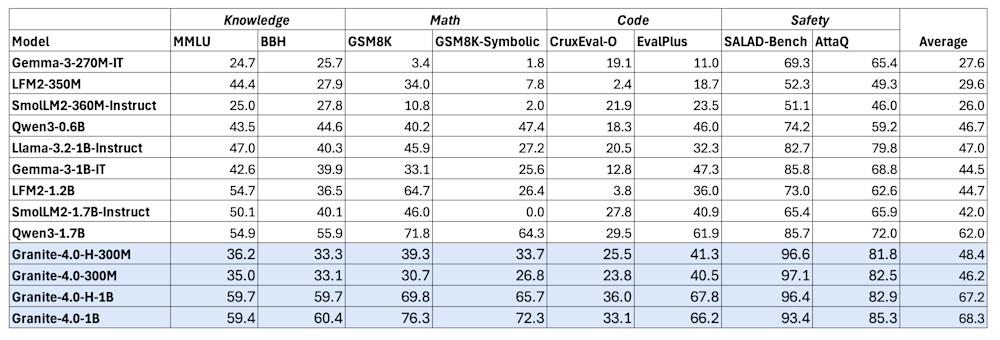
Общие результаты бенчмарков для моделей Granite 4.0 Nano от IBM. Источник: IBM
В целом Granite-4.0-1B достигла лидирующего среднего балла в бенчмарках на уровне 68,3% в таких областях, как общие знания, математика, программирование и безопасность.
Такая производительность особенно показательна, учитывая аппаратные ограничения, под которые изначально проектировались эти модели.
Им требуется меньше памяти, они работают быстрее на центральных процессорах или мобильных устройствах и не нуждаются в облачной инфраструктуре или ускорении на GPU для выдачи применимых на практике результатов.
Почему размер модели по-прежнему важен — но уже не так, как раньше
На раннем этапе развития LLM больший размер означал лучшее качество: большее количество параметров транслировалось в лучшую способность к обобщению, более глубокие возможности рассуждения и более богатый результат.
Однако по мере развития исследований в области трансформеров стало очевидно, что архитектура, качество обучения и настройка под конкретные задачи позволяют компактным моделям выступать в гораздо более весомой категории.
IBM делает ставку на эту эволюцию. Выпуская открытые небольшие модели, которые конкурентоспособны в реальных задачах, компания предлагает альтернативу монолитным ИИ-API, доминирующим в современном стеке приложений.
По сути, модели Nano решают три важнейшие и набирающие популярность задачи:
-
Гибкость развертывания — они работают где угодно, от мобильных устройств до микросерверов.
-
Конфиденциальность инференса — пользователи могут хранить данные локально без необходимости обращаться к облачным API.
-
Открытость и аудируемость — исходный код и веса моделей находятся в открытом доступе под свободной лицензией.
Реакция сообщества и намеки на дорожную карту
Команда IBM Granite не просто выпустила модели и самоустранилась — они пришли в открытое сообщество r/LocalLLaMA на Reddit, чтобы напрямую пообщаться с разработчиками.
В ветке в формате AMA («Задайте мне вопрос») Эмма (продукт-маркетинг Granite) отвечала на технические вопросы, проясняла ситуацию с соглашениями об именовании и намекала на то, что ждет нас в будущем.
Основные подтверждения из ветки:
-
В настоящее время обучается более крупная модель Granite 4.0
-
Модели, ориентированные на рассуждения («мыслящие аналоги»), находятся в разработке
-
В скором времени IBM выпустит рецепты для дообучения (fine-tuning) и подробную статью об обучении
-
В дорожную карту заложено добавление новых инструментов и расширение совместимости с платформами
Пользователи с энтузиазмом отреагировали на возможности моделей, особенно в задачах следования инструкциям и формирования структурированных ответов. Один из комментаторов подытожил:
«Это серьезная заявка для модели на 1B — если качество будет на уровне и она будет выдавать стабильные результаты. Задачи вызова функций, многоязычный диалог, заполнение пропусков (FIM)… это может стать настоящей рабочей лошадкой».
Другой пользователь отметил:
«Granite Tiny уже стала моим основным инструментом для веб-поиска в LM Studio — она работает лучше некоторых моделей Qwen. Возникло желание опробовать Nano».
Предыстория: IBM Granite и гонка корпоративного ИИ
Активное проникновение IBM в сферу больших языковых моделей началось в конце 2023 года с дебюта семейства базовых моделей Granite, первыми из которых стали Granite.13b.instruct и Granite.13b.chat. Выпущенные для использования в платформе Watsonx, эти первые декодер-ориентированные модели обозначили амбиции IBM по созданию корпоративных ИИ-систем, в которых приоритетом являются прозрачность, эффективность и производительность. В середине 2024 года компания открыла исходный код отдельных кодовых моделей Granite под лицензией Apache 2.0, заложив основу для их более широкого внедрения и экспериментов разработчиков.
Настоящим поворотным моментом стал релиз Granite 3.0 в октябре 2024 года — полностью открытого набора моделей общего назначения и узкоспециализированных моделей с количеством параметров от 1B до 8B. Эти модели делали упор на эффективность в противовес грубому масштабированию, предлагая такие возможности, как увеличенные контекстные окна, настройку по инструкциям и встроенные защитные механизмы (guardrails). IBM позиционировала Granite 3.0 как прямого конкурента Llama от Meta, Qwen от Alibaba и Gemma от Google, но с уникальным акцентом на корпоративный сектор. Более поздние версии, включая Granite 3.1 и Granite 3.2, принесли еще больше ориентированных на бизнес инноваций: встроенное обнаружение галлюцинаций, прогнозирование временных рядов, модели визуального анализа документов и переключатели условных рассуждений.
Семейство Granite 4.0, запущенное в октябре 2025 года, представляет собой самый амбициозный с технической точки зрения релиз IBM на сегодняшний день. Он вводит гибридную архитектуру, объединяющую слои трансформера и Mamba-2, что призвано совместить контекстную точность механизмов внимания с эффективностью памяти моделей пространства состояний. Такая конструкция позволяет IBM значительно снизить затраты памяти и задержки при инференсе, делая модели Granite пригодными для работы на относительно слабом «железе» при сохранении превосходства над аналогами в задачах следования инструкциям и вызова функций. Запуск также включает сертификацию по стандарту ISO 42001, криптографическую подпись моделей и дистрибуцию на таких платформах, как Hugging Face, Docker, LM Studio, Ollama и watsonx.ai.
Во всех версиях фокус IBM оставался неизменным: создавать надежные, эффективные и юридически прозрачные ИИ-модели для корпоративных сценариев использования. Обладая мягкой лицензией Apache 2.0, публичными бенчмарками и упором на управление и комплаенс, инициатива Granite не только отвечает на растущие опасения по поводу проприетарных моделей типа «черный ящик», но и предлагает западную открытую альтернативу бурному прогрессу таких команд, как Qwen от Alibaba. Благодаря этому IBM укрепляет свои позиции ключевого игрока в том, что может стать следующим этапом развития доступных для промышленного применения ИИ-моделей с открытыми весами.
Сдвиг в сторону масштабируемой эффективности
В конечном счете, выпуск моделей Granite 4.0 Nano компанией IBM отражает стратегический сдвиг в разработке LLM: от погони за рекордами количества параметров к оптимизации юзабилити, открытости и доступности при развертывании.
Сочетая конкурентоспособную производительность, принципы ответственной разработки и тесное взаимодействие с открытым сообществом, IBM позиционирует Granite не просто как семейство моделей, а как платформу для создания нового поколения легких и надежных ИИ-систем.
Для разработчиков и исследователей, ищущих высокую производительность без лишних накладных расходов, релиз Nano служит убедительным сигналом: вам не нужны 70 миллиардов параметров, чтобы создать нечто мощное — достаточно лишь правильных параметров.




