


Фирменная модель Alibaba Qwen3.7-Max способна работать автономно в течение 35 часов и поддерживает внешние инструменты, такие как Claude Code от Anthropic
Источник: VentureBeat · Carl Franzen


Индустрия искусственного интеллекта полностью вступила в «эру агентов» — парадигму, в которой ИИ-модели делают гораздо больше, чем просто генерируют текст: теперь они активно планируют, выполняют и корректируют сложные задачи не за секунды, а за дни.
Поэтому, пожалуй, неудивительно, что знаменитая команда исследователей искусственного интеллекта Qwen Team из китайского гиганта электронной коммерции Alibaba выпустила модель, способную выполнять автономную агентную работу на протяжении нескольких дней: эта модель появилась под названием Qwen3.7-Max, которая, как сообщает компания в своем блоге, достигла «~35 часов непрерывного автономного выполнения» — правда, в проприетарном, а не в открытом формате, как предыдущие релизы команды Qwen.
Это вполне ожидаемо — именно этого опасались многие аналитики и эксперты отрасли после ухода нескольких ключевых руководителей команды Qwen в начале этого года. Но для Alibaba это финансово оправданно, по крайней мере в краткосрочной перспективе: обучение ИИ-моделей, особенно таких мощных, как Qwen3.7-Max, стоит дорого, а бесплатная раздача их по сути в открытом доступе, как это принято с открытыми моделями, не позволяет быстро окупить затраты.
В этом смысле Alibaba просто следует примеру американских ИИ-гигантов, таких как OpenAI и Google, предлагая самые новые и передовые модели исключительно через платные API и подписки или платные веб-пакеты, а чуть менее производительные — с открытым исходным кодом.
Тем не менее, появление Qwen3.7-Max предоставляет предприятиям и индивидуальным пользователям дополнительные возможности выбора, а американским ИИ-лабораториям — усиление конкуренции, что для потребителей с любым бюджетом почти всегда идет на пользу. Тем не менее, тот факт, что модель доступна только с китайских серверов, может ограничить ее привлекательность для американских и европейских компаний, стремящихся максимально соблюдать требования комплаенса и безопасности при выполнении правительственных контрактов или хотя бы пытающихся соответствовать всем применимым государственным, местным и национальным нормам суверенитета данных.
Эпоха марафонского ИИ
Чтобы понять, почему Qwen3.7-Max отличается от предыдущих моделей, нужно посмотреть на то, как она обучалась и как работает на практике.
Языковые модели обычно деградируют, когда их заставляют удерживать единую линию рассуждений на протяжении тысяч шагов диалога: они забывают инструкции, галлюцинируют переменные или просто застревают в логических циклах. Qwen3.7-Max была специально разработана как «универсальный фундамент для агентов», способный к «долгосрочным рассуждениям», чтобы преодолеть именно это узкое место.
Наиболее яркой демонстрацией этой возможности стала автономная инженерная задача, подробно описанная командой Qwen. Модели предоставили доступ к изолированному серверу, оснащенному процессором T-Head ZW-M890 PPU — архитектуре оборудования, с которой модель никогда не сталкивалась во время обучения. Ее задачей была оптимизация ядра внимания.
В течение 35 часов подряд Qwen3.7-Max действовала полностью автономно. Она выполнила 1 158 отдельных вызовов инструментов, провела 432 оценки ядра, диагностировала ошибки компиляции и итеративно улучшала код, добившись ускорения в геометрической прогрессии в 10,0 раза.
Для сравнения, модели китайских конкурентов, такие как GLM-5.1 от z.ai и Kimi K2.6 от Moonshot, показали максимальное ускорение в 7,3 и 5,0 раза соответственно, часто добровольно завершая сеансы при отсутствии прогресса. Однако обе они доступны с открытым исходным кодом.
Такая выносливость достигается за счет того, что Alibaba называет «масштабированием среды». Подобно тому как ранние языковые модели становились умнее за счет усвоения более разнообразных текстов, Qwen3.7-Max обучалась на обширном, масштабируемом массиве динамических агентных сред.
Она способна симулировать однолетний жизненный цикл стартапа в ходе оценки «YC-Bench», преодолевая сотни раундов принятия решений, охватывающих управление персоналом и проверку контрактов. В ходе этой симуляции модель сумела сгенерировать 2,08 миллиона долларов виртуальной выручки, почти вдвое превзойдя показатели предыдущего поколения — Qwen3.6-Plus.
Кроме того, в модель встроена система самоконтроля вознаграждений за обход правил (reward-hacking): она автономно обнаруживает попытки схитрить в тренировочной среде и добавляет эвристические правила для исправления собственного поведения.
Интеллект для любого каркаса
С точки зрения продукта Qwen3.7-Max создана как когнитивный двигатель для современной разработки программного обеспечения и корпоративной автоматизации.
Модель предлагает колоссальное окно контекста в 1 миллион токенов и лимит вывода в 64 КБ, обеспечивая огромный запас прочности для обработки разветвленных кодовых баз или длинных технических документов.
Одна из ее самых привлекательных особенностей — «межплатформенная генерализация». Вместо жесткой привязки к определенному проприетарному интерфейсу, Qwen3.7-Max создана как легко встраиваемый интеллектуальный уровень для различных агентных фреймворков. Она нативно поддерживает протокол API Anthropic, что позволяет разработчикам напрямую подключать ее к существующим инструментам вроде Claude Code или OpenClaw.
Данные бенчмарков, предоставленные Alibaba, показывают, что такой обобщенный подход принес огромные дивиденды.
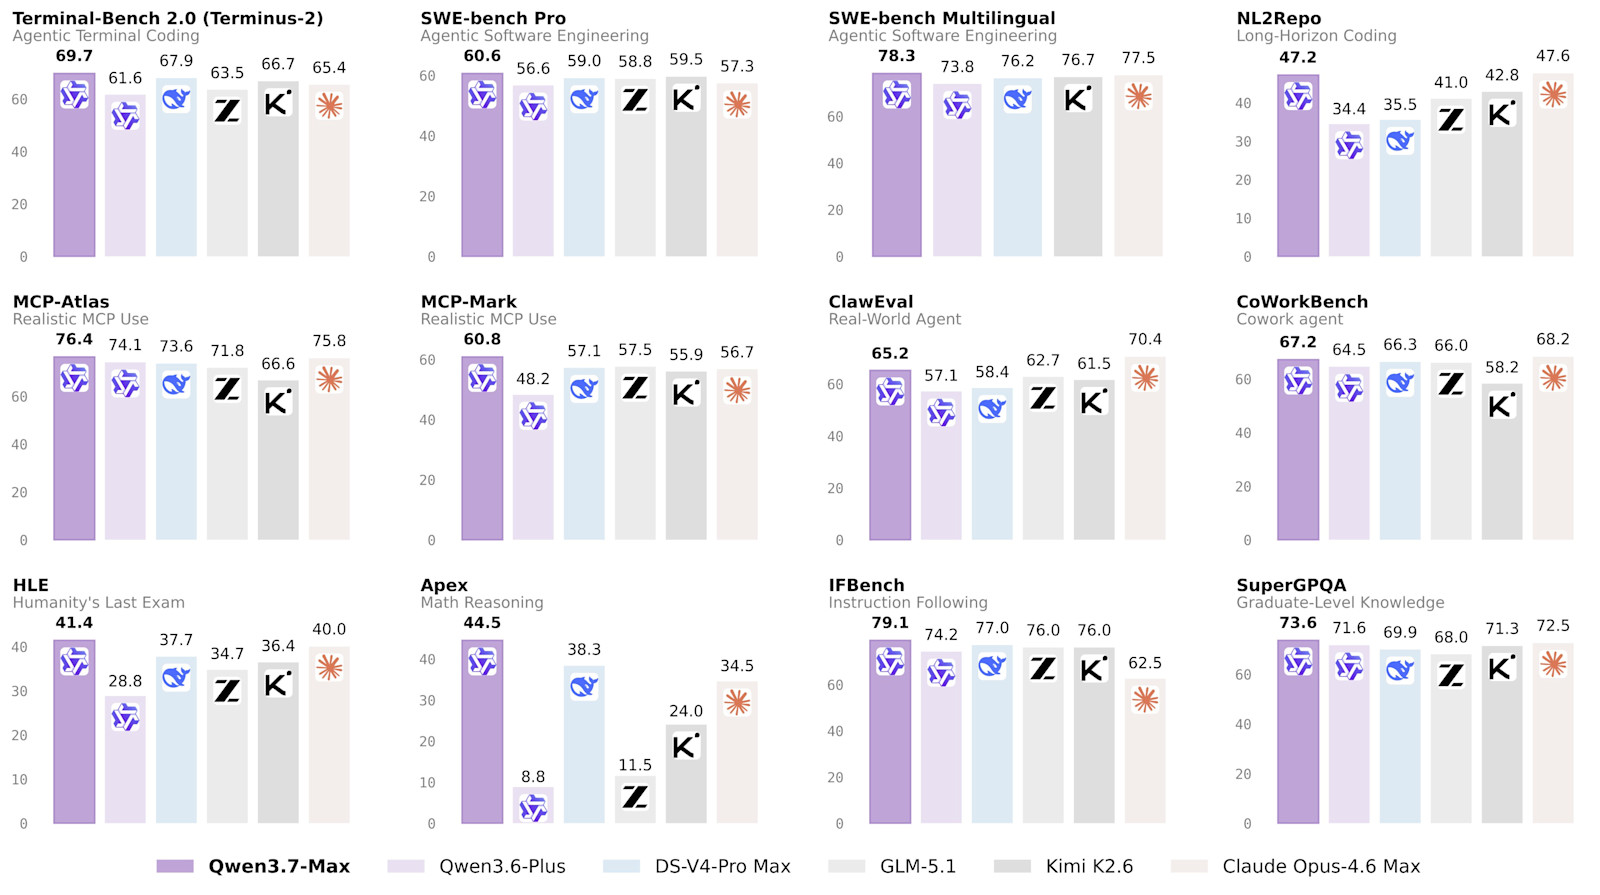
В бенчмарке Apex Math Reasoning Qwen3.7-Max набрала 44,5 балла, превзойдя результат Claude Opus-4.6 Max (34,5 балла) и DeepSeek V4-Pro Max (38,3 балла). Она также показала лидирующие результаты в бенчмарках Humanity’s Last Exam (41,4) и MCP-Atlas (76,4), оценивающем реальных агентов-кодеров.
Сравнительная таблица бенчмарков Alibaba Qwen3.7-Max. Источник: Alibaba Qwen
Это превращается в осязаемую пользу для конечных пользователей. Благодаря интеграции с протоколом контекста моделей (MCP) с открытым исходным кодом, модель может работать как автономный офисный помощник, способный читать университетские стандарты форматирования и автоматически переформатировать неаккуратный документ Word через инструменты командной строки без вмешательства человека.
Работа такого уровня интеллекта обходится в определенную цену. Разработчики, получающие доступ к API через Alibaba Cloud Model Studio, будут платить 2,50 доллара за 1 миллион входных токенов и 7,50 доллара за 1 миллион выходных токенов. На платформе также предусмотрены отдельные тарифы на создание и чтение кэша, а также плата в размере 10 долларов за 1000 вызовов для интегрированного поиска в Интернете, хотя инструменты интерпретатора кода пока остаются бесплатными в течение ограниченного времени.
Qwen3.7-Max занимает стратегическую золотую середину в текущей экономике API. Хотя она требует заметной надбавки по сравнению с агрессивно ценообразованными отечественными конкурентами — стоимость почти вдвое превышает DeepSeek V4 Pro ($5,22) и GLM-5.1 от Z.ai ($5,80), — она значительно превосходит по цене западных фронтирных гигантов, которым регулярно составляет конкуренцию в бенчмарках.
Для контекста: запуск тяжелых агентных рабочих процессов через GPT-5.4 от OpenAI или Claude Opus 4.7 от Anthropic обойдется разработчикам в $17,50 и $30,00 за миллион токенов соответственно. См. ценовую таблицу VentureBeat ниже:
|
Модель |
Вход |
Выход |
Общая стоимость |
Источник |
|
MiMo-V2.5 Flash |
$0.10 |
$0.30 |
$0.40 |
|
|
MiniMax M2.7 |
$0.30 |
$1.20 |
$1.50 |
|
|
Gemini 3.1 Flash-Lite |
$0.25 |
$1.50 |
$1.75 |
|
|
MiMo-V2.5 |
$0.40 |
$2.00 |
$2.40 |
|
|
Kimi-K2.6 |
$0.95 |
$4.00 |
$4.95 |
|
|
GLM-5 |
$1.00 |
$3.20 |
$4.20 |
|
|
Grok 4.3 (низкий контекст) |
$1.25 |
$2.50 |
$3.75 |
|
|
DeepSeek V4 Pro |
$1.74 |
$3.48 |
$5.22 |
|
|
GLM-5.1 |
$1.40 |
$4.40 |
$5.80 |
|
|
Claude Haiku 4.5 |
$1.00 |
$5.00 |
$6.00 |
|
|
Grok 4.3 (высокий контекст) |
$2.50 |
$5.00 |
$7.50 |
|
|
Qwen3.7-Max |
$2.50 |
$7.50 |
$10.00 |
|
|
Gemini 3.5 Flash |
$1.50 |
$9.00 |
$10.50 |
|
|
Gemini 3.1 Pro Preview (≤200K) |
$2.00 |
$12.00 |
$14.00 |
|
|
GPT-5.4 |
$2.50 |
$15.00 |
$17.50 |
|
|
Gemini 3.1 Pro Preview (>200K) |
$4.00 |
$18.00 |
$22.00 |
|
|
Claude Opus 4.7 |
$5.00 |
$25.00 |
$30.00 |
|
|
GPT-5.5 |
$5.00 |
$30.00 |
$35.00 |
Позиционируя Qwen3.7-Max чуть ниже Gemini 3.5 Flash от Google ($10,50), но значительно выше бюджетных моделей, Alibaba дает понять, что это не рядовой релиз; это флагманский движок рассуждений, оцененный так, чтобы переманить корпоративные рабочие нагрузки у самых дорогих предложений Силиконовой долины.
Лицензия пока остается проприетарной
При всей технической гениальности, самым спорным аспектом Qwen3.7-Max является способ ее распространения. Alibaba позиционирует этот релиз как «проприетарную модель». Она доступна исключительно через API.
Исторически сложилось так, что Qwen от Alibaba была кумиром для сообществ открытого кода и локальных языковых моделей. Предыдущие итерации, такие как Qwen 2.5 и Qwen 3.6, публиковали свои веса в открытом доступе. Открытые веса позволяют разработчикам, исследователям и предприятиям скачивать модель, запускать ее на собственном оборудовании и дообучать под конкретные или чувствительные к данным задачи без отправки проприетарной информации на сторонний сервер.
Закрывая Qwen3.7-Max за API, Alibaba переходит на стандартную коммерческую модель, используемую OpenAI (с GPT-4) и Anthropic (с Claude). Для корпоративных пользователей это означает, что использование Qwen3.7-Max требует доверия к Alibaba Cloud в отношении потоков данных и полной зависимости от подключения к интернету для запуска агентных процессов. Для сообщества разработчиков открытого кода это означает потерю доступа к одной из самых мощных моделей на планете на данный момент.
Реакция сообщества разделилась между восторгом и разочарованием
Реакция со стороны сообщества разработчиков была незамедлительной и охарактеризовалась смесью глубокого уважения к инженерному достижению и разочарования по поводу лицензионной политики.
Известный комментатор в сфере ИИ Sudo su (@sudoingX) выразил преобладающие настроения в X (бывший Twitter). «qwen невероятны, — написал он. — они только что выпустили 3.7 max, и она побеждает opus 4.6 max в большинстве бенчмарков, которые они запускали».
Технические показатели, особенно выносливость модели, поразили многих специалистов. «цифра по математике в бенчмарке Apex Math, 44,5 против 34,5 у opus — это небольшой разрыв», — отметил Sudo su. «35 часов подряд на задаче оптимизации ядра с более чем 1000 вызовов инструментов — это то, что я перечитываю снова и снова. это реальное воплощение эпохи агентов, а не просто слайд в презентации».
Скорость релизов Alibaba также привлекает внимание. Учитывая, что Qwen 3.6 вышла всего месяц назад, скачок до 3.7-Max подчеркивает неустанный темп разработки. Как заметил Sudo su, «так больше никто не двигается».
Тем не менее, похвала сильно омрачена переходом к закрытой экосистеме. Утрата весов модели воспринимается как удар по движению локального ИИ, которое опирается на передовые открытые модели для раздвижения границ того, что можно сделать на потребительском «железе» или частных корпоративных кластерах.
«но есть один момент: пожалуйста, сделайте с открытым исходным кодом и эту модель тоже», — умолял Sudo su в своем посте. «3.6 dense сделала всю экосистему локальных LLM лучше. переход максимального уровня только на API закроет дверь, которую мы держали открытой. дайте нам весы в конце концов».
Qwen3.7-Max доказывает, что эпоха автономных агентов — это больше не теоретический прогноз; это нынешняя реальность, способная выполнять сложные инженерные задачи, пока люди спят. Единственный вопрос теперь заключается в том, станет ли этот новый рубеж ИИ демократизированным ресурсом, который можно скачать на свой ноутбук, или арендуемой утилитой интеллекта строго из облака. На данный момент с Qwen3.7-Max это, бесспорно, второй вариант.




