


ИИ присоединяется к 8-часовому рабочему дню: GLM выпускает открытую языковую модель 5.1, опережая Opus 4.6 и GPT-5.4 в SWE-Bench Pro


Перенимает ли Китай эстафету открытого ИИ?
Z.ai, также известная как Zhupai AI, китайская ИИ-стартап-компания, получившая наибольшую известность благодаря своим мощным моделям с открытым исходным кодом семейства GLM, представила сегодня GLM-5.1 на условиях мягкой лицензии MIT, которая позволяет предприятиям загружать, настраивать и использовать модель в коммерческих целях. Это можно сделать на платформе Hugging Face.
Этот шаг последовал за выпуском GLM-5 Turbo — более быстрой версии, представленной в прошлом месяце исключительно под проприетарной лицензией.
Новая модель GLM-5.1 предназначена для автономной работы в течение восьми часов над одной задачей, что знаменует собой окончательный переход от интуитивного программирования («vibe coding») к агентной инженерии.
Этот релиз представляет собой ключевой момент в эволюции искусственного интеллекта. В то время как конкуренты сосредоточились на увеличении токенов рассуждения для улучшения логики, Z.ai оптимизирует горизонты производительности.
GLM-5.1 — это модель смешанных экспертов (Mixture-of-Experts) с 754 миллиардами параметров, созданная для поддержания соответствия целей в ходе длительных сеансов выполнения, охватывающих тысячи вызовов инструментов.
«Агенты могли выполнять около 20 шагов к концу прошлого года, — написал лидер z.ai Лу в X. — glm-5.1 теперь может делать 1700. Время автономной работы, пожалуй, станет важнейшей кривой после законов масштабирования. glm-5.1 будет первой точкой на этой кривой, которую сообщество открытого кода сможет проверить собственными руками. надеюсь, вам понравится^^»
На рынке, где появляется всё больше быстрых моделей, Z.ai делает ставку на марафонца. Компания, вышедшая на Гонконгскую фондовую биржу в начале 2026 года с рыночной капитализацией в 52,83 миллиарда долларов, использует этот релиз для укрепления своих позиций в качестве ведущего независимого разработчика больших языковых моделей в регионе.
Технологии: ступенчатая схема оптимизации
Ключевой технологический прорыв GLM-5.1 заключается не только в её масштабе (хотя её 754 миллиарда параметров и контекстное окно в 202 752 токена внушительны), но и в способности избегать эффекта плато, наблюдаемого у предыдущих моделей.
В традиционных агентных рабочих процессах модель обычно применяет несколько привычных техник для быстрого получения начальных результатов, после чего её развитие стопорится. Предоставление ей большего времени или дополнительных вызовов инструментов обычно приводит к снижению эффективности или дрейфу стратегии.
Исследования Z.ai показывают, что GLM-5.1 работает по принципу так называемой ступенчатой схемы, для которой характерны периоды инкрементальной настройки в рамках фиксированной стратегии, перемежающиеся структурными изменениями, которые сдвигают границы производительности.
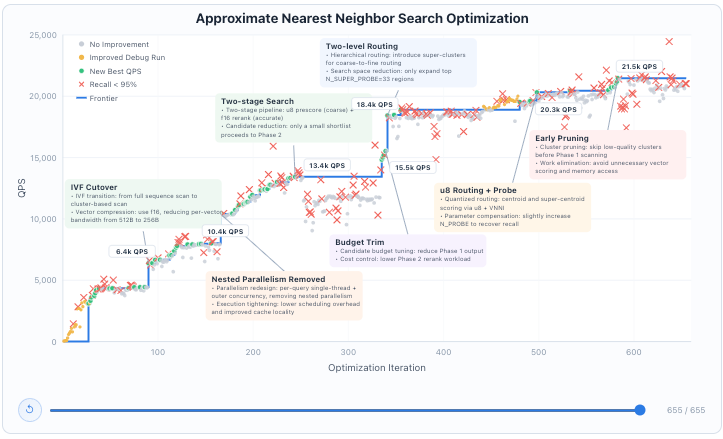
В Сценарии 1 своего технического отчета перед моделью была поставлена задача оптимизации высокопроизводительной векторной базы данных — задача, известная как VectorDBBench.
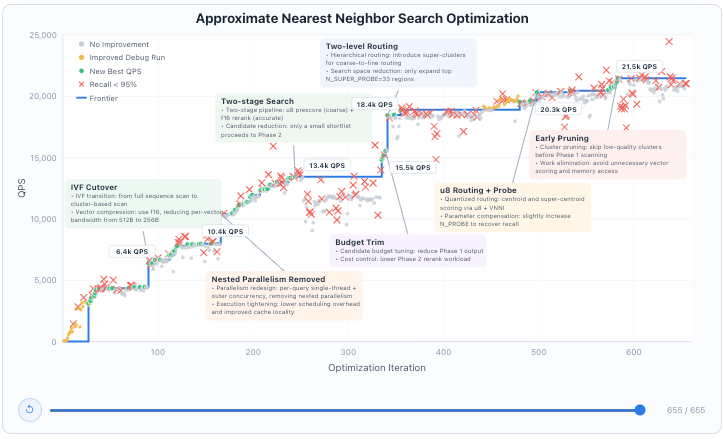
Иллюстрация VectorDBBench от z.ai для GLM-5.1. Источник: z.ai
Модели предоставляется каркас на Rust и пустые заготовки реализации, после чего она использует агентов на базе вызовов инструментов для редактирования кода, компиляции, тестирования и профилирования. В то время как предыдущие лучшие в своем классе результаты от моделей вроде Claude Opus 4.6 достигали предела производительности в 3547 запросов в секунду, GLM-5.1 прошла через 655 итераций и более 6000 вызовов инструментов. Траектория оптимизации не была линейной — её прерывали структурные прорывы.
На итерации 90 модель перешла от сканирования всего корпуса к зондированию кластеров IVF со сжатием векторов f16, что сократило пропускную способность на один вектор с 512 байт до 256 байт и увеличило производительность до 6400 запросов в секунду.
К итерации 240 она автономно внедрила двухэтапный конвейер, включающий прескоринг u8 и переранжирование f16, достигнув 13 400 запросов в секунду. В конечном итоге модель выявила и устранила шесть структурных узких мест, включая иерархическую маршрутизацию через суперкластеры и квантованную маршрутизацию с использованием оценки центроидов через VNNI. Эти усилия завершились финальным результатом в 21 500 запросов в секунду — примерно в шесть раз больше лучшего результата, достигнутого за один сеанс из 50 шагов.
Это демонстрирует модель, которая функционирует как собственный научно-исследовательский отдел, разбивая сложные проблемы на части и проводя эксперименты с ювелирной точностью.
Модель также справилась со сложной оптимизацией выполнения, снизив накладные расходы на планирование и улучшив локальность кэша. В ходе оптимизации поиска приблизительных ближайших соседей модель упреждающе удалила вложенный параллелизм в пользу редизайна с использованием однопоточности для каждого запроса и внешней конкурентности.
Когда модель сталкивалась с итерациями, на которых полнота (recall) падала ниже 95-процентного порога, она диагностировала сбой, корректировала параметры и внедряла компенсацию параметров для восстановления необходимой точности. Такой уровень автономной коррекции отличает GLM-5.1 от моделей, которые просто генерируют код без его тестирования в реальной среде.
Kernelbench: раздвигая границы машинного обучения
Выносливость модели была дополнительно протестирована в KernelBench Level 3, который требует сквозной оптимизации полных архитектур машинного обучения, таких как MobileNet, VGG, MiniGPT и Mamba.
В этом сценарии цель состоит в томж создании более быстрого ядра GPU по сравнению с эталонной реализацией PyTorch при сохранении идентичных выходных данных. Каждая из 50 задач запускается в изолированном контейнере Docker с одним графическим процессором H100 и ограничена 1200 шагами использования инструментов. Корректность и производительность оцениваются по сравнению с базовым уровнем PyTorch eager в отдельных контекстах CUDA.
Результаты подчеркивают значительный разрыв в производительности между GLM-5.1 и её предшественниками. В то время как оригинальная GLM-5 улучшалась быстро, но рано вышла на плато с ускорением в 2,6 раза, GLM-5.1 продолжала усилия по оптимизации гораздо дольше. В конечном итоге она обеспечила ускорение в среднем по геометрической прогрессии в 3,6 раза по 50 задачам, продолжая добиваться полезных результатов далеко за пределами 1000 шагов использования инструментов.
Хотя Claude Opus 4.6 остается лидером в этом конкретном бенчмарке с показателем 4,2x, GLM-5.1 существенно расширила горизонт производительности для моделей с открытым исходным кодом.
Эта способность связана не просто с наличием более длинного контекстного окна; она требует от модели поддержания согласованности целей в течение длительного выполнения, снижая дрейф стратегии, накопление ошибок и неэффективные метод проб и ошибок. Одним из ключевых прорывов является способность формировать цикл автономного экспериментирования, анализа и оптимизации, в котором модель может упреждающе запускать бенчмарки, выявлять узкие места, корректировать стратегии и непрерывно улучшать результаты посредством итеративной доработки.
Все решения, сгенерированные в ходе этого процесса, прошли независимый аудит на предмет эксплуатации уязвимостей бенчмарка, что гарантировало отсутствие зависимости оптимизаций от специфического поведения тестов и их применимость к произвольным новым входным данным при сохранении вычислений в потоке CUDA по умолчанию.
Продуктовая стратегия: подписка и субсидии
GLM-5.1 позиционируется как инструмент инженерного класса, а не как потребительский чат-бот. Чтобы поддержать это, Z.ai интегрировала его в комплексную экосистему Coding Plan, созданную для прямой конкуренции с инструментами для разработчиков премиум-класса.
Предложение продуктов разделено на три уровня подписки, каждый из которых включает бесплатные инструменты Протокола контекста модели (Model Context Protocol) для визуального анализа, поиска в Интернете, чтения веб-страниц и работы с документами.
Уровень Lite по цене 27 долларов США за квартал предназначен для небольших нагрузок и предлагает тройной объем использования по сравнению с сопоставимым тарифом Claude Pro. Уровень Pro за 81 доллар США за квартал разработан для сложных рабочих нагрузок, предлагая в пять раз больший объем использования по сравнению с планом Lite и выполнение задач на 40–60% быстрее.
Уровень Max за 216 долларов США за квартал ориентирован на продвинутых разработчиков с высокими потребностями, обеспечивая гарантированную производительность в часы пик.
Для тех, кто использует API напрямую или через такие платформы, как OpenRouter или Requesty, Z.ai установила цену на GLM-5.1 в размере 1,40 доллара США за один миллион входных токенов и 4,40 доллара США за миллион выходных токенов. Также доступна скидка на кэширование в размере 0,26 доллара США за миллион входных токенов.
|
Модель |
Вход |
Выход |
Общая стоимость |
Источник |
|
Grok 4.1 Fast |
$0.20 |
$0.50 |
$0.70 |
|
|
MiniMax M2.7 |
$0.30 |
$1.20 |
$1.50 |
|
|
Gemini 3 Flash |
$0.50 |
$3.00 |
$3.50 |
|
|
Kimi-K2.5 |
$0.60 |
$3.00 |
$3.60 |
|
|
MiMo-V2-Pro (≤256K) |
$1.00 |
$3.00 |
$4.00 |
|
|
GLM-5 |
$1.00 |
$3.20 |
$4.20 |
|
|
GLM-5-Turbo |
$1.20 |
$4.00 |
$5.20 |
|
|
GLM-5.1 |
$1.40 |
$4.40 |
$5.80 |
|
|
Claude Haiku 4.5 |
$1.00 |
$5.00 |
$6.00 |
|
|
Qwen3-Max |
$1.20 |
$6.00 |
$7.20 |
|
|
Gemini 3 Pro |
$2.00 |
$12.00 |
$14.00 |
|
|
GPT-5.2 |
$1.75 |
$14.00 |
$15.75 |
|
|
GPT-5.4 |
$2.50 |
$15.00 |
$17.50 |
|
|
Claude Sonnet 4.5 |
$3.00 |
$15.00 |
$18.00 |
|
|
Claude Opus 4.6 |
$5.00 |
$25.00 |
$30.00 |
|
|
GPT-5.4 Pro |
$30.00 |
$180.00 |
$210.00 |
Стоит отметить, что модель расходует квоту втрое быстрее стандартной нормы в часы пик, которые определяются с 14:00 до 18:00 по пекинскому времени ежедневно, хотя ограниченная по времени акция до апреля 2026 года позволяет тарифицировать использование в непиковые часы по стандартной ставке 1x. Дополнением к флагману стала недавно представленная модель GLM-5 Turbo.
В то время как 5.1 — это марафонец, Turbo — спринтер, проприетарный и оптимизированный для быстрого вывода результатов, а также таких задач, как использование инструментов и постоянная автоматизация.
При стоимости 1,20 доллара США за миллион входных токенов / 4 доллара США за миллион выходных токенов она дороже базовой GLM-5, но доступнее новой GLM-5.1, что позиционирует ее как коммерчески привлекательный вариант для высокоскоростных запусков управляемых агентов.
Модель также упакована для локального развертывания и поддерживает такие фреймворки вывода, как vLLM, SGLang и xLLM. Полные инструкции по развертыванию доступны в официальном репозитории GitHub, что позволяет разработчикам запускать MoE-модель с 754 миллиардами параметров на собственной инфраструктуре.
Для корпоративных команд модель включает в себя расширенные возможности логического вывода (рассуждения), к которым можно получить доступ с помощью параметра мышления (thinking) в запросах к API, что позволяет модели демонстрировать свой внутренний пошаговый процесс рассуждения перед выдачей окончательного ответа.
Бенчмарки: новый мировой стандарт
Данные о производительности GLM-5.1 свидетельствуют о том, что она опередила несколько устоявшихся западных моделей в задачах программирования и инженерии.
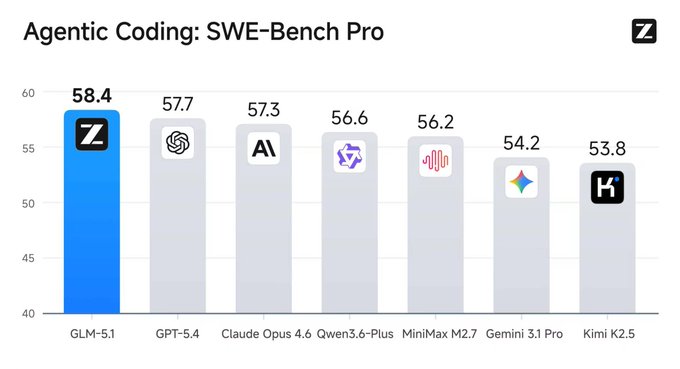
Сравнительная диаграмма бенчмарка SWE-Bench Pro, показывающая лидерство GLM-5.1 среди других основных моделей. Источник: z.ai
В бенчмарке SWE-Bench Pro, который оценивает способность модели решать реальные проблемы GitHub с использованием промпта-инструкции и окна контекста в 200 000 токенов, GLM-5.1 набрала 58,4 балла. Для контекста: это опережает GPT-5.4 с 57,7 балла, Claude Opus 4.6 с 57,3 балла и Gemini 3.1 Pro с 54,2 балла.
Помимо стандартизированных тестов по программированию, модель продемонстрировала значительный прирост в бенчмарках рассуждений и агентских задач. Она набрала 63,5 балла на Terminal-Bench 2.0 при оценке с помощью фреймворка Terminus-2 и достигла 66,5 балла в паре с обвязкой Claude Code.
На платформе CyberGym она добилась результата в 68,7 балла по итогам одиночного прогона по 1 507 задачам, продемонстрировав почти 20-очковое преимущество над предыдущей моделью GLM-5. Модель также показала сильные результаты в публичном наборе MCP-Atlas с результатом 71,8 балла и набрала 70,6 балла в T3-Bench.
В области логических рассуждений она набрала 31,0 балла в Humanitys Last Exam, который подскочил до 52,3 балла, когда модели разрешили использовать внешние инструменты. В бенчмарке математических соревнований AIME 2026 она достигла 95,3 балла, а в GPQA-Diamond для научных рассуждений экспертного уровня — 86,2 балла.
Самым впечатляющим неофициальным бенчмарком стал тест «Сценарий 3»: создание среды рабочего стола в стиле Linux с нуля за восемь часов.
В отличие от предыдущих моделей, которые могли создать базовую панель задач и окно-заглушку, прежде чем объявить задачу выполненной, GLM-5.1 автономно заполнила файловый обозреватель, терминал, текстовый редактор, системный монитор и даже функциональные игры.
Она итеративно дорабатывала дизайн и логику взаимодействия, пока не создала визуально цельное, функциональное веб-приложение. Это служит наглядным примером того, что становится возможным, когда модели предоставляется время и способность продолжать совершенствовать собственную работу.
Лицензирование и переход к открытости
Лицензирование этих двух моделей многое говорит о текущем состоянии глобального рынка искусственного интеллекта. GLM-5.1 выпущена под лицензией MIT, а ее веса находятся в открытом доступе на Hugging Face и ModelScope.
Это продолжает историческую стратегию Z.ai по использованию релизов с открытым исходным кодом для завоевания доверия разработчиков и расширения экосистемы. Однако GLM-5 Turbo остается проприетарной и с закрытым исходным кодом. Это отражает растущую тенденцию среди ведущих ИИ-лабораторий к гибридной модели: использованию моделей с открытым исходным кодом для широкого распространения при сохранении вариантов, оптимизированных для выполнения, за платной подпиской.
Отраслевые аналитики отмечают, что этот сдвиг происходит на фоне ребалансировки на китайском рынке, где такие тяжеловесы, как Alibaba, также начинают отделять свои проприетарные разработки от открытых релизов.
Генеральный директор Z.ai Чжан Пэн, судя по всему, справляется с этой задачей, обеспечивая то, что, пока основной интеллект флагманского продукта открыт для сообщества, инфраструктура высокоскоростного выполнения остается коммерческим активом, приносящим доход.
Компания прямо не обещает выкладывать в открытый доступ сам GLM-5 Turbo, но заявляет, что полученные наработки будут внедрены в будущие релизы с открытым исходным кодом. Такая сегментированная стратегия помогает стимулировать внедрение, позволяя компании строить устойчивую бизнес-модель вокруг своих наиболее коммерчески значимых разработок.
Реакция сообщества и пользователей: выполнение недельной работы за пару дней
Реакция разработчиков на релиз GLM-5.1 в основном сосредоточена на надежности модели в средах производственного уровня.
Отзывы пользователей свидетельствуют о высокой степени доверия к автономности модели.
Один из разработчиков отметил, что GLM-5.1 поразила его своим качеством: по его словам, модель справляется с задачами надежнее других аналогов и требует гораздо меньше доработок промптов. Другой разработчик упомянул, что общий рабочий процесс модели — от планирования до реализации проекта — функционирует превосходно, позволяя уверенно доверять ей сложные задачи.
Конкретные примеры из практики пользователей подчеркивают значительный рост эффективности.
Пользователь из Crypto Economy News сообщил, что задача по предварительной обработке кода, логике отбора признаков и поиску решений для настройки гиперпараметров, на выполнение которой ушла бы целая неделя, была завершена всего за два дня. С момента получения тарифа GLM Coding другие разработчики также отмечают возможность работать более свободно и сосредоточиться на ключевой разработке, не беспокоясь о том, что нехватка ресурсов может затормозить прогресс.
В социальных сетях анонс запуска набрал более 46 000 просмотров за первый час, а пользователи были впечатлены заявлением о восьми часах автономной работы. Настроение среди ранних пользователей таково, что Z.ai успешно преодолела эпоху ИИ, страдающего от галлюцинаций, и вступила в период, когда моделям можно доверять самостоятельную оптимизацию путем многократных итераций.
Способность быстро создавать четыре приложения с помощью правильных промптов и структурного планирования была названа многими пользователями прорывным достижением для индивидуальных разработчиков.
Последствия долгосрочной работы
Выход GLM-5.1 говорит о том, что новым рубежом в конкуренции ИИ станут не токены в секунду, а продолжительность автономной работы.
Если модель может работать в течение восьми часов без вмешательства человека, это коренным образом меняет жизненный цикл разработки программного обеспечения.
Тем не менее, в Z.ai признают, что это лишь начало. Серьезные проблемы остаются нерешенными, например, разработка надежной самооценки для задач, где нет числовых метрик для оптимизации.
Еще одним серьезным препятствием является более ранний уход от локальных оптимумов, когда инкрементальная настройка перестает приносить результаты, а также поддержание согласованности трассировок выполнения, охватывающих тысячи вызовов инструментов.
На данный момент компания Z.ai обозначила новую планку. С выходом GLM-5.1 они представили модель, которая не просто отвечает на вопросы, а доводит проекты до конца. Модель уже совместима с широким спектром инструментов для разработчиков, включая Claude Code, OpenCode, Kilo Code, Roo Code, Cline и Droid.
Для разработчиков и предприятий вопрос звучит уже не как «о чем спросить этот ИИ?», а «какую задачу поручить ему на ближайшие восемь часов?»
Фокус индустрии явно смещается в сторону систем, способных надежно выполнять многоэтапную работу с минимальным надзором. Этот переход к агентной инженерии знаменует собой новую фазу внедрения искусственного интеллекта в мировую экономику.




