


Qwen-AgentWorld прогнозирует состояния среды
Источник: VentureBeat · Sean Michael Kerner


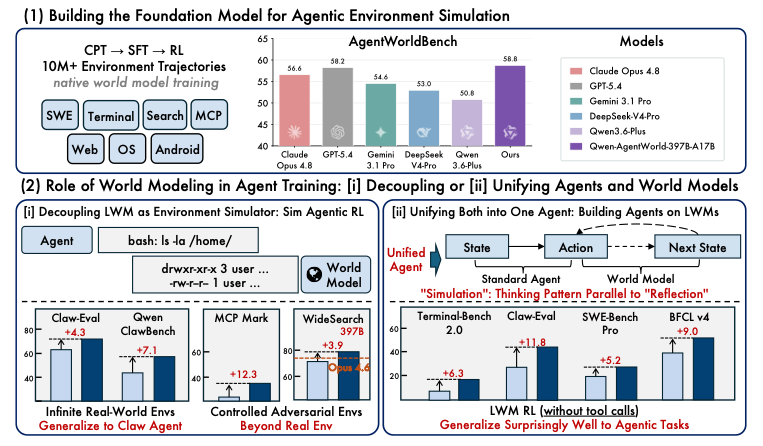
Команда Qwen компании Alibaba во вторник выпустила Qwen-AgentWorld — две модели, обученные не действовать внутри среды агентов, а предсказывать, какой ответ эта среда выдаст. Релиз охватывает семь доменов в рамках единой архитектуры: MCP, Search (поиск), Terminal (терминал), Software Engineering (разработка ПО), Android, Web (веб) и OS (операционные системы).
Этот релиз продолжает недавний курс Alibaba на развитие автономных агентов. Модель Qwen3.7-Max, представленная в мае, была создана с расчетом на 35-часовую автономную работу.
Такой подход направлен на преодоление предела, с которым неизбежно сталкиваются команды, обучающие агентов в больших масштабах. Реальные поисковые системы выдают существующие результаты без возможности задать контролируемые условия. Живые терминалы не позволяют по требованию имитировать нехватку дискового пространства. Обучение агентов ограничено тем, что могут предоставить рабочие среды, при этом отсутствует систематический способ смоделировать краевые случаи (edge cases), с которыми агентам придется сталкиваться в реальной работе, хотя в процессе обучения они встречаются крайне редко.
Исследовательская группа обучила агентов внутри созданного симулятора и зафиксировала прирост производительности, превосходящий результаты обучения исключительно на реальных средах. В ходе отдельного теста использование обучения моделей мира в качестве предварительного этапа (разминки) перед агентской донастройкой улучшило показатели по семи бенчмаркам, включая три новых, с которыми модель ранее не сталкивалась.
В документе, сопровождающем релиз, указан пробел в предыдущих исследованиях агентов: «Мы утверждаем, что моделирование мира — это важнейший недостающий элемент на пути к созданию универсальных агентов».
Qwen-AgentWorld обучается на ответах среды, а не на действиях агентов
Большинство агентских моделей обучены отвечать на один вопрос: учитывая то, что среда только что показала, что мне делать дальше? Модель Qwen-AgentWorld обучена отвечать на противоположный вопрос: учитывая то, что агент только что сделал, что покажет среда?
Это изменение лежит в основе того, что в исследовании называется языковой моделью мира (language world model): вместо оптимизации выбора действий модель учится предсказывать следующее состояние среды во всех семи доменах в рамках единой задачи обучения. Предыдущие разработки были более узконаправленными: WebWorld, более ранний проект Qwen от февраля, охватывал только веб-среду; а Agent World Model от Snowflake, опубликованная в том же месяце, генерирует среды на базе кода и SQL вместо обучения модели предсказывать состояния. Qwen-AgentWorld стала первой системой, объединившей семь доменов в одной модели, в которую моделирование среды заложено на самом раннем этапе предварительного обучения.
Alibaba обучила обе модели в три этапа на более чем 10 миллионах траекторий взаимодействия со средой, полученных в ходе реальных запусков агентов. Первый этап обучает модель тому, как ведут себя различные среды: файловые системы, состояния терминала, изменения DOM в браузере, API-ответы. Второй этап учит модель осмысливать то, что должно произойти дальше, прежде чем прогнозировать это. Третий этап — обучение с подкреплением (reinforcement learning) — уточняет прогнозы с помощью проверок на основе правил и открытой оценки качества.
Обе модели используют архитектуру Mixture-of-Experts (смесь экспертов), при которой для каждого токена активна лишь доля параметров. Модель с 35 млрд параметров задействует 3 млрд; модель с 397 млрд — 17 млрд. Обе поддерживают контекстные окна размером 256K. Для графических интерфейсов (Android, Web и OS) модели работают с деревьями доступности текста и иерархиями представлений пользовательского интерфейса (UI), а не со скриншотами.
Веса модели с 35 млрд параметров и набор AgentWorldBench доступны по лицензии Apache 2.0; веса модели с 397 млрд параметров в публичный доступ не выкладывались.
Результаты обучения важнее бенчмарков
Оценки в бенчмарках показывают, насколько точно модели предсказывают реакцию среды. Результаты обучения демонстрируют, какова реальная ценность этой способности к прогнозированию для команд, создающих агентов, — и именно эти цифры имеют наибольшее значение.
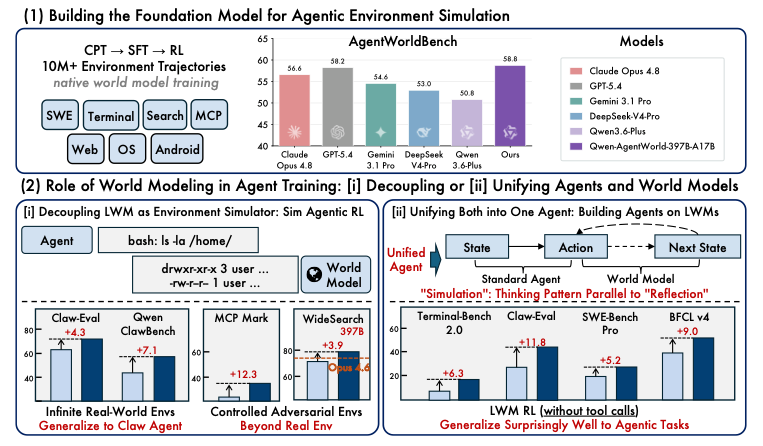
По словам исследователей, агенты, обученные в контролируемой симуляции, превзошли тех, что обучались в реальных средах. Внедрение целевых возмущений (частичных ответов, заставляющих агента совершать дополнительные шаги, и пограничных кейсов, которые реальная среда воспроизводит крайне редко) позволило поднять показатель MCPMark с 24.6 до 33.8. В домене Search агенты, обученные в полностью вымышленных мирах, успешно перенесли свои навыки на реальные поисковые задачи, увеличив метрику WideSearch F1 Item с 34.02 до 50.31 на открытой 35-миллиардной модели. Отдельный тест с предварительным этапом (разминкой) показал, что предварительное обучение модели мира улучшило результат BFCL v4 с 62.29 до 71.25, а Claw-Eval — с 53.60 до 64.88 без какой-либо специфической для агентов донастройки.
Источник: Alibaba https://arxiv.org/pdf/2606.24597
Исследователи указывают на бенчмарк и риск переобучения
Работа вызвала незамедлительную реакцию исследователей в области искусственного интеллекта в соцсети X. Высказанные ими опасения отражают то, что практикам необходимо проверить, прежде чем полагаться на эти выводы.
Относительно задачи обучения и результатов переноса навыков оценка одного из исследователей в области ИИ и машинно обучения была прямой. «Все остальные «агентские» модели обучались действовать внутри сред, — написал @drawais_ai, имеющий докторскую степень и регулярно разбирающий научные статьи по ИИ. — Qwen перевернула подход. Они обучили модель предсказывать саму среду… Затем эти прогностические знания переносятся на агентские задачи даже без какой-либо специфической донастройки агента». Он назвал результат метода Controllable Sim RL (управляемое обучение с подкреплением в симуляции) «доказательством» того, что синтетическое обучение способно в больших масштабах заменить обучение с подкреплением в реальной среде, а также отметил, что три из семи бенчмарков переноса были полностью внедоменными.
Отрыв в бенчмарках немедленно привлек пристальное внимание. «AgentWorldBench — это бенчмарк, который Alibaba создала и опубликовала в той же статье, — написал @TheSignal_Desk, специализирующийся на объективном анализе и ключевых цифрах в исследованиях ИИ. — Они сами написали тест и сами же превзошли его на 0.46 балла».
Методология обучения с подкреплением в симуляции — это именно тот результат, который, по мнению @limalemonnn, разработчика производственных ИИ-агентов, требует наибольшей проверки до того, как главное утверждение статьи начнут цитировать. «Агенты, обученные в симуляторах, традиционно переобучаются на особенности конкретного симулятора, — написали они. — Если модель мира слишком «чистая», агент изучает саму модель, а не задачу». Они указали на разделение данных в статье как на раздел, с которым специалистам следует ознакомиться перед тем, как делать выводы на основе цифр.
Опасения по поводу переобучения отчасти снимаются самими данными. Разница между неконтролируемым обучением в симуляции (MCPMark 24.6) и контролируемым (MCPMark 33.8) говорит о том, что прирост производительности во многом зависит именно от механизма управляемости, а не только от точности симуляции. Результат поиска в вымышленном мире, где агенты, обученные в придуманных средах, перенесли свои навыки на реальные поисковые задачи, является самым весомым аргументом авторов против опасений насчет переобучения.
Что это значит для команд, создающих агентские конвейеры
Для инженерных команд в сфере ИИ, которые разрабатывают и масштабируют агентские пайплайны, эта работа знаменует собой значимый сдвиг в том, как формируются возможности агентов. Команды, обучающие агентов в больших масштабах, теперь имеют третий вариант на выбор между обучением с подкреплением в реальной среде и статическими бенчмарками: контролируемую симуляцию, которая внедряет граничные случаи, недоступные в продакшене.
Синтетические среды представляют собой полноценный уровень обучения. Контролируемая симуляция, воспроизводящая условия, которые реальная среда не в состоянии сгенерировать, служит дополнением к обучению с подкреплением в реальных условиях, а не обходным путем.
То, чему модель обучается до начала тренировки агентов, имеет гораздо больший вес, чем учитывает большинство современных пайплайнов. Вывод о пользе предварительного этапа (рост производительности в ранее не виданных бенчмарках без специализированного обучения агента) говорит о том, что закладывать основы взаимодействия со средой необходимо на более ранних стадиях разработки, чем это принято сейчас.




