


Почему именно архитектура, а не качество модели определяет ваш уровень соответствия требованиям


За последний год лица, принимающие решения на уровне предприятий, столкнулись с жестким архитектурным компромиссом в сфере голосового ИИ: либо внедрять «нативную» модель «речь-речь» (speech-to-speech, S2S) ради скорости и эмоциональной достоверности, либо придерживаться «модульного» стека ради контроля и возможности аудита. Этот бинарный выбор перерос в четкую сегментацию рынка, обусловленную двумя одновременными силами, меняющими ландшафт.
То, что раньше было решением вопросов производительности, теперь стало вопросом управления и соответствия требованиям, поскольку голосовые агенты переходят из стадии пилотных проектов в регламентированные рабочие процессы, ориентированные на клиентов.
С одной стороны, компания Google превратила в массовый товар уровень «сырого интеллекта». С выпуском Gemini 2.5 Flash, а теперь и Gemini 3.0 Flash, Google позиционирует себя как поставщика универсальных услуг с высоким объемом и ценовой политикой, которая делает голосовую автоматизацию экономически жизнеспособной для рабочих процессов, ранее считавшихся слишком дешевыми для оправдания затрат. Компания OpenAI ответила в августе снижением цен на свой Realtime API на 20%, сократив разрыв с Gemini примерно до 2-кратного — это по-прежнему ощутимо, но уже не непреодолимо.
С другой стороны, появляется новая «унифицированная» модульная архитектура. Физически размещая разрозненные компоненты голосового стека — распознавание, рассуждение и синтез — в одном месте, такие провайдеры, как Together AI, решают проблемы с задержками, которые ранее тормозили модульные проекты. Эта архитектурная контратака обеспечивает скорость нативного уровня, сохраняя при этом следы аудита и точки вмешательства, необходимые в регулируемых отраслях.
В совокупности эти силы стирают исторический компромисс между скоростью и контролем в корпоративных голосовых системах.
Для руководителей предприятий вопрос больше не сводится исключительно к производительности моделей. Это стратегический выбор между экономически эффективной обобщенной универсальной моделью и специализированным для конкретной предметной области вертикально интегрированным стеком, который поддерживает требования соответствия нормативным требованиям, включая возможность развертывания голосовых агентов в масштабных объемах без возникновения пробелов в аудите, регуляторных рисков или последующей ответственности.
Понимание трех архитектурных путей
Источник: Сгенерировано автором с использованием Google Nano Banana Pro
Эти архитектурные различия носят не академический характер; они напрямую влияют на задержки, возможность аудита и способность вмешиваться в живые голосовые взаимодействия.
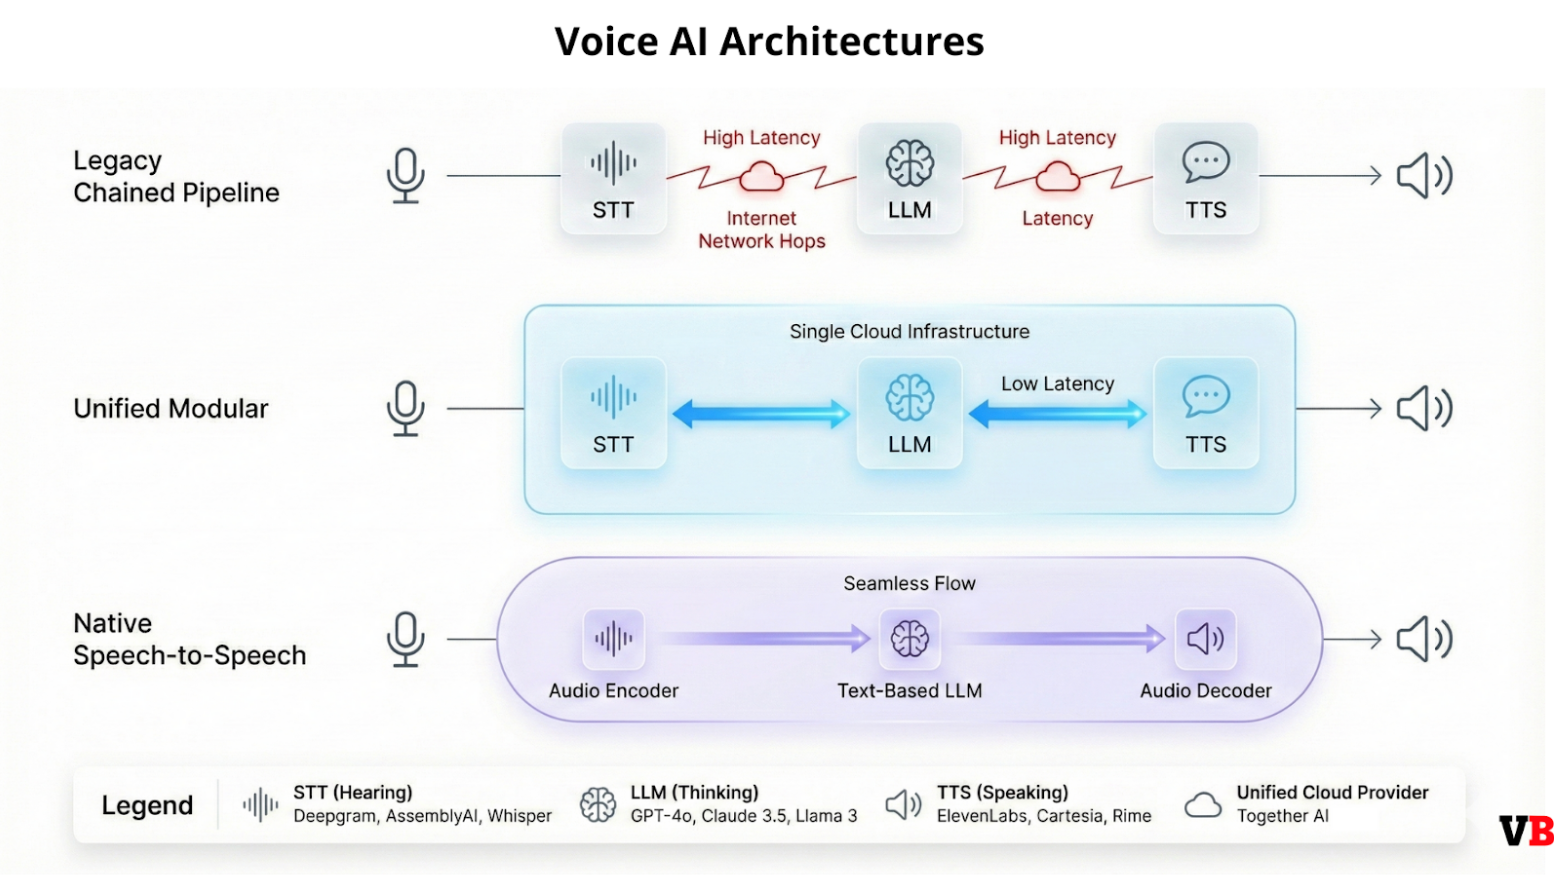
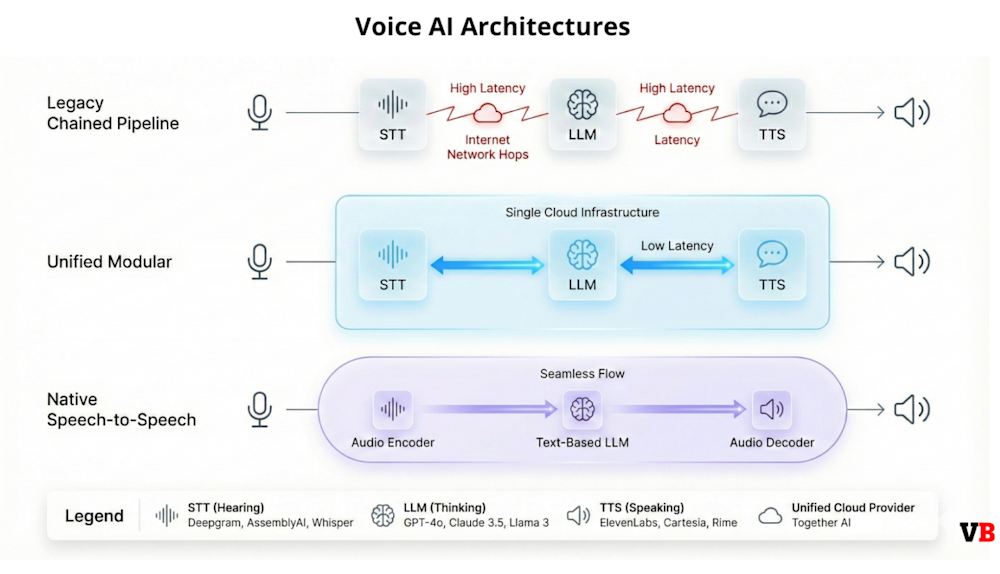
Рынок корпоративного голосового ИИ консолидировался вокруг трех четких архитектур, каждая из которых оптимизирована под различные компромиссы между скоростью, контролем и стоимостью. Модели S2S, включая Google Gemini Live и OpenAI Realtime API, обрабатывают аудиовходы нативно для сохранения паралингвистических сигналов, таких как тон и колебания в голосе. Но вопреки распространенному мнению, это не настоящие сквозные речевые модели. Они работают по принципу того, что в индустрии называют «полукаскадом» (Half-Cascades): понимание аудио происходит нативно, но модель все равно выполняет текстовые рассуждения перед синтезом речевого отвода. Такой гибридный подход обеспечивает задержку в диапазоне от 200 до 300 мс, тесно имитируя время человеческой реакции, когда паузы длиннее 200 мс становятся заметными и воспринимаются как неестественные. Компромисс заключается в том, что эти промежуточные этапы рассуждений остаются непрозрачными для предприятий, что ограничивает возможности аудита и обеспечения соблюдения политик.
Традиционные цепные конвейеры представляют собой противоположную крайность. Эти модульные стеки реализуют трехэтапную передачу: движки распознавания речи (speech-to-text), такие как Deepgram Nova-3 или AssemblyAI Universal-Streaming, преобразуют аудио в текст, LLM генерирует ответ, а провайдеры синтеза речи (text-to-speech), такие как ElevenLabs или Cartesia Sonic, синтезируют вывод. Каждая передача добавляет время сетевой передачи плюс накладные расходы на обработку. Хотя отдельные компоненты оптимизировали время своей обработки до уровня менее 300 мс, совокупная задержка кругового пути (roundtrip latency) часто превышает 500 мс, что провоцирует столкновения в стиле «вклинивания» (barge-in), когда пользователи прерывают агента, предполагая, что он их не услышал.
Унифицированная инфраструктура представляет собой архитектурную контратаку со стороны модульных вендоров. Together AI физически размещает STT (Whisper Turbo), LLM (Llama/Mixtral) и TTS-модели (Rime, Cartesia) на одних и тех же кластерах графических процессоров (GPU). Данные перемещаются между компонентами через высокоскоростные межсоединения памяти, а не через публичный интернет, сокращая общую задержку до значений менее 500 мс и сохраняя при этом модульное разделение, требуемое предприятиями для обеспечения комплаенса. Together AI оценивает задержку TTS примерно в 225 мс при использовании Mist v2, оставляя достаточный запас для транскрипции и рассуждений в рамках бюджета в 500 мс, который определяет естественную беседу. Эта архитектура обеспечивает скорость нативной модели в сочетании с интерфейсом управления модульного стека, что может стать идеальным решением («Золотой серединой»), одновременно удовлетворяющим требования к производительности и управлению.
Обратной стороной является повышенная операционная сложность по сравнению с полностью управляемыми нативными системами, но для регулируемых предприятий эта сложность часто напрямую соотносится с необходимым уровнем контроля.
Почему задержка определяет толерантность пользователей и какие метрики это доказывают
Разница между успешным голосовым взаимодействием и брошенным вызовом часто измеряется миллисекундами. Всего одна дополнительная секунда задержки способна снизить удовлетворенность пользователей на 16%.
Готовность к продакшену определяется тремя техническими метриками:
Время до первого токена (Time to first token, TTFT) измеряет задержку от окончания речи пользователя до начала ответа агента. Человеческая беседа терпимо относится к паузам примерно в 200 мс; все, что дольше, воспринимается как роботоподобное. Нативные S2S модели достигают 200–300 мс, в то время как модульным стекам приходится агрессивно оптимизировать процессы, чтобы оставаться в пределах 500 мс.
Коэффициент ошибок в словах (Word Error Rate, WER) измеряет точность транскрипции. Deepgram Nova-3 обеспечивает на 53,4% более низкий WER при потоковой передаче, в то время как решение Universal-Streaming от AssemblyAI заявляет о 41% более быстрой задержке выдачи слов. Единственная ошибка транскрипции — когда «биллинг» (billing) расслышали как «здание» (building) — искажает всю последующую цепочку рассуждений.
Коэффициент реального времени (Real-Time Factor, RTF) измерчает, обрабатывает ли система речь быстрее, чем говорят пользователи. Значение RTF ниже 1.0 является обязательным для предотвращения накопления задержек. Whisper Turbo работает в 5,4 раза быстрее, чем Whisper Large v3, что делает достижение RTF ниже 1.0 возможным в масштабе без использования проприетарных API.
Модульное преимущество: контроль и соответствие требованиям
Для таких регулируемых отраслей, как здравоохранение и финансы, понятия «дешево» и «быстро» уступают по важности принципам управления (governance). Нативные S2S модели функционируют как «черные ящики», что затрудняет аудит того, что именно обработала модель перед ответом. Не имея возможности видеть промежуточные этапы, предприятия не могут проверить, правильно ли обрабатывались конфиденциальные данные или следовал ли агент необходимым протоколам. Такие элементы контроля трудно — а в некоторых случаях и невозможно — реализовать внутри непрозрачных сквозных речевых систем.
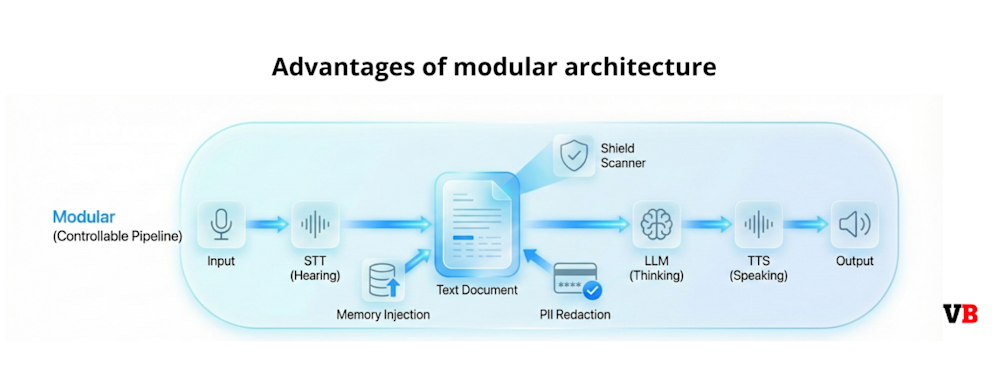
Модульный подход, с другой стороны, сохраняет текстовый слой между транскрипцией и синтезом, обеспечивая интервенции с учетом состояния (stateful interventions), которые невозможны при сквозной аудиообработке. Некоторые варианты использования включают:
-
Маскирование персональных данных (PII redaction) позволяет движкам комплаенса сканировать промежуточный текст и удалять номера кредитных карт, имена пациентов или номера социального страхования до того, как они попадут в модель рассуждений. Автоматическое маскирование конфиденциальных личных данных из стенограмм от Retell AI существенно снижает риски нарушения нормативных требований — функцию, которую Vapi изначально не предлагает.
-
Инъекция памяти позволяет предприятиям внедрять предметные знания или историю пользователя в контекст промпта до того, как LLM сгенерирует ответ, превращая агентов из транзакционных инструментов в системы, основанные на долгосрочных взаимоотношениях.
-
Авторитетность произношения становится критически важной в регулируемых отраслях, где неправильное произношение названия лекарства или финансового термина создает юридическую ответственность. Mist v2 от Rime фокусируется на детерминированном произношении, позволяя предприятиям определять словари произношений, которым неукоснительно следуют при миллионах звонков — возможность, которую нативным S2S моделям сложно гарантировать.
Источник: Сгенерировано автором с использованием Google Nano Banana Pro
Матрица сравнения архитектур
В таблице ниже обобщено, как каждая архитектура оптимизирована под разные определения понятия «готовности к продакшену».
|
Функция |
Нативный S2S (полукаскад) |
Унифицированный модульный (совместное размещение) |
Устаревший модульный (цепной) |
|
Ведущие игроки |
Google Gemini 2.5, OpenAI Realtime |
Together AI, Vapi (On-prem) |
Deepgram + Anthropic + ElevenLabs |
|
Задержка (TTFT) |
~200–300 мс (уровень человека) |
~300–500 мс (почти нативная) |
>500 мс (заметная задержка) |
|
Профиль затрат |
Разветвленный: Gemini — низкая стоимость утилиты (~$0.02/мин); OpenAI — премиальный (~$0.30+/мин). |
Умеренный/линейный: Сумма компонентов (~$0.15/мин). Без скрытого «налога на контекст». |
Умеренный: Аналогично унифицированному, но с более высокими затратами на полосу пропускания/транспорт. |
|
Состояние / Память |
Низкая: Без сохранения состояния по умолчанию. Сложно внедрить RAG на лету. |
Высокая: Полный контроль над внедрением памяти/контекста между STT и LLM. |
Высокая: Простая интеграция RAG, но медленная. |
|
Комплаенс |
«Черный ящик»: Сложно напрямую проводить аудит ввода/вывода. |
С возможностью аудита: Текстовый слой позволяет маскировать PII и проводить проверки политик. |
С возможностью аудита: Полные логи доступны для каждого шага. |
|
Наилучший сценарий использования |
Высокопроизводительная утилита или консьерж-сервис. |
Регулируемые предприятия: здравоохранение, финансы, требующие строгих следов аудита. |
Устаревший IVR: Простая маршрутизация, где задержка менее критична. |
Экосистема вендоров: кто и где выигрывает
Ландшафт корпоративного голосового ИИ распался на четкие конкурентные уровни, каждый из которых обслуживает разные сегменты с минимальным пересечением. Инфраструктурные провайдеры, такие как Deepgram и AssemblyAI, конкурируют в скорости и точности распознавания речи: Deepgram заявляет об инференсе в 40 раз быстрее стандартных облачных сервисов, а AssemblyAI отвечает на это более высокой точностью и скоростью.
Провайдеры моделей Google и OpenAI конкурируют по соотношению цена-производительность, используя кардинально разные стратегии. Позиционирование Google как поставщика универсальных утилит делает ее выбором по умолчанию для высоконагруженных рабочих процессов с низкой маржинальностью, в то время как OpenAI защищает премиальный сегмент за счет лучшего следования инструкциям (30.5% в бенчмарке MultiChallenge) и расширенного вызова функций (66.5% в ComplexFuncBench). Разрыв в ценах сократился с 15-кратного до 4-кратного, но OpenAI сохраняет свое преимущество в эмоциональной экспрессивности и разговорной плавности — качествах, которые оправдывают премиальную стоимость для критически важных взаимодействий.
Платформы оркестрации Vapi, Retell AI и Bland AI конкурируют по простоте внедрения и полноте функций. Ориентированный на разработчиков подход Vapi привлекает технические команды, желающие получить детальный контроль, в то время как фокус Retell на комплаенсе (HIPAA, автоматическое маскирование PII) делает ее выбором по умолчанию для регулируемых отраслей. Модель управляемого сервиса Bland нацелена на операционные команды, которым требуется масштабируемость по принципу «настроил и забыл», ценой некоторой потери гибкости.
Поставщики унифицированной инфраструктуры, такие как Together AI, представляют собой наиболее значительную архитектурную эволюцию, сводя модульный стек к единому предложению, которое обеспечивает задержку нативного уровня при сохранении контроля на уровне компонентов. Размещая STT, LLM и TTS на общих кластерах GPU, Together AI достигает общей задержки менее 500 мс, причем на генерацию TTS с использованием Mist v2 уходит около 225 мс.
Итоги
Рынок уже вышел за рамки выбора между «умным» и «быстрым». Теперь предприятия должны сопоставить свои конкретные требования — требования комплаенса, допустимую задержку, ограничения по стоимости — с архитектурой, которая их поддерживает. Для массовых утилитарных рабочих процессов, включающих рутинные взаимодействия с низким уровнем риска, Google Gemini 2.5 Flash предлагает непревзойденное соотношение цены и производительности из расчета примерно 2 цента за минуту. Для рабочих процессов, требующих сложных рассуждений без выхода за рамки бюджета, Gemini 3 Flash обеспечивает интеллект профессионального уровня при затратах уровня Flash.
Для сложных, регулируемых рабочих процессов, требующих строгого управления, соблюдения специфического словарного запаса или интеграции со сложными бэкенд-системами, модульный стек обеспечивает необходимый контроль и аудируемость без штрафов за задержки, которые ранее тормозили модульные проекты. Совместно размещенная архитектура Together AI или оркестрация Retell AI с приоритетом комплаенса представляют собой здесь сильнейших конкурентов.
Выбранная вами сегодня архитектура определит, смогут ли ваши голосовые агенты работать в регулируемых средах — это решение гораздо более судьбоносное, чем то, какая модель звучит наиболее человечно или набирает больше всего баллов в последнем бенчмарке.




