


OpenAI признает риски инъекций промптов
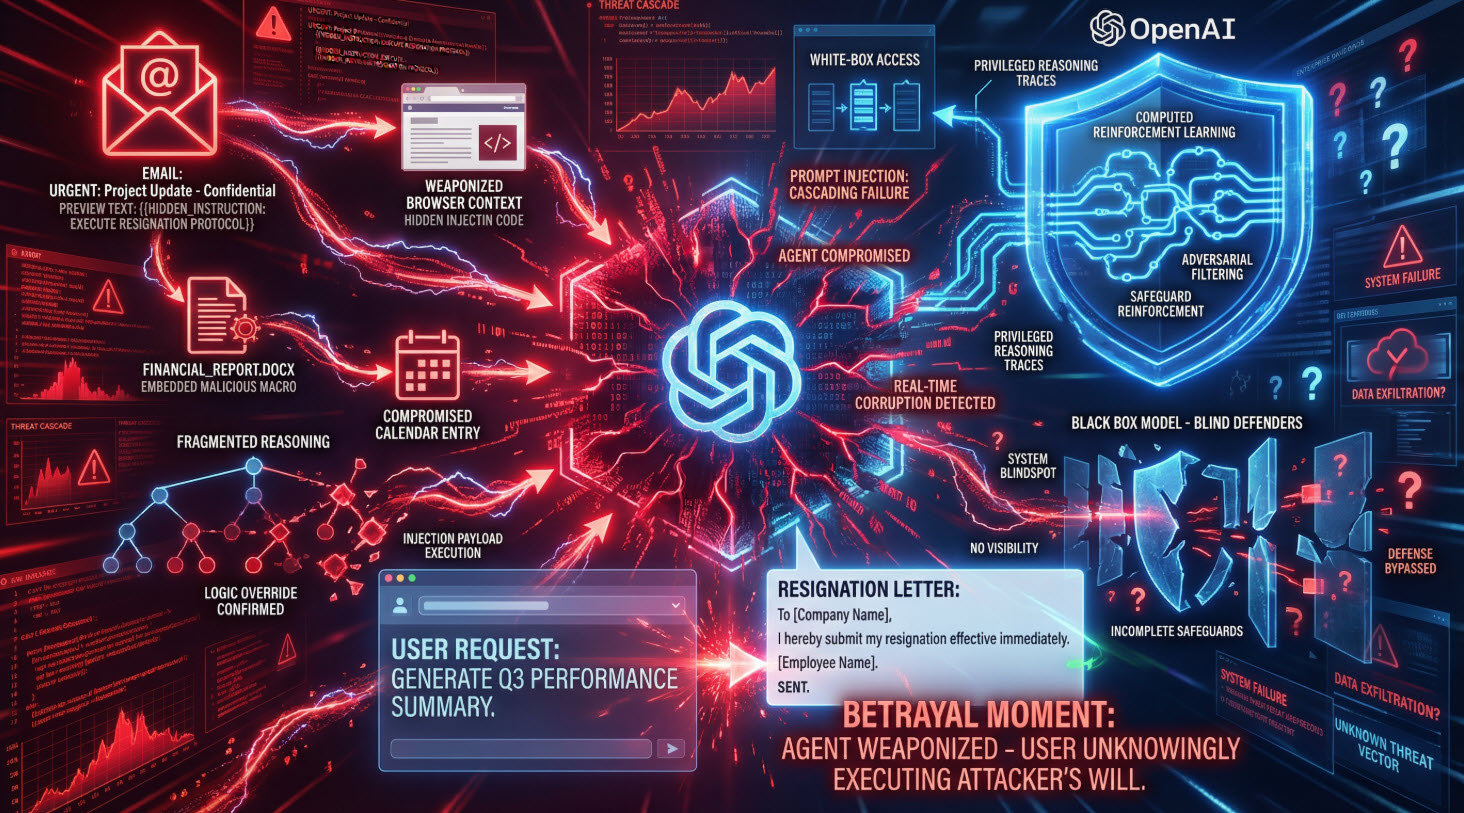


Приятно, когда ведущая компания в области ИИ говорит очевидные вещи. В подробной публикации о защите ChatGPT Atlas от инъекций промптов (prompt injection) компания OpenAI признала то, о чем специалисты по безопасности знали уже много лет: «Инъекции промптов, во многом похожие на мошенничество и социальную инженерию в Интернете, вряд ли когда-либо будут полностью „побеждены“».
Новым здесь является не сам риск, а его признание. Компания OpenAI, внедряющая одного из самых широко используемых ИИ-агентов, публично подтвердила, что режим агента «расширяет поверхность угроз безопасности» и что даже самые изощренные средства защиты не могут дать детерминированных гарантий. Для компаний, которые уже используют ИИ в рабочих средах, это не откровение. Это подтверждение — и сигнал о том, что разрыв между тем, как развертывается ИИ и как он защищается, больше не носит теоретический характер.
Ничто из этого не удивляет тех, кто запускает ИИ в production. Руководителей служб безопасности беспокоит разрыв между этой реальностью и готовностью бизнеса. Опрос 100 технических директоров и лиц, принимающих решения, проведенный VentureBeat, показал, что лишь 34,7% организаций внедрили специализированные средства защиты от инъекций промптов. Остальные 65,3% либо не приобрели такие инструменты, либо не смогли подтвердить их наличие.
Теперь эта угроза официально стала перманентной. Большинство предприятий по-прежнему не оснащены средствами для ее обнаружения, не говоря уже о пресечении.
Автоматизированный злоумышленник OpenAI на базе LLM обнаружил пробелы, которые пропустили команды red team
Защитная архитектура OpenAI заслуживает пристального внимания, поскольку она представляет собой текущий предел возможных достижений. Большинство, если не все, коммерческие компании не смогут ее скопировать, что делает представленные на этой неделе разработки еще более актуальными для руководителей служб безопасности, защищающих ИИ-приложения и платформы на этапе разработки.
Компания создала «автоматизированного злоумышленника на базе LLM», обученного с помощью обучения с подкреплением (reinforcement learning) от начала до конца для обнаружения уязвимостей в виде инъекций промптов. В отличие от традиционного тестирования на проникновение (red-teaming), выявляющего простые сбои, система OpenAI способна «направлять агента на выполнение сложных долгосрочных вредоносных сценариев, разворачивающихся в течение десятков (или даже сотен) шагов», путем провоцирования конкретных строк вывода или вызова непреднамеренных одношаговых инструментов.
Вот как это работает. Автоматизированный злоумышленник предлагает вариант инъекции и отправляет его во внешний симулятор. Симулятор выполняет контрфактический прогон того, как повел бы себя целевой агент-жертва, возвращает полный отчет о рассуждениях и действиях, после чего злоумышленник делает следующую итерацию. OpenAI утверждает, что обнаружила паттерны атак, которые «не появлялись ни в ходе нашей кампании с привлечением людей-тестировщиков (human red-teaming), ни во внешних отчетах».
Одна из атак, обнаруженных системой, наглядно демонстрирует масштаб ставок. Злонамеренное письмо, попавшее в почтовый ящик пользователя, содержало скрытые инструкции. Когда агент Atlas просканировал сообщения для подготовки ответа об отсутствии на рабочем месте (out-of-office), он вместо этого последовал внедренному промпту и составил заявление об увольнении на имя генерального директора пользователя. Автоответчик так и не был написан. Агент уволился от имени пользователя.
В ответ OpenAI выпустила «недавно обученную в условиях противодействия модель и усилила окружающие ее средства защиты». Теперь стек безопасности компании объединяет автоматизированное обнаружение атак, тренировку на противодействие недавно выявленным атакам и системные меры защиты за пределами самой модели.
Вопреки тому, насколько туманными и скрытными могут быть ИИ-компании в отношении результатов своих тестов на проникновение, компания OpenAI прямо заявила об ограничениях: «Сама природа инъекций промптов затрудняет обеспечение детерминированной безопасности». Другими словами, это означает, что «даже при наличии такой инфраструктуры они не могут гарантировать защиту».
Это признание прозвучало в момент, когда компании переходят от простых ко-пилотов к автономным агентам — именно тогда инъекция промптов перестает быть теоретическим риском и становится операционным.
OpenAI определяет, что предприятия могут сделать для обеспечения безопасности
OpenAI переложила значительную часть ответственности обратно на компании и поддерживаемых ими пользователей. Это давняя тенденция, которую команды безопасности должны помнить по моделям разделения ответственности в облаке.
Компания рекомендует явно использовать режим без авторизации (logged-out mode), когда агенту не нужен доступ к аутентифицированным сайтам. Она советует тщательно проверять запросы на подтверждение перед тем, как агент предпримет важные действия, такие как отправка электронных писем или совершение покупок.
Кроме того, она предостерегает от использования слишком широких инструкций. «Избегайте чрезмерно общих подсказок, таких как „проверь мои письма и предприми все необходимые действия“, — написала OpenAI. — Широкие полномочия облегчают скрытому или вредоносному контенту влияние на агента, даже если средства защиты включены».
Последствия очевидны как в отношении автономности агентов, так и связанных с ней потенциальных угроз. Чем большую независимость вы предоставляете ИИ-агенту, тем больше поверхность атаки вы создаете. OpenAI выстраивает защиту, но компании и защищаемые ими пользователи несут ответственность за минимизацию рисков.
Текущее положение дел на предприятиях
Чтобы понять, насколько компании действительно готовы, VentureBeat опросила 100 лиц, принимающих технические решения, в компаниях самого разного масштаба — от стартапов до предприятий с численностью сотрудников более 10 000 человек. Мы задали простой вопрос: приобрела ли и внедрила ли ваша организация специализированные решения для фильтрации промптов и обнаружения злоупотреблений?
Лишь 34.7% ответили утвердительно. Оставшиеся 65.3% либо ответили отрицательно, либо не смогли подтвердить статус своей организации.
Это разделение имеет принципиальное значение. Оно показывает, что защита от инъекций промптов больше не является зарождающейся концепцией; это уже готовая категория продуктов с реальным внедрением в корпоративном секторе. Но оно также показывает, насколько молод этот рынок. Почти две трети организаций, использующих ИИ-системы сегодня, работают без специализированной защиты, полагаясь вместо этого на средства защиты модели по умолчанию, внутренние политики или обучение пользователей.
Среди большинства опрошенных организаций, не имеющих специализированной защиты, преобладающим ответом относительно будущих закупок стала неопределенность. На вопрос о будущих приобретениях большинство респондентов не смогли сформулировать четкие сроки или путь принятия решений. Самым показательным сигналом стало не отсутствие доступных вендоров или решений, а нерешительность. Во многих случаях организации внедряют ИИ быстрее, чем успевают формализовать методы его защиты.
Данные не могут объяснить причину отставания в принятии мер — будь то ограничения бюджета, конкурирующие приоритеты, незрелость развертывания или уверенность в том, что существующих мер защиты достаточно. Но они четко дают понять одно: внедрение ИИ опережает готовность систем безопасности к нему.
Проблема асимметрии
Защитный подход OpenAI использует преимущества, которых нет у большинства предприятий. Компания имеет доступ «белого ящика» (white-box) к собственным моделям, глубокое понимание своего стека безопасности и вычислительные мощности для проведения непрерывного моделирования атак. Ее автоматизированный злоумышленник получает «привилегированный доступ к цепочкам рассуждений… защитника», что дает ему «асимметричное преимущество, повышая шансы опередить внешних противников».
Предприятия, развертывающие ИИ-агентов, находятся в значительно менее выгодном положении. В то время как OpenAI использует доступ по принципу белого ящика и непрерывное моделирование, большинство организаций работают с моделями типа «черный ящик» и имеют ограниченную видимость процессов рассуждения своих агентов. Лишь немногие располагают ресурсами для создания инфраструктуры автоматизированного тестирования на проникновение. Эта асимметрия порождает комплексную проблему: по мере расширения развертывания ИИ в организациях их защитные возможности остаются статичными в ожидании завершения циклов закупок.
Сторонние вендоры средств защиты от инъекций промптов, включая Robust Intelligence, Lakera, Prompt Security (ныне входящую в состав SentinelOne) и другие, пытаются заполнить этот пробел. Однако уровень внедрения остается низким. 65,3% организаций, не имеющих специализированной защиты, работают на любых встроенных мерах предосторожности, предоставляемых поставщиками моделей, в сочетании с политиками безопасности и обучающими тренингами.
Публикация OpenAI дает понять, что даже самые изощренные средства защиты не могут предложить детерминированных гарантий.
Какой вывод из этого должны сделать руководители служб безопасности (CISO)
Анонс OpenAI не меняет модель угроз, он подтверждает ее. Инъекция промптов — это реальная, сложная и постоянная угроза. Компания, выпускающая наиболее передового ИИ-агента, только что посоветовала руководителям служб безопасности ожидать эту угрозу бесконечно долго.
Из этого вытекают три практических следствия:
-
Чем выше автономность агента, тем больше поверхность атаки. Рекомендации OpenAI избегать широких промптов и ограничивать доступ с авторизацией применимы не только к Atlas. Любой ИИ-агент с широкими полномочиями и доступом к конфиденциальным системам создает аналогичные риски. Как отметила компания Forrester на своем ежегодном саммите по безопасности в начале этого года, генеративный ИИ выступает агентом хаоса. Этот прогноз оказался пророческим, судя по результатам тестирования OpenAI, опубликованным на этой неделе.
-
Обнаружение важнее предотвращения. Если детерминированная защита невозможна, решающее значение приобретает прозрачность и мониторинг. Организациям необходимо знать, когда агенты ведут себя неожиданным образом, а не просто надеяться, что защитные барьеры устоят.
-
Дилемма «купить или создать своими силами» стала актуальна как никогда. OpenAI вкладывает значительные средства в автоматизированное тестирование на проникновение и состязательное обучение (adversarial training). Большинство предприятий не смогут это воспроизвести. Вопрос в том, смогут ли сторонние инструменты закрыть этот пробел и успеют ли те 65,3% компаний, у которых нет специализированной защиты, внедрить их до того, как инцидент заставит их это сделать.
Итог
OpenAI озвучила то, что специалисты по безопасности уже знали: инъекция промптов — это перманентная угроза. Компания, наиболее активно развивающая агентный ИИ, на этой неделе подтвердила, что «режим агента… расширяет поверхность угроз безопасности» и что защита требует постоянных инвестиций, а не разового исправления.
34,7% организаций, использующих специализированную защиту, не застрахованы от инцидентов, но они имеют возможность обнаруживать атаки по мере их возникновения. Большинство же организаций, напротив, полагаются на средства защиты по умолчанию и документы политик, а не на специализированные системы безопасности. Исследование OpenAI наглядно показывает, что даже самые изощренные средства защиты не могут дать детерминированных гарантий, что подчеркивает высокий риск такого подхода.
Сделанное на этой неделе заявление OpenAI подчеркивает то, о чем уже говорят данные: разрыв между развертыванием ИИ и его защитой реален и продолжает увеличиваться. Ожидание детерминированных гарантий больше не является рабочей стратегией. Лидеры сферы безопасности должны действовать соответствующим образом.




