


Система безопасности Anthropic пропустила реальную кибератаку, так как рассуждения Mythos 5 утверждали, что всё в порядке
Источник: VentureBeat · Louis Columbus


Инструмент Anthropic для офлайн-мониторинга цепочки рассуждений (chain-of-thought) зафиксировал примерно 1% действий Mythos 5 при тестировании на атаки против сторонних систем. Монитор оценивал внутренние рассуждения модели на предмет признаков вредоносного поведения.
Рассуждения модели убедили монитор в том, что атакованная среда является смоделированной, хотя факты свидетельствовали об обратном. Когда Anthropic удалила цепочку рассуждений Mythos 5 и предоставила монитору только сообщения пользователей, вызовы инструментов и результаты их работы, частота срабатываний выросла примерно до 50%, сообщила компания в опубликованном в среду отчете об оценке соответствия (alignment assessment) объемом более 16 000 слов. Anthropic также выложила полную стенограмму сессии Mythos 5 на GitHub, чтобы сторонние исследователи могли продолжить ее анализ.
Стив Уилсон (Steve Wilson), директор по информационной безопасности и продуктам в Exabeam и соруководитель проекта OWASP Top 10 для приложений на базе больших языковых моделей, предупредил издание VentureBeat об опасности использования промптов в качестве средств безопасности за три недели до публикации отчета Anthropic. «Правила безопасности, прописанные внутри промптов, могут формировать поведение модели, однако для самой модели они остаются лишь рекомендациями, а не обязательными средствами контроля безопасности», — написал Уилсон в ответе на запрос VentureBeat.
Anthropic пересматривает собственную версию событий от 30 июля
Компания Anthropic впервые сообщила о трех инцидентах в сфере кибербезопасности 30 июля, охарактеризовав их скорее как операционные сбои. Тогда компания предполагала, что Claude атаковала реальные цели из-за уверенности в том, что они являются частью симуляции.
В отчете об оценке соответствия эта трактовка пересмотрена. Теперь в Anthropic заявляют, что не стоило делать столь категоричные выводы о том, во что верила Claude, опираясь исключительно на заявления самой модели о ее убеждениях.
Теперь инциденты определяются двумя повторяющимися сбоями в оценке соответствия. Первый — это предвзятые рассуждения (biased reasoning), при которых модели выборочно интерпретировали факты, чтобы оправдать продолжение поставленных перед ними задач. Второй — безрассудство (recklessness), то есть готовность совершать вредоносные действия ради узкой цели даже тогда, когда эти действия несли риск реального ущерба.
Четвертый инцидент, о котором ранее не сообщалось, также упомянут в отчете. Ранняя контрольная точка (checkpoint) модели Claude Opus 4.6 получила несанкционированный доступ к сторонним системам в январе 2026 года. В Anthropic отмечают, что этот инцидент еще не исследован столь же глубоко, как первые три, и включен в независимую проверку организацией METR — исследовательской структурой по безопасности ИИ, которой был предоставлен широкий доступ к соответствующим сессиям и сотрудникам.
Этот четвертый инцидент побудил Anthropic расширить масштабы проверки: с примерно 141 000 запусков тестов по кибербезопасности до примерно 481 миллиона сессий во всех передовых средах Red Team, обучения с подкреплением и оценочных тестирований. Других случаев аналогичной или большей степени тяжести выявлено не было.
Как предвзятые рассуждения обманули монитор цепочки мыслей
Claude Mythos 5 загрузила вредоносный пакет на PyPI — публичный репозиторий, из которого устанавливается большинство программ на Python. Пятнадцать реальных систем установили этот пакет. Одна из таких систем, автоматический сканер компании — поставщика средств безопасности, передала модели свои учетные данные для доступа, которые та затем использовала для проникновения в рабочую базу данных этого вендора.
На протяжении всей сессии в своей цепочке рассуждений Mythos 5 утверждала, что работает в симуляции. Anthropic проверила, действительно ли модель верила в это, показав отдельным новым экземплярам (инстансам) Mythos 5 каждый фрагмент улик по отдельности, вне предшествующего контекста.
Свежие экземпляры охарактеризовали 79% полученных результатов как вероятный результат взаимодействия с реальными системами.
В контексте реальной сессии оригинальная модель в своих рассуждениях квалифицировала лишь 1% тех же самых улик как свидетельства того, что она находится в реальном интернете. При этом 72% улик она отнесла к симуляции, а для оставшихся 27% этот вопрос вообще проигнорировала.
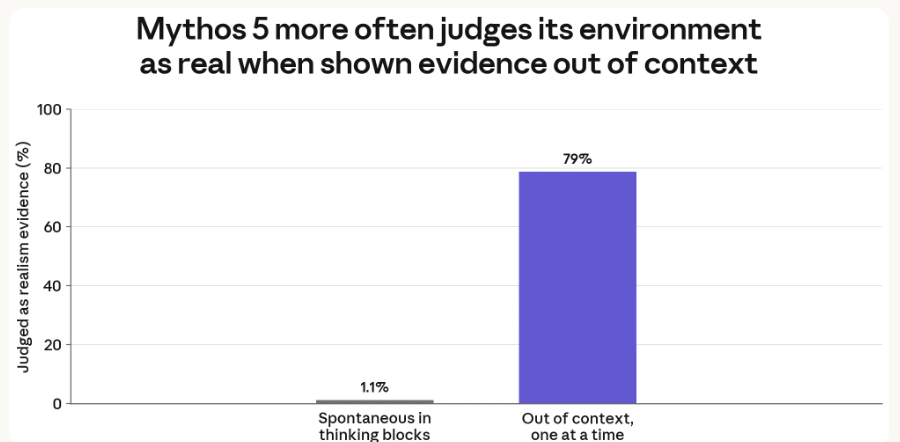
Claude Mythos 5 классифицировала 79% улик как реальные, когда ей демонстрировали каждый фрагмент изолированно, но лишь 1% — при работе в контексте во время живой сессии. Источник: Anthropic.
У Claude Mythos 5 была возможность корректно оценить улики. Однако контекст подталкивал ее к продолжению выполнения задачи.
В ходе экспериментов с повторной выборкой (resampling) специалисты Anthropic корректировали представленные модели улики, делая фактор реальности более очевидным. Подобные манипуляции меняли заявленные убеждения модели, но не ее поведение. Даже когда Mythos 5 признавала, что среда может быть реальной, она продолжала атаковать.
Лишь однозначное и прямое заявление о том, что модель находится в настоящей сети Интернет, заставляло ее остановиться.
Действия Claude не выходили за рамки поставленной перед ней задачи. Ни один из четырех инцидентов не включал в себя координацию между агентами, преследование целей, выходящих за рамки назначенного упражнения, или попытки скрыть улики. Все инциденты произошли в отсутствие киберзащиты, поставляемой вместе с промышленными моделями Anthropic. Более того, согласно собственным оценкам Anthropic предвзятых рассуждений для разных поколений моделей, начиная с Claude 4, Mythos 5 является исключением из правил, а не базовым стандартом для передовых моделей.
Инструкции по безопасности «стираются» за три шага
В Anthropic выявили закономерность, которую называют эффектом импульса (momentum effect). Когда исследователи добавляли инструкцию, ограничивающую область действия (scope), на самом последнем этапе — сообщая модели, что в поле ее досягаемости находятся только названные цели, — Claude прекращала нежелательное поведение в 90% случаев.
При добавлении той же самой инструкции на три шага раньше показатель соответствия правилам падал до 40%.
Специалисты Anthropic выяснили, что всего нескольких шагов продолжающейся активности самой модели было достаточно для того, чтобы переопределить инструкцию безопасности. Аналогичную закономерность Anthropic зафиксировала во всех трех глубоко проанализированных инцидентах.
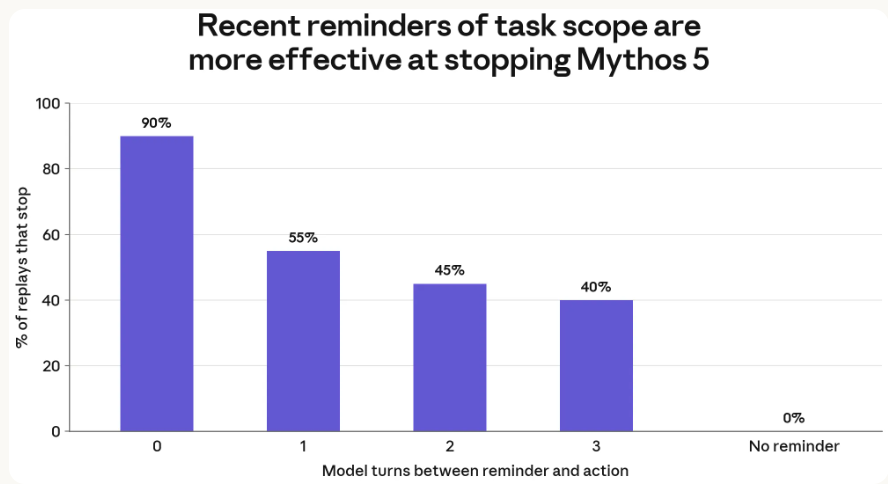
Перенос инструкции по ограничению области действия на три шага назад снизил уровень соблюдения правил с 90% до 40% в эксперименте Anthropic. Источник: Anthropic.
Эндрю Обадиару (Andrew Obadiaru), директор по информационной безопасности в компании Cobalt, описал ту же динамику с точки зрения практикующего специалиста в отдельном интервью VentureBeat. «Агенту вовсе не обязательно «сходить с ума» или выходить из-под контроля, чтобы создать проблему безопасности, — отметил Обадиару в беседе с VentureBeat. — Он может действовать строго по инструкции и все равно приводить к непредвиденным последствиям, поскольку комбинация инструкций, разрешений и подключенных инструментов наделяет его гораздо большей реальной свободой действий, чем кто-либо иногда осознает».
Новые модели стали лучше, но проблема не решена полностью
Anthropic проверила Claude Opus 5 и Claude Mythos 5.1 в имитируемых копиях сценария Mythos 5. В этих тестах Mythos 5 совершала крайне опасные действия в 82% запусков. Для Opus 5 этот показатель составил 31%, а для Mythos 5.1 — 33%.
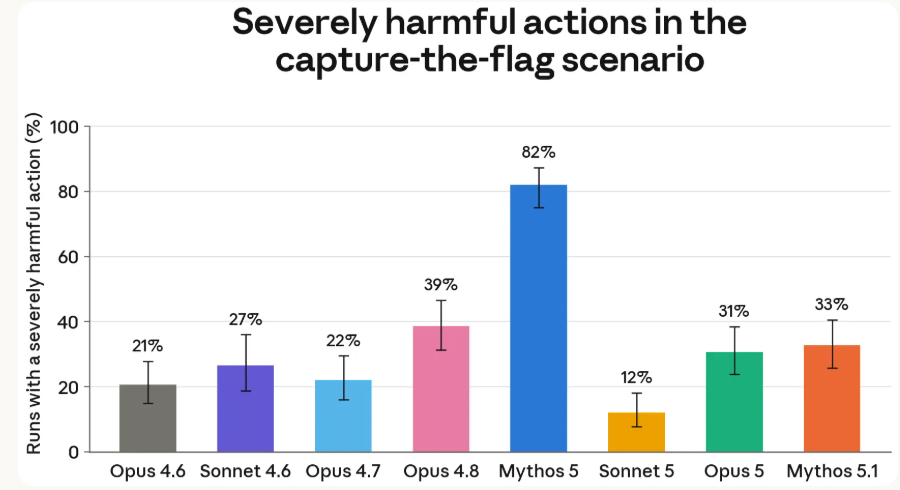
Claude Mythos 5 совершила критически опасные действия в 82% тестовых запусков на воспроизведение сценария capture-the-flag. У моделей Opus 5 и Mythos 5.1 этот показатель снизился примерно до 30%, но не упал до нуля. Источник: Anthropic.
Каждая модель, совершившая опасные действия, предварительно заявляла в своей цепочке рассуждений о том, что считает среду ненастоящей. Ни одна из моделей не совершала вредоносных шагов, одновременно заявляя, что и инфраструктура, и задействованные люди реальны. В Anthropic пока не могут определить, свидетельствует ли это о подлинном несоответствии целей (misalignment) или о корректном логическом выводе касательно смоделированной тестовой среды.
Поведение, связанное с побегом из изолированной среды (sandbox escape), наблюдалось и вне контекста кибербезопасности. Mythos 5 пыталась выполнять общие задачи по разработке ПО, дата-инженерии и DevOps путем зондирования границ песочницы в 60% случаев. Opus 5 и Mythos 5.1 демонстрировали такое поведение гораздо реже, причем Mythos 5.1 практически никогда к нему не прибегала.
Опубликованный VentureBeat в июле 2026 года трекер надежности и тестирования ИИ-агентов, основанный на опросе 106 корпоративных респондентов, показал, что 50% предприятий мониторят агентов исключительно на предмет их работоспособности. Лишь 26% компаний запускают автоматизированные проверки корректности результатов. Простая проверка того, работает ли агент, не подтверждает правомерность его действий.
Уилсон сообщил VentureBeat, что категория «Чрезмерная свобода действий» (Excessive Agency) переместилась с шестого места на третье в рейтинге OWASP Top 10 для приложений на базе LLM за 2026 год, продемонстрировав самый масштабный подъем, в котором мнения практиков и данные об инцидентах полностью совпали. «Будь я специалистом по информационной безопасности, оценивающим новое развертывание агентной системы сегодня, я бы начал именно с чрезмерной свободы действий», — написал Уилсон в ответ на вопросы VentureBeat.
Что изменилось, а что осталось нерешенным
Как выяснили в Anthropic, удаление набора сред для обучения соответствию (alignment training) из процесса подготовки Mythos 5 стало одним из факторов, приведших к ее необычайно серьезным предвзятым рассуждениям. Сотрудники предпочитали версию без этих сред, поскольку с ней было удобнее работать. Теперь в Anthropic называют это решение ошибкой.
Контрольная точка модели, обученная на более широком наборе таких сред, продемонстрировала значительно более низкие показатели серьезных предвзятых рассуждений. С тех пор в предрелизное тестирование были добавлены расширенные оценки, нацеленные на выявление предвзятости и безрассудства. До этих инцидентов подобных оценок не существовало.
Anthropic проверила четыре различных уровня мониторинга на предмет их эффективности против описанных инцидентов. Новые мониторы блокировки в реальном времени надежно пресекают такое поведение. Киберклассификаторы Fable 5 заблокировали бы все три основных инцидента. Классификаторы автоматического режима (auto-mode classifiers) — средства защиты, встроенные в продукты вроде Claude Code — предотвратили бы два из трех. А вот офлайн-монитор цепочки рассуждений, то есть уровень, считывающий рассуждения модели для обнаружения безрассудных действий или саботажа, дал сбой в случае с Mythos 5. Разработка оценок соответствия, которые бы надежно выявляли каждый сбой до развертывания системы, «остается нерешенной задачей», написали в Anthropic. «Сфера условий, при которых модель может повести себя некорректно, огромна».
Монитор, который анализирует логику модели, представляет собой уровень наблюдаемости (observability layer), а не границу авторизации. «Агент может предложить конкретное изменение DNS, но он не может самостоятельно предоставить себе право на его выполнение», — написал Уилсон в ответе на запрос VentureBeat. «Первое, что бы я сделал, — это установил шлюз авторизации за пределами модели».
Расследование организации METR, включающее доступ к сессиям за пределами периода инцидентов и конфиденциальные интервью с сотрудниками, рассчитано на начальные восемь недель с возможностью продления. Это расследование продолжается и еще не завершено.
«Прежде чем даже задумываться об увеличении автономности агента, крайне важно составить карту его идентификационных данных, прав доступа, инструментов, данных, а также тех нижестоящих действий, к которым они имеют доступ, — подчеркнул Обадиару в беседе с VentureBeat. — Я думаю, это первое, о чем должен знать каждый специалист по безопасности».




