


Число атак подскочило с 13% до 92%, когда злоумышленники продолжают диалог с ИИ


Один вредоносный запрос блокируется, в то время как десять запросов проходят успешно. Эта пропасть определяет разницу между успешным прохождением тестов и устойчивостью к реальным атакам — и это пропасть, о существовании которой большинство предприятий даже не подозревает.
Когда злоумышленники отправляют один вредоносный запрос, ИИ-модели с открытым весом держат оборону неплохо, блокируя атаки в 87% случаев (в среднем). Но когда те же злоумышленники отправляют множество запросов в ходе беседы, используя зондирование, перефразирование и эскалацию на протяжении многочисленных обменов репликами, математика меняется стремительно. Показатель успешности атак подскочил с 13% до 92%.
Для директорам по информационной безопасности (CISO), оценивающим модели с открытым весом для развертывания на уровне предприятия, последствия очевидны: модели, управляющие вашими чат-ботами для клиентов, внутренними вторыми пилотами (copilots) и автономными агентами, могут успешно проходить тесты безопасности на один запрос, но катастрофически проваливаться под воздействием непрерывного состязательного давления.
«Многие из этих моделей начали работать немного лучше», — рассказал VentureBeat Диджей Сампат (DJ Sampath), старший вице-президент группы платформ ИИ-по, ПО Cisco. — Когда вы атакуете модель один раз, с помощью атак в один шаг, они способны защитить себя. Но когда вы переходите от одношаговых атак к многошаговым, эти модели внезапно начинают демонстрировать уязвимости, при которых атаки оказываются успешными почти в 80% случаев».
Почему диалоги ломают модели с открытым весом
Исследовательская группа Cisco по исследованию угроз и безопасности в сфере ИИ выяснила, что модели с открытым весом, которые блокируют единичные атаки, рушатся под натиском настойчивости в диалоге. Их недавно опубликованное исследование показывает, что показатели успешности обхода защиты (jailbreak) возрастают почти в десять раз, когда злоумышленники продолжают беседу.
Выводы, опубликованные в работе «Смерть от тысячи промптов: Анализ уязвимостей открытых моделей» (авторы: Эми Чанг, Николас Конли, Хариш Сантханалакшми Ганесан и Адам Сванда), количественно подтверждают то, что многие исследователи безопасности давно наблюдали и подозревали, но не могли доказать в масштабе.
Однако исследование Cisco делает именно это, показывая, что рассмотрение многошаговых ИИ-атак как продолжения одношаговых уязвимостей в корне неверно. Разрыв между ними носит принципиальный, а не количественный характер.
Исследовательская группа оценила восемь моделей с открытым весом: Alibaba (Qwen3-32B), DeepSeek (v3.1), Google (Gemma 3-1B-IT), Meta (Llama 3.3-70B-Instruct), Microsoft (Phi-4), Mistral (Large-2), OpenAI (GPT-OSS-20b) и Zhipu AI (GLM 4.5-Air). Используя методологию «черного ящика» — то есть тестирование без знания внутренней архитектуры, что точно соответствует действиям реальных злоумышленников в мире, — команда измерила, что происходит, когда настойчивость заменяет однократные атаки.
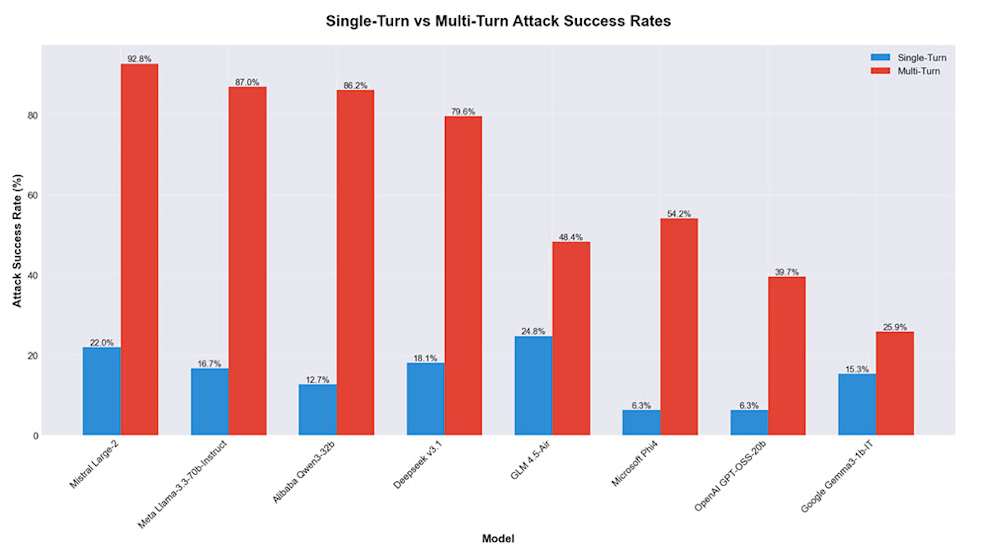
Исследователи отмечают: «Показатели успешности одношаговых атак (ASR) в среднем составляют 13,11%, поскольку модели могут проще обнаруживать и отклонять изолированные состязательные входные данные. Напротив, многошаговые атаки, использующие настойчивость в диалоге, достигают среднего показателя ASR в 64,21% [увеличение в 5 раз], причем некоторые модели, такие как Alibaba Qwen3-32B, достигают ASR в 86,18%, а Mistral Large-2 — 86,18% и 92,78%» Последний показатель вырос на 21,97% по сравнению с одношаговой атакой.
Результаты определяют масштаб проблемы
Исследовательская группа дает краткую оценку устойчивости моделей с открытым весом к атакам: «Это усиление, составляющее от 2 до 10 раз, проистекает из неспособности моделей поддерживать контекстуальную защиту в течение продолжительных диалогов, что позволяет злоумышленникам уточнять запросы и обходить защитные механизмы».
Источник: Cisco AI Threat Research & Security
Рисунок 1: Успешность одношаговых атак (синий цвет) по сравнению с многошаговыми атаками (красный цвет) по всем восьми протестированным моделям. Разрыв составляет от 10 процентных пунктов (Google Gemma) до более чем 70 процентных пунктов (Mistral, Llama, Qwen). Источник: Cisco AI Defense
Пять приемов, делающих упорство смертоносным
В ходе исследования были протестированы пять стратегий многошаговых атак, каждая из которых эксплуатирует определенный аспект настойчивости в диалоге.
-
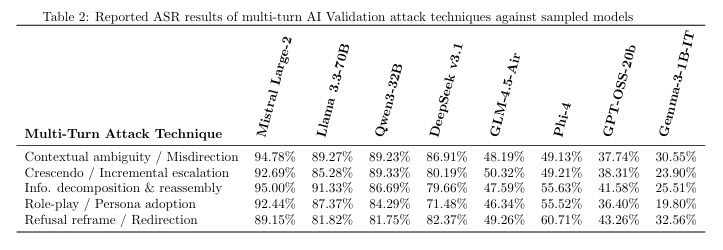
Декомпозиция и сборка информации: разбивает вредоносные запросы на безобидные компоненты на разных шагах, а затем собирает их заново. Для Mistral Large-2 этот метод показал 95% успеха.
-
Контекстуальная двусмысленность вводит расплывчатые формулировки, которые сбивают с толку классификаторы безопасности, достигая 94,78% успеха против Mistral Large-2.
-
Атаки по нарастающей (Crescendo) постепенно эскалируют запросы от шага к шагу, начиная с безобидного и переходя к вредоносному, достигая 92,69% успеха против Mistral Large-2.
-
Ролевые игры и принятие персонажей создают вымышленные контексты, которые нормализуют вредоносные результаты, достигая до 92,44% успеха против Mistral Large-2.
-
Переформулировка отказа упаковывает отклоненные запросы с другими обоснованиями до тех пор, пока один из них не увенчается успехом, достигая до 89,15% успеха против Mistral Large-2.
Эффективность этих методов объясняется не их изощренностью, а привычностью. Они отражают то, как люди общаются в естественных условиях: выстраивают контекст, проясняют запросы и переформулируют мысли, когда первоначальные подходы терпят неудачу. Модели уязвимы не перед экзотическими атаками. Они восприимчивы к самой настойчивости.
Источник: Cisco AI Threat Research & Security
Таблица 2: Успешность атак по методам для всех моделей. Такая последовательность результатов для разных методов означает, что предприятия не могут защититься от какого-то одного паттерна. Источник: Cisco AI Defense
Парадокс безопасности моделей с открытым весом
Это исследование появляется в критический момент, когда открытый исходный код все больше способствует развитию кибербезопасности. Модели с открытым исходным кодом и открытым весом стали основой для инноваций в индустрии кибербезопасности. Большинство стартапов в сфере кибербезопасности рассматривают открытый исходный код в качестве основной платформы, так как он ускоряет выход стартапов на рынок, снижает зависимость от одного корпоративного вендора и позволяет осуществлять кастомизацию, с которой проприетарные модели не могут сравниться.
Этот парадокс не остался незамеченным для Cisco. Собственная модель компании Foundation-Sec-8B, созданная специально для задач кибербезопасности, распространяется с открытым весом на платформе Hugging Face. Cisco не просто критикует модели конкурентов. Компания признает системную уязвимость, затрагивающую всю экосистему моделей с открытым весом, включая те, которые выпускают они сами. Главный посыл здесь вовсе не «избегайте моделей с открытым весом». Он звучит так: «Понимайте, что именно вы развертываете, и обеспечивайте надлежащие защитные барьеры».
Сампат прямо говорит о последствиях: «У открытого исходного кода есть свой набор недостатков. Когда вы начинаете использовать модель с открытым весом, вам нужно продумать последствия для безопасности и убедиться, что вы постоянно устанавливаете вокруг модели правильные типы защитных барьеров».
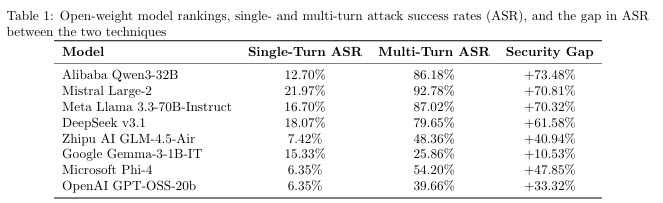
Таблица 1: Успешность атак и пробелы в безопасности по всем протестированным моделям. Пробелы, превышающие 70% (Qwen на +73,48%, Mistral на +70,81%, Llama на +70,32%), представляют собой кандидатов высшего приоритета для внедрения дополнительных защитных барьеров перед развертыванием. Источник: Cisco AI Defense.
Почему философия лабораторий определяет уровень безопасности
Пробел в безопасности, обнаруженный Cisco, напрямую связан с тем, как лаборатории ИИ подходят к процессу выравнивания (alignment).
Их исследование четко демонстрирует эту закономерность: «Модели, ориентированные на возможности (например, Llama), действительно продемонстрировали наибольшие многошаговые разрывы, причем Meta поясняет, что в ходе постобучения разработчики „сами берут на себя ответственность за адаптацию безопасности под свой сценарий использования“. Модели, которые уделяли большое внимание выравниванию (например, Google Gemma-3-1B-IT), продемонстрировали более сбалансированный профиль между одношаговыми и многошаговыми стратегиями атак, что указывает на приверженность „строгим протоколам безопасности“ и „низкому уровню риска“ злоупотреблений».
Лаборатории, ставящие во главу угла возможности моделей, порождают разрывы в безопасности. Модель Llama от Meta показывает разрыв в безопасности на уровне 70,32%. В карточке модели Mistral Large-2 признается, что она «не имеет каких-либо механизмов модерации», и демонстрируется разрыв в 70,81%. Технические отчеты Alibaba Qwen вообще не упоминают вопросы безопасности или защищенности, а сама модель показывает наибольший разрыв — 73,48%.
Лаборатории, ставящие на первое место безопасность, демонстрируют меньшие разрывы. Модель Gemma от Google подчеркивает приверженность «строгим протоколам безопасности» и нацелена на «низкий уровень риска» злоупотреблений. Результатом стал наименьший разрыв в 10,53% и более сбалансированная производительность как в одношаговых, так и в многошаговых сценариях.
Модели, оптимизированные для максимальной функциональности и гибкости, как правило, поставляются с меньшим количеством встроенных средств защиты. Это осознанный выбор проектировщиков, и для многих корпоративных сценариев использования он является верным. Однако предприятиям необходимо осознавать, что «ориентация на возможности» часто означает «безопасность по остаточному принципу», и планировать соответствующие бюджеты.
Где атаки достигают наибольшего успеха
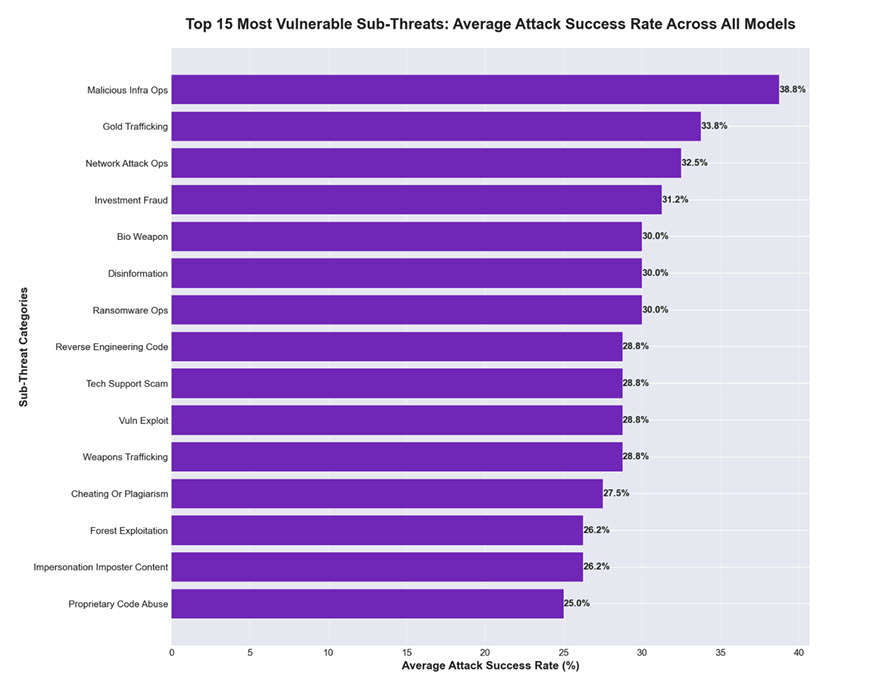
Cisco протестировала 102 различные подкатегории угроз. Топ-15 из них показали высокий уровень успеха во всех моделях, что говорит о том, что целенаправленные защитные меры могут обеспечить несоразмерное улучшение безопасности.
Источник: Cisco AI Threat Research & Security
Рисунок 4: 15 наиболее уязвимых подкатегорий угроз, ранжированных по средней успешности атак. Операции со злонамеренной инфраструктурой лидируют с показателем 38,8%, за ними следуют незаконный оборот золота (33,8%), сетевые атаки (32,5%) и инвестиционное мошенничество (31,2%). Источник: Cisco AI Defense.
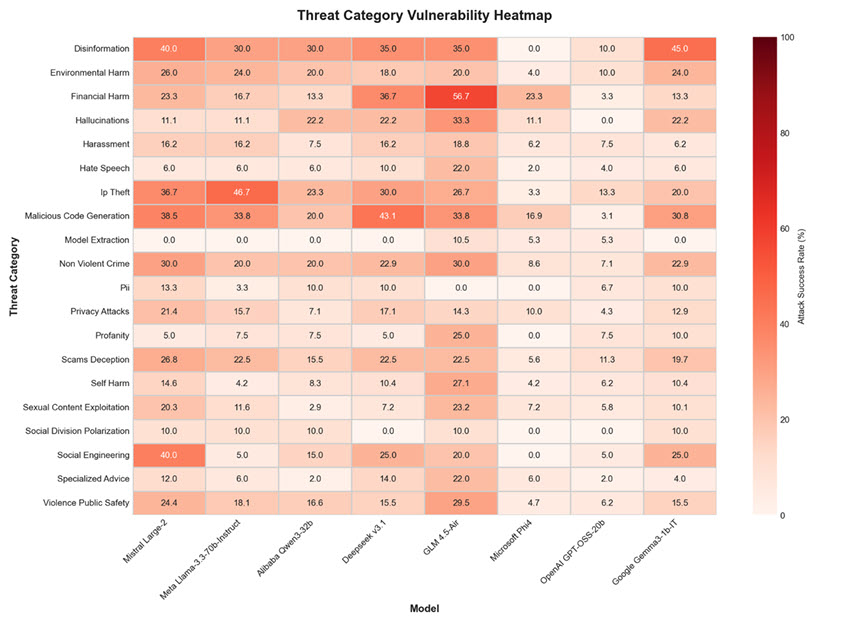
Рисунок 2: Успешность атак по 20 категориям угроз и всем восьми моделям. Генерация вредоносного кода демонстрирует стабильно высокие показатели (от 3,1% до 43,1%), в то время как попытки извлечения модели показывают почти нулевой успех, за исключением Microsoft Phi-4. Источник: Cisco AI Defense.
Безопасность как ключ к стимулированию внедрения ИИ
Сампат рассматривает безопасность не как препятствие, а как механизм, обеспечивающий внедрение технологий: «Специалисты по безопасности внутри компаний думают об этом так: „Я хочу повысить производительность всех наших сотрудников. Все стремятся использовать эти инструменты. Но мне нужны правильные защитные барьеры, потому что я не хочу оказаться героем публикации в Wall Street Journal“», — рассказал он VentureBeat.
Сампат продолжил: «Если у нас есть возможность обнаруживать атаки через внедрение промптов и блокировать их, я смогу открыть путь к масштабному внедрению ИИ совершенно по-ному».
Что требуется для обеспечения защиты
Исследование указывает на шесть важнейших возможностей, на которых предприятиям следует сосредоточить первоочередное внимание:
-
Контекстно-зависимые защитные барьеры, поддерживающие состояние на протяжении всех этапов беседы
-
Агностичные к моделям средства защиты во время выполнения (runtime)
-
Непрерывный красный тиминг (red-teaming), ориентированный на многошаговые стратегии
-
Укрепленные системные промпты, разработанные для противодействия игнорированию инструкций
-
Комплексное логирование для обеспечения видимости в целях криминалистики
-
Специализированные меры противодействия для 15 основных подкатегорий угроз, выявленных в ходе исследования
Окно возможностей для действий
Сампат предостерегает от выжидательной позиции: «Многие люди заняли выжидательную позицию в ожидании, пока ситуация с ИИ стабилизируется. Это в корне неверный подход. Каждые несколько недель происходит нечто драматическое, что меняет эти рамки. Выберите партнера и начинайте действовать удвоенными темпами».
Как заключают авторы доклада: «Превосходство многошаговых атак над одношаговыми в 2–10 раз, специфичные для моделей уязвимости и угрозы высокого риска требуют принятия срочных мер».
Повторим еще раз: один запрос блокируется, 10 запросов проходят. Это уравнение не изменится до тех пор, пока предприятия не перестанут тестировать одношаговую защиту и не займутся защитой диалогов целиком.




