Новый фреймворк MIT и Sakana AI использует LLM-судью, чтобы снизить затраты на оценку самосовершенствующихся ИИ-агентов для программирования


Агенты для программирования могут совершенствоваться, если менять подсказки, инструменты и код, которые направляют их работу. Но определить, какие изменения действительно помогают и заслуживают того, чтобы их сохранить, сложно и дорого.
Каждое изменение-кандидат нужно тестировать, а поиск среди множества вариантов может потребовать тысячи часов процессорного времени и обойтись в тысячи долларов.
Рекурсивное самоусовершенствование с помощью быстрого поиска по дереву (SIFT) — фреймворк, разработанный исследователями из MIT и Sakana AI, — призван сократить расходы на оценку. Перед запуском дорогостоящих тестов на бенчмарках он использует отдельную языковую модель для сравнения агентов-кандидатов. Кроме того, система может предлагать новые изменения, пока предыдущие кандидаты всё ещё проходят оценку. Благодаря этому поиск исследует несколько ветвей, не дожидаясь полного тестирования после каждого исправления.
По данным исследователей, один запуск SIFT достиг точности 35,1% на бенчмарке для программирования Polyglot менее чем за пять часов реального времени, использовав 42 часа процессорного времени и около 150 долларов в виде кредитов API.
Для команд, настраивающих обвязки агентов для программирования под чётко определённые задачи, SIFT предлагает способ избирательнее расходовать ресурсы на дорогостоящие оценки, а не прогонять каждый вариант через полный набор тестов.
Каждое улучшение нужно проверять
Инженеры могут настраивать инструкции для агента-программиста, добавлять инструменты или менять его реакцию на ошибки. Но ручная настройка требует времени специалистов и ограничивает поиск идеями, которые приходят людям в голову. Рекурсивное самоусовершенствование автоматизирует часть этого процесса, позволяя системе изменять собственный исходный код.
В цикле самоусовершенствования агент анализирует ошибки и предлагает исправление для своей обвязки. Обновлённый агент выполняет целевые задачи, а его результат помогает определить, какая версия станет отправной точкой для следующего исправления. Поскольку исправление меняет систему, которая будет предлагать или выполнять последующую работу, улучшения могут накапливаться.
В более ранних подходах этот поиск организован по-разному. Darwin Gödel Machine (DGM) ведёт архив агентов и проверяет кандидатов на всё более крупных наборах задач: сначала на 10 задачах, затем на 50, а полный бенчмарк Polyglot оставляет для итоговой оценки. Huxley-Gödel Machine (HGM) учитывает, как агент и его потомки справляются с задачами, когда система выбирает, где продолжить поиск. При оценке кандидатов она меняет число случайно выбранных задач.
Главная сложность — стоимость проверки изменений обвязки агента. Согласно разбивке расходов в статье, предложение исправления обходится примерно в 12 центов. Вызов модели-судьи для парного сравнения стоит около 4,4 цента, а SIFT использует до 10 таких вызовов на кандидата — то есть до 44 центов. Оценка агента на 50 задачах Polyglot стоит около 6 долларов и требует 2,6 часа процессорного времени.
Проверить изменение-кандидат всего на нескольких задачах дёшево, но результат может вводить в заблуждение: агенту могли достаться необычно простые или сложные задачи. Большой набор тестов даёт командам более надёжную основу для выбора версии, которую стоит улучшать дальше, но выполнение дополнительных задач требует времени и денег.
Как отмечают авторы, узкое место — «невыгодное соотношение информативности и стоимости существующих методов оценки».
Как работает SIFT
SIFT использует обвязку агента из DGM, но добавляет в процесс поиска более дешёвый источник обратной связи. В основе метода лежит предположение, что языковая модель может сравнить две версии агента и определить, какая, вероятнее всего, покажет лучший результат, даже до того, как новый кандидат пройдёт большой запуск на бенчмарке.
После того как SIFT создаёт модифицированного агента, система запускает новую версию на четырёх задачах по программированию. Эта быстрая проверка выявляет изменения, которые ломают агента или мешают ему решать базовые задачи, — до того, как система потратит больше ресурсов на его сравнение и тестирование.
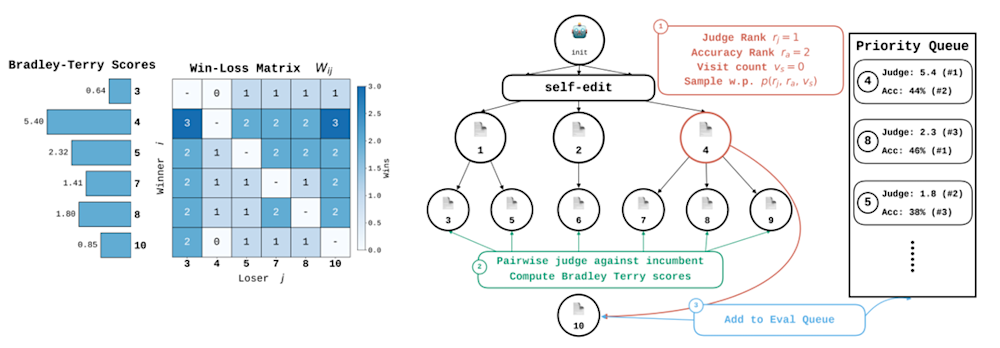
Фреймворк SIFT (источник: arXiv)
Затем SIFT просит LLM-судью провести попарное сравнение нового агента максимум с 10 высокорейтинговыми агентами из архива. Сравнить две реализации — всё равно что попросить менеджера по найму выбрать одного из финалистов, а не выставить каждому абсолютную оценку по 100-балльной шкале. Судья видит код агентов, но не задачи бенчмарка и не результаты их выполнения.
SIFT объединяет результаты попарных сравнений в рейтинг с помощью модели Брэдли — Терри — статистического метода для оценки относительной силы на основе побед и поражений. Рейтинг не заменяет тестирование, а помогает решить, на что стоит тратить время при тестировании и дальнейшей разработке.
Затем новый кандидат попадает в очередь с приоритетами для более масштабной и затратной по времени оценки. Его приоритет определяется с учётом рейтинга судьи и рейтинга точности на бенчмарке.
Такой процесс не заставляет ждать, пока завершится полная оценка предыдущего исправления. Генерация исправлений, работа судьи и оценка на бенчмарке могут идти параллельно. Это похоже на конвейер CI, в котором работа продолжается, пока более длительные тесты выполняются в фоновом режиме. Перспективные кандидаты могут стать основой для новых исправлений ещё до завершения дорогостоящих оценок.
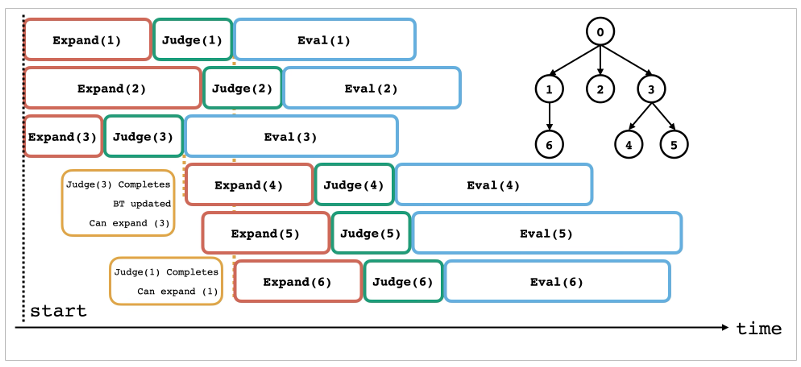
SIFT обрабатывает разные ветви параллельно (источник: arXiv)
Выбирая родительскую версию для улучшения, SIFT учитывает рейтинг судьи, рейтинг точности агента на наборе задач для поиска и то, как часто этого агента уже выбирали. Если кандидат всё ещё ожидает оценки, он временно наследует показатель точности родительской версии. Учёт предыдущих выборов не даёт поиску снова и снова отдавать предпочтение одной ветви. Это оставляет возможность исследовать альтернативы, которые после дополнительных изменений могут оказаться лучше.
В одном из тестов на бенчмарке для программирования Polyglot кандидат под названием Node 9 добавил короткую инструкцию запускать тесты после редактирования, а также инструмент «test_runner», который возвращает структурированные сообщения об ошибках. Более поздний потомок добавил дополнительные механизмы. Оба агента решили 44% задач в небольшом поисковом тесте, поэтому по нему нельзя было определить, какой из них лучше покажет себя на более широком бенчмарке. При оценке на Polyglot более простая версия набрала 35,6%, тогда как более сложная версия, построенная на её основе, — 33,8%. Судья уже поставил более простую Node 9 выше.
Когда оценка судьи лучше результата поиска
Исследователи проверили SIFT на Polyglot, TerminalBench 2.1 и подмножестве из 60 задач SWE-bench Verified. В экспериментах использовались несколько моделей для программирования и LLM-судей. SIFT сравнивали с DGM и HGM, измеряли улучшение относительно исходной версии каждого агента без модификаций, а также запускали SIFT без LLM-судьи, чтобы выяснить, влияет ли судья на результат.
На Polyglot SIFT обеспечил более высокую точность при меньших вычислительных затратах как с моделью Qwen3-Coder-30B с открытыми весами, так и с закрытой моделью o3-mini. С Qwen3-Coder-30B он немного превзошёл HGM, затратив примерно на треть меньше часов процессорного времени. С o3-mini точность достигла 35,1% против 30,7% у DGM. Запуск SIFT без LLM-судьи показал результат 29,8%, что говорит о том, что судья помог добиться прироста.
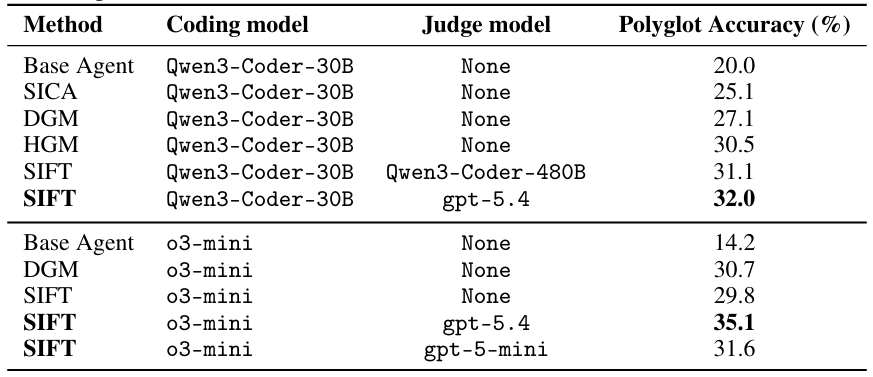
Результаты SIFT (источник: arXiv)
TerminalBench показывает, что может заметить судья, когда небольшой тест даёт вводящий в заблуждение результат. Лучший выбор судьи решил 18 из 50 задач, использовавшихся в ходе поиска, тогда как агент с самым высоким результатом в том же поиске решил 19. Но в повторных запусках на полном бенчмарке средний результат выбранного судьёй агента составил 36,7% против 28,1% у агента, решившего 19 задач из 50. Судья выявил проблемы, анализируя только код: новый верификатор этого агента был по умолчанию отключён, а переписанный инструмент командной оболочки создавал риск сбоев во время выполнения.
Результаты на подмножестве SWE-bench также оказались в пользу выбора под руководством судьи, хотя и не столь однозначно. Средние результаты двух агентов, выбранных судьёй, составили 50,4% и 53,8% по итогам четырёх оценок. Два лучших кандидата в запуске без судьи в среднем набрали 44,6% и 50,4%. Исходный агент показал результат 40,0%.
Что команды могут взять на вооружение из SIFT
В статье нет ссылки на отдельную реализацию SIFT, но разработчикам необязательно воссоздавать весь стек самоусовершенствования. SIFT построен на обвязке DGM, поэтому команды, работающие с реализацией DGM, уже располагают значительной частью базового цикла: генерацией модификаций агента, ведением архива версий-кандидатов и оценкой их производительности. SIFT добавляет попарное сравнение судьёй и рейтинг Брэдли — Терри, а также делает поиск асинхронным, чтобы можно было развивать кандидатов, пока другие проходят оценку.
SIFT тестировали только на агентах для программирования, но тот же базовый подход можно применить и к другим самоусовершенствующимся агентам, если есть чёткий способ измерить, сработало ли изменение. Первый шаг — определить небольшую и недорогую оценку, которая быстро отбрасывает очевидно неудачные модификации. Для корпоративного агента это может быть небольшой набор типичных внутренних задач, выявляющий поломки инструментов, регрессии или изменения, нарушающие базовые требования.
Вторая составляющая — LLM-судья, который попарно сравнивает реализации-кандидаты. Вместо того чтобы пытаться предсказать точную оценку на бенчмарке, судье достаточно составить полезный рейтинг перспективности версий.
Наконец, конвейер должен работать асинхронно. Генерация кандидатов, работа судьи и более затратные оценки должны идти параллельно, чтобы перспективные ветви продолжали развиваться, пока предыдущие кандидаты ещё проходят тестирование. Именно это во многом обеспечивает ускорение SIFT: дерево поиска продолжает расти, а не ждёт завершения каждой оценки.
Выбор судьи также открывает возможности для оптимизации. Исследователи обнаружили, что более дешёвый судья сохранял значительную часть общего сигнала ранжирования на TerminalBench, хотя среди лучших кандидатов надёжнее работала более мощная модель. По их словам, можно использовать многоуровневую схему: более дешёвого судью для большинства сравнений, а более мощного — для кандидатов в верхней части рейтинга.
SIFT показывает, как сделать сам цикл самоусовершенствования эффективнее, объединив более дешёвые сигналы оценки с асинхронным поиском. Это позволяет командам исследовать больше потенциальных улучшений, не увеличивая расходы на оценку в той же мере. Однако для подтверждения того, что изменение действительно улучшило агента, по-прежнему нужны последующие тесты на бенчмарках, а исследователям пришлось блокировать исправления, ослаблявшие требования обвязки оценки.