Загрузка корпоративных графических процессоров: почему 95% расходов на ИИ-инфраструктуру расходуется впустую
Источник: VentureBeat · Rob Strechay


Последние 24 месяца один и тот же нарратив оправдывал каждый избыточный дата-центр и раздутый ИТ-бюджет: всеобщея гонка за графическими процессорами. Кремний стал новой нефтью, а чипы H100 продавались из-под полы как контрабанда. Резервируйте мощности прямо сейчас, иначе ваше предприятие безнадежно отстанет.
Теперь пришло время платить по счетам, и финансовый директор внимательно следит за процессами. По оценкам Gartner, инфраструктура искусственного интеллекта добавит $401 млрд новых расходов в текущем году. Однако реальные аудиты рисуют куда более мрачную картину: средняя загрузка графических процессоров на предприятиях застряла на отметке 5%.
Этот порог загрузки обусловлен самоподдерживающимся циклом закупок, из-за которого простаивающие GPU практически невозможно вывести из оборота. Ситуация становится еще острее из-за реалий капитальных затрат (CapEx), которые теперь бьют по корпоративным балансам. Многие организации зафиксировали емкость графических процессоров в рамках традиционных трех- и пятилетних циклов амортизации, причем у гиперскейлеров этот срок составляет пять лет. Это означает, что инфраструктура, приобретенная на пике «гонки за GPU», теперь является фиксированными затратами — независимо от того, насколько интенсивно она используется на практике.
По мере старения этих активов вопрос уже не в том, были ли инвестиции оправданы. Вопрос в том, удастся ли заставить их приносить пользу. Недозагруженные графические процессоры — это не просто простаивающие ресурсы, это дешевеющие активы, которые теперь должны приносить измеримую отдачу. Это заставляет менять мышление: от приобретения мощностей к максимизации экономической отдачи от того, что уже развернуто.
Гонка была лишь отвлекающим маневром
Для корпораций «уровня Tier 1» — таких как Intuit, Mastercard и Pfizer — доступ к ресурсам редко становился реальным узким местом. Используя тесные партнерские отношения с AWS, Azure и GCP, эти организации забронировали мощности, которые простаивали, в то время как внутренние команды боролись с гравитацией данных, вопросами управления и архитектурной незрелостью.
Индустриальный нарратив о «дефиците» служил удобной дымовой завесой для этой неэффективности. Хотя заголовки СМИ пестрели сообщениями о задержках в цепочках поставок, реальность внутри компаний представляла собой огромный разрыв в производительности. Организации были богаты на активность (скупку чипов), но бедны на результаты (генерацию почти нулевого объема полезных токенов).
При загрузке в 5% эта математика просто не работает. На каждый доллар, потраченный на кремний, 95 центов фактически жертвуются облачному провайдеру. В любом другом отделе 95-процентный показатель отходов стал бы поводом для увольнения; в сфере ИИ-инфраструктуры это называлось «готовностью».
Трекер первого квартала: рынок на этапе разворота
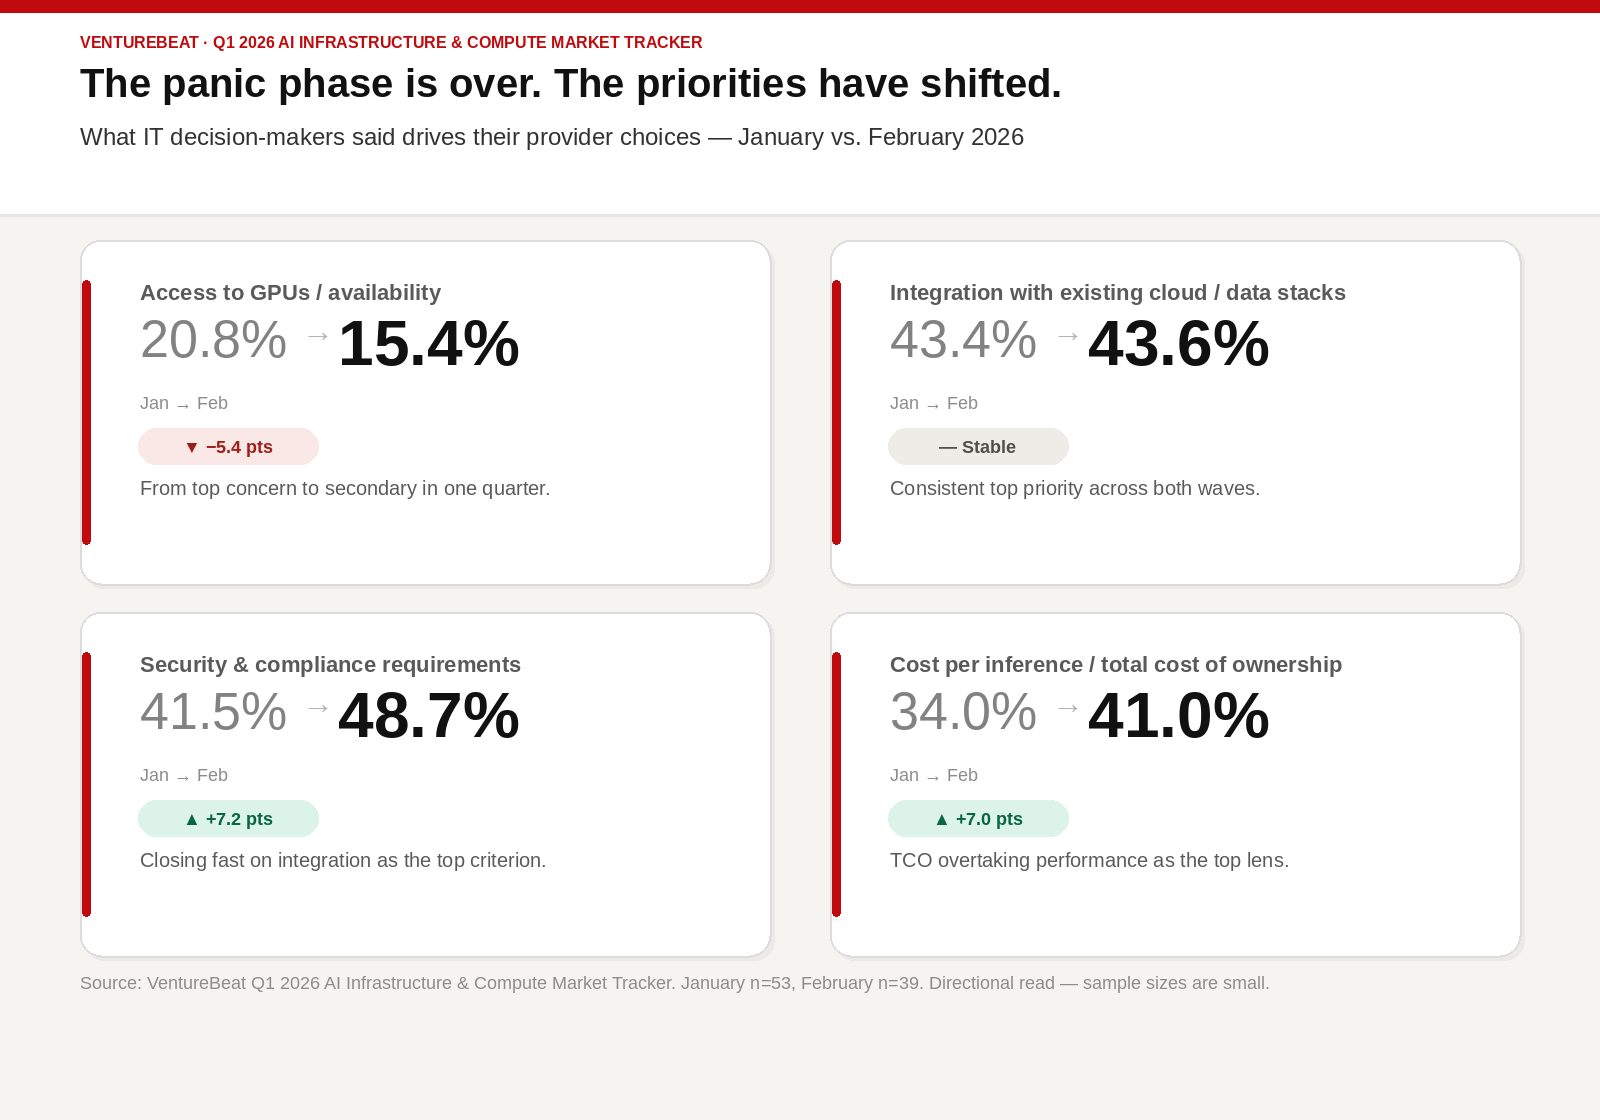
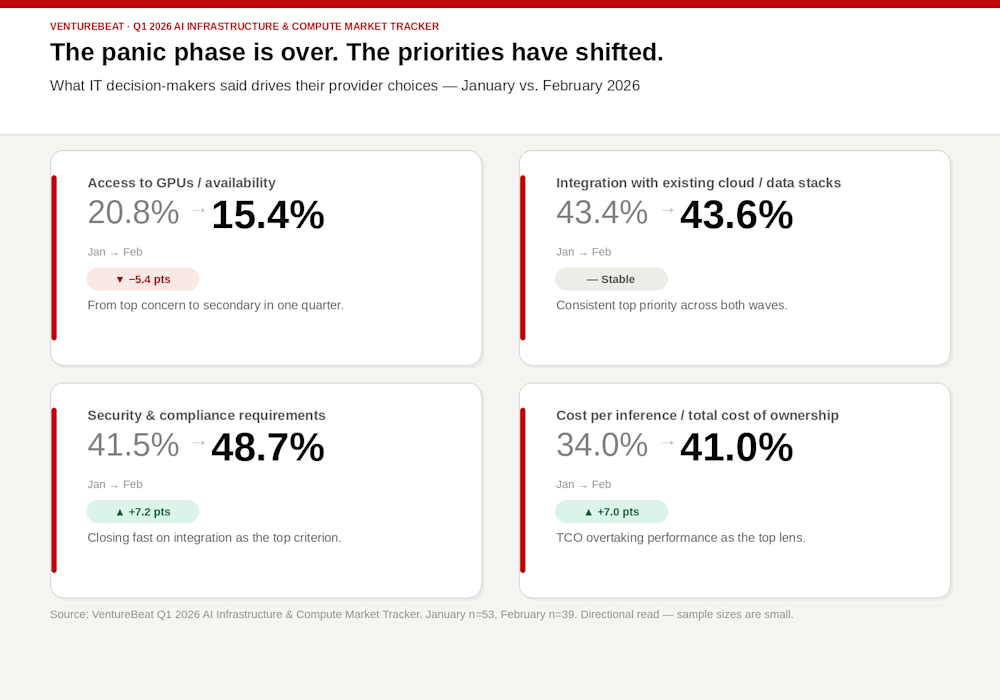
Маркетинговый трекер ИИ-инфраструктуры и вычислительных мощностей за первый квартал 2026 года от VentureBeat подтверждает, что фаза паники официально завершилась. Этот трекер носит скорее ориентировочный, чем статистически окончательный характер (в январском опросе приняли участие 53 квалифицированных респондента, в февральском — 39), однако паттерн в обеих волнах прослеживается стабильно. Когда мы спросили лиц, принимающих решения в ИТ-сфере, что на самом деле движет их выбором провайдера сегодня, результаты показали рынок в состоянии стремительного разворота:
-
Крах проблемы доступа: Фактор «доступ к GPU / наличие» упал с 20,8% до 15,4% всего за один квартал, сместившись из разряда первоочередных забот во второстепенные за 90 дней.
-
Прагматичный поворот: «Интеграция с существующими облачными и дата-стеками» удержала позицию главного приоритета на уровне примерно 43% в обеих волнах, в то время как требования безопасности и соответствия нормативным требованиям подскочили с 41,5% до 48,7%, почти сравнявшись с интеграцией.
-
Требование TCO: «Стоимость инференса / TCO (совокупная стоимость владения)» в качестве главного приоритета подскочила с 34% до 41% всего за один квартал, вытеснив производительность в качестве доминирующего критерия закупок.
Эпоха чеков без указания суммы подошла к концу. Инференс — это этап, на котором ИИ превращается в конкретную строку расходов.
Обучение и даже тонкая настройка (fine-tuning) были тактическими проектами; инференс — это стратегическая бизнес-модель. Для большинства предприятий экономика этой модели в настоящее время неустойчива. На начальном этапе пилотов лицензии с фиксированной платой и пакетные сделки с токенами допускали архитектурные излишества. Команды создавали агентов с длинным контекстом и сложные конвейеры поиска, потому что токены фактически были безвозвратными издержками.
Поскольку в 2026 году индустрия переходит на ценообразование на основе фактического использования (usage-based pricing), те же самые архитектуры превратились в пассивы. Когда покилобайтная или потактовая тарификация применяется к инфраструктурному стеку, который простаивает 95% времени, стоимость полезного токена становится чрезвычайной ситуацией локального масштаба, как только проект переходит в стадию продакшена.
От активности к продуктивности
Сдвиг, зафиксированный в наших данных за первый квартал, отражает нечто большее, чем просто корректировку бюджетов; это кардинальное изменение в оценке эффективности ИИ-лидера.
Последние два года успех измерялся «обеспечением» стека. В эпоху эффективности успех измеряется «выжиманием максимума» из стека. Именно поэтому платформы оптимизации затрат продемонстрировали самый масштабный плановый рост бюджетов в нашем опросе, превратившись в приоритет высшего уровня, поскольку организации осознали: покупка все новых GPU часто оказывается неверным решением.
Все чаще ИТ-пользователи задаются вопросом, как прекратить платить за GPU, которые они не используют. Они отходят от измерения активности GPU (сколько чипов включено) и переходят к оценке продуктивности GPU (сколько полезных токенов генерируется на каждый потраченный доллар).
Роскошь недозагрузки теперь стала бременем. Следующий акт драмы корпоративного ИИ во многом сводится к поиску способов заставить уже имеющийся у вас кремний окупать себя.
Хозяин печатного станка: выбор между потребителем и производителем токенов
По мере перехода организаций от концептуальных проверок (PoC) к промышленной эксплуатации фокус смещается с новейшего графического процессора на архитектуру генерации токенов. В этой новой экономической реальности каждое предприятие должно определить свою роль в токен-экономике: будете ли вы потребителем токенов, выплачивая постоянную «дань» поставщику моделей, или производителем токенов, владеющим инфраструктурой и сопутствующей юнит-экономикой?
Этот выбор касается не только затрат; он определяет то, как организация справляется со сложностью. Владение инференс-инфраструктурой означает преодоление проблем персистентности KV-кеша, понимание архитектуры хранения, знание допустимых гарантий задержки (latency) и учет ограничений по питанию. Это также влечет за собой реальные корпоративные ограничения — доступность питания, физическое пространство в дата-центрах и операционную сложность, — которые напрямую влияют на то, как далеко и быстро сможет масштабироваться ИИ.
В основе этой проблемы лежит экономика KV-кеша. Хранение контекста в памяти GPU обеспечивает высокую производительность, но обходится дорого, ограничивая параллелизм и увеличивая стоимость токена. Выгрузка KV-кеша в общее хранилище на базе NVMe может улучшить повторное использование и снизить накладные расходы на префилл, однако влечет за собой компромиссы в задержках и системном дизайне. По мере роста стоимости NVMe и сохранения дефицита памяти GPU организации вынуждены балансировать между производительностью и эффективностью.
Для производителя токенов управление этими компромиссами — в памяти, хранилищах, энергопотреблении и операциях — это просто издержки ведения бизнеса в масштабе. Для остальных накладные расходы остаются слишком высокими, что требует поиска иного пути.
Поворот в сторону специализированных облаков
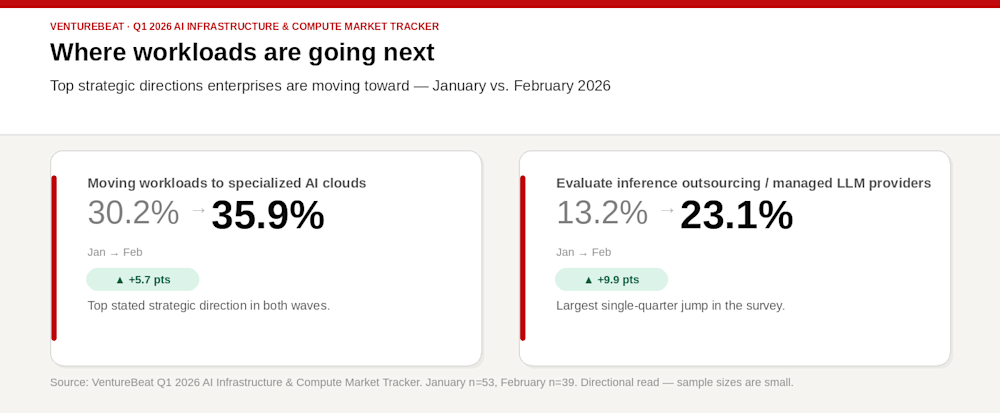
Трекер VentureBeat за первый квартал показывает, что рынок уже голосует за эту стратегию. Главным стратегическим направлением для предприятий теперь является перенос больших объемов рабочих нагрузок в специализированные ИИ-облака — категория выросла с 30,2% до 35,9% в нашем последнем опросе.
Эти провайдеры — включая Coreweave, Lambda и Crusoe — эволюционируют. Хотя изначально они завоевали позиции, обслуживая создателей моделей и ресурсоемкие задачи обучения, структура их доходов быстро меняется. Сегодня обучение составляет примерно 70% их бизнеса, но клиенты инференса теперь занимают 30%. Мы ожидаем, что это соотношение перевернется к концу 2026 года, по мере масштабирования «длинного хвоста» корпоративного инференса.
Эти специализированные провайдеры привлекают стратегическое внимание, потому что они не просто продают доступ к GPU. Они продают устранение инфраструктурных трений. Они оптимизируют весь стек — хранение, сеть и планирование — под экономику, ориентированную в первую очередь на инференс, а не под облачные операции общего назначения. Для организации, стремящейся стать производителем токенов, такие среды предлагают более эффективную производственную площадку, чем традиционные гиперскейлеры.
Больше опросов VB Pulse
Рост управляемого инференса
Для организаций, которые понимают, что они не могут эффективно строить или администрировать собственные инференс-фабрики, намечается иной тренд. Наш опрос показал, что намерение оценивать аутсорсинг инференса и управляемых LLM-провайдеров подскочило с 13,2% до 23,1% всего за один квартал.
Этот рост почти на 10 процентных пунктов отражает осознание того, что внутреннее создание инференс-инфраструктуры часто порождает скрытые издержки. Провайдеры вроде Baseten, Anyscale, FireworksAI и Together AI предлагают прогнозируемое ценообразование и соглашения об уровне обслуживания (SLA) без необходимости для клиента становиться экспертами в настройке vLLM или распределенном планировании GPU.
В этой модели предприятие остается потребителем токенов, но таким, который активно стремится за счет денег избавиться от сложности стека. Компании учатся тому, что внутреннее управление инференсом жизнеспособно лишь при наличии достаточных объемов, оправдывающих операционное бремя.
Упрощение гибридного стека
Выбор в пользу роли производителя также облегчается новым слоем гибридно-облачных ИИ-платформ. Решения от Red Hat, Nutanix и Broadcom созданы для операционализации инфраструктуры инференса с открытым исходным кодом, избавляя каждую компанию от необходимости выступать в роли системного интегратора.
Проблема заключается в том, что современный инференс опирается на сложные компоненты Open Source, такие как vLLM, Triton и Kubernetes. Эти системы полагаются на быстро развивающийся стек (vLLM для высокопроизводительного обслуживания, Triton для оркестрации моделей, Ray для распределенного выполнения), каждый из которых сам по себе мощен, но сложен в интеграции, настройке и масштабировании. Для большинства предприятий вызов заключается не в доступе к этим инструментам, а в их увязке в надежный производственный конвейер инференса. Обещание этих новых платформ заключается в портируемости: возможности построить инференс-стек один раз и развернуть его где угодно — будь то у гиперскейлера, в специализированном облаке или в локальном дата-центре (on-premises).
Наш маркетинговый трекер ИИ-инфраструктуры и вычислительных мощностей за первый квартал 2026 года подтверждает, что интерес к таким стекам формата «сделай сам, но под управлением» растет — с 11,3% в январе до 17,9% в феврале, наряду с распространением провайдеров и устойчивым увеличением числа организаций, склоняющихся к открытому ПО. Эта гибкость имеет решающее значение, поскольку корпоративный ИИ не будет централизован в одном месте. Рабочие нагрузки инференса будут распределяться в зависимости от того, где хранятся данные, насколько они конфиденциальны и где ниже стоимость их обработки.
Победителем в следующем этапе токен-экономики станет не та платформа, которая насаждает стандартизацию через ограничения, а та, которая обеспечивает ее через портируемость, позволяя предприятиям переключаться между ролями потребителей и производителей по мере эволюции их потребностей.
Архитектура эффективности: технические рычаги производительности
Преодоление барьера 5-процентной загрузки требует не просто лучшего софта; необходима структурная перестройка стека эффективности. Многие организации обнаруживают, что высокая активность не равна высокой производительности. Кластер может работать на пределе возможностей, но оставаться экономически неэффективным, если время до первого токена (time-to-first-token) слишком велико, а запросы инференса проводят слишком много времени в фазе префилла.
Экономика инференса определяется тем, какой объем полезного результата генерирует кластер на единицу затрат. Это требует перехода от измерения активности GPU (простого включения чипов) к измерению их продуктивности. Достижение этой продуктивности зависит от трех технических рычагов: сети, памяти и стека хранения данных.
Сети: плата за ожидание
Сеть — это часто игнорируемый костяк экономики инференса. В распределенной среде скорость перемещения данных между вычислительными узлами и хранилищем определяет, работает ли графический процессор на самом деле или просто простаивает.
RDMA (Remote Direct Memory Access) стал непреложным стандартом для таких перемещений. Позволяя данным обходить CPU и перемещаться напрямую между памятью и GPU, RDMA устраняет всплески задержек, свойственные традиционным сетевым архитектурам. На практике архитектура с поддержкой RDMA способна увеличить производительность одного GPU в десять раз при параллельных рабочих нагрузках.
Без такого уровня сетевого взаимодействия предприятие фактически платит «налог на ожидание» за каждый чип в стойке. По мере расширения контекстных окон моделей и распространения многоузловой оркестрации сеть решает, станет ли кластер высокоскоростной фабрикой или складом с узкими горлышками.
Решение проблемы «налога на память»: общий KV-кеш
По мере укрутнения моделей и роста контекстных окон до миллионов токенов издержки на многократное воссоздание состояния промпта стали непосильными. Большие языковые модели полагаются на кэши ключей и значений (KV-кеш), чтобы сохранять контекст в ходе сессии. Традиционно они хранятся в локальной памяти GPU, что одновременно дорого и ограничено.
Это порождает «налог на память», который уничтожает юнит-экономику по мере роста параллелизма. Для решения этой проблемы индустрия движется к архитектурам персистентного общего KV-кеша. Храня кеш централизованно на высокопроизводительном накопителе, а не избыточно на множестве узлов GPU, организации могут снизить накладные расходы на префилл и улучшить повторное использование контекста.
Новые архитектуры уже доказывают свою эффективность. Операционная система VAST Data AI, работающая на узлах VAST C-nodes с использованием DPU Nvidia BlueField-4, обеспечивает общий KV-кеш в масштабе подов (pod-scale), ликвидируя устаревшие уровни хранения. Аналогичным образом HPE Alletra Storage MP X10000 — первая объектная платформа, получившая валидацию Nvidia-Certified Storage — разработана специально для подачи данных к инференс-ресурсам без координационного «налога», вызывающего узкие места при масштабировании. WEKA — еще один игрок в этой нише.
Google’s recent presentation of TurboQuant at ICLR 2026 demonstrates the scale of this shift. TurboQuant provides up to a 6x compression level for the KV cache with zero accuracy loss.
Грань сжатия
Помимо физического «железа», новые алгоритмические разработки переопределяют возможности памяти для инференса. Недавняя презентация TurboQuant от Google на конференции ICLR 2026 демонстрирует масштаб этого сдвига. TurboQuant обеспечивает до 6-кратного уровня сжатия KV-кеша без потери точности.
Подобные методы позволяют создавать крупные векторные индексы с минимальными затратами памяти и почти нулевым временем предварительной обработки. Для предприятия это означает большее число одновременных пользователей на том же аппаратном парке без «штормов пересборки», которые обычно вызывают всплески задержек. Предупреждение: стандарты сжатия остаются предметом споров — консенсуса в сфере Open Source не возникло, и это направление превращается в войну проприетарных стеков между Google и Nvidia.
Хранилище как финансовое решение
Хранилище данных перестало быть чисто бэкенд-решением; теперь это вопрос финансов. Такие платформы, как Dell PowerScale, по данным Dell, обеспечивают скорость выдачи первого токена (time-to-first-token) до 19 раз выше по сравнению с традиционными подходами. Разделяя высокопроизводительное общее хранилище и ресурсоемкий доступ к данным и отделяя их от дефицитных ресурсов GPU, эти платформы позволяют эффективнее масштабировать инференс.
Когда уровень хранения способен бесперебойно подпитывать данные для ресурсоемких задач GPU, это предотвращает простой дорогостоящих мощностей. В эпоху эффективности цель состоит в том, чтобы преодолеть барьер 5-процентной загрузки, гарантируя, что каждый цикл тратится на генерацию токенов, а не на перемещение данных.
Однако по мере того как стек становится эффективнее, периметр становится более уязвимым. Высокопроизводительные токены бесполезны, если данным, которые их питают, нельзя доверять.
Суверенитет и агентное будущее: создание фундамента доверия
Последним препятствием на пути к получению отдачи от ИИ является не технический тупик, а дефицит доверия. По мере того как корпоративный ИИ трансформируется из простых чат-ботов в автономных агентов, профиль рисков меняется. Агентам необходим глубокий доступ к внутренним системам и интеллектуальной собственности, чтобы быть полезными. Без суверенной архитектуры этот доступ порождает уязвимость, к управлению которой большинство организаций не готовы.
Исследование VentureBeat, посвященное состоянию систем управления ИИ, выявляет резкий разрыв. Хотя многие организации считают, что они обезопасили свои ИИ-среды, 72% предприятий признают, что не обладают тем уровнем контроля и безопасности, который им кажется. Этот мираж управления особенно опасен по мере выхода агентных систем в продакшн. За последние 12 месяцев 88% руководителей сообщили об инцидентах безопасности, связанных с ИИ-агентами.
Суверенитет как архитектурный принцип
Суверенитет данных часто рассматривается как географическая или регуляторная галочка в чек-листе. Для стратегически мыслящего предприятия он должен стать ключевым архитектурным принципом. Речь идет о сохранении контроля, происхождения (lineage) и прозрачности данных, которые питают агентный воркфлоу.
Это требует нового подхода к зрелости данных, смоделированного по образцу традиционной многоуровневой архитектуры (medallion architecture). В этой структуре данные проходят через слои применимости и доверия — от сырого приема на бронзовом уровне до очищенного золотого и, в конечном итоге, операционных данных платинового качества. ИИ-инференс должен следовать той же дисциплине.
Агентным системам требуется не просто доступный контекст; им нужен доверенный контекст. Передача агенту неверных данных или раскрытие конфиденциальной интеллектуальной собственности несуверенной конечной точке создает как бизнес-риски, так и регуляторные угрозы. Сегментация должна закладываться в стек с самого начала. Организациям необходимо точно знать, какие модели и агенты могут обращаться к конкретным уровням данных, на каких условиях и с каким прослеживаемым происхождением.
Роб Стречей (Rob Strechay) — приглашенный аналитик VentureBeat и директор консалтинговой и исследовательской компании Smuget Consulting, специализирующейся на дата-инфраструктуре и ИИ-системах.
Раскрытие информации: Smuget Consulting осуществляет или осуществляла деятельность в сфере исследований, консалтинга и консультационных услуг для многих технологических компаний, включая те, что упомянуты в этой статье. Представленные здесь аналитические выводы и мнения отражают личную позицию автора, а данные и прочая информация могли предоставляться для валидации, но не отражают позицию VentureBeat в целом.