Почему загрузка корпоративных графических процессоров застряла на уровне 5% — и почему ее исправление делает только хуже
Источник: VentureBeat · Ujas Patel


Предприятия не могут решить проблему неэффективного использования графических процессоров (GPU), потому что само это решение только усугубляет проблему. Высвобождение простаивающих мощностей могло бы повысить коэффициент использования, но именно тот дефицит, который толкает цены на GPU вверх, заставляет ни одну команду не возвращать мощности обратно. В результате парк оборудования работает примерно на 5%, оплачиваясь по часам, и цикл замыкается.
Это давление, повторяющееся на тысячах предприятий за последние два года, является причиной того, что большинство компаний сейчас используют свои парки GPU примерно на 5%, согласно «Отчету об оптимизации Kubernetes за 2026 год» от компании Cast AI, в котором измерялись реальные производственные кластеры, а не проводились опросы. Это также причина, по которой никто не высвобождает простаивающие мощности. Соучредитель и президент Cast AI Лоран Жиль отслеживает эту динамику на протяжении двух лет. «Многие неооблака вовсе не являются облаками», — рассказал он VentureBeat. — «Это неонедвижимость».
Пять процентов — это примерно в шесть раз хуже базового уровня, достигаемого без каких-либо усилий. Жиль называет разумным целевым показателем при управлении силами человека около 30%, если принять во внимание суточные циклы, выходные и обычные бизнес-процессы. Пять процентов означают, что предприятия используют свою самую дорогонную инфраструктурную статью расходов лишь на малую долю от того, что дало бы простое бездействие. И это происходит в тот самый момент, когда цены на облачные вычисления нарушили свою 20-летнюю тенденцию.
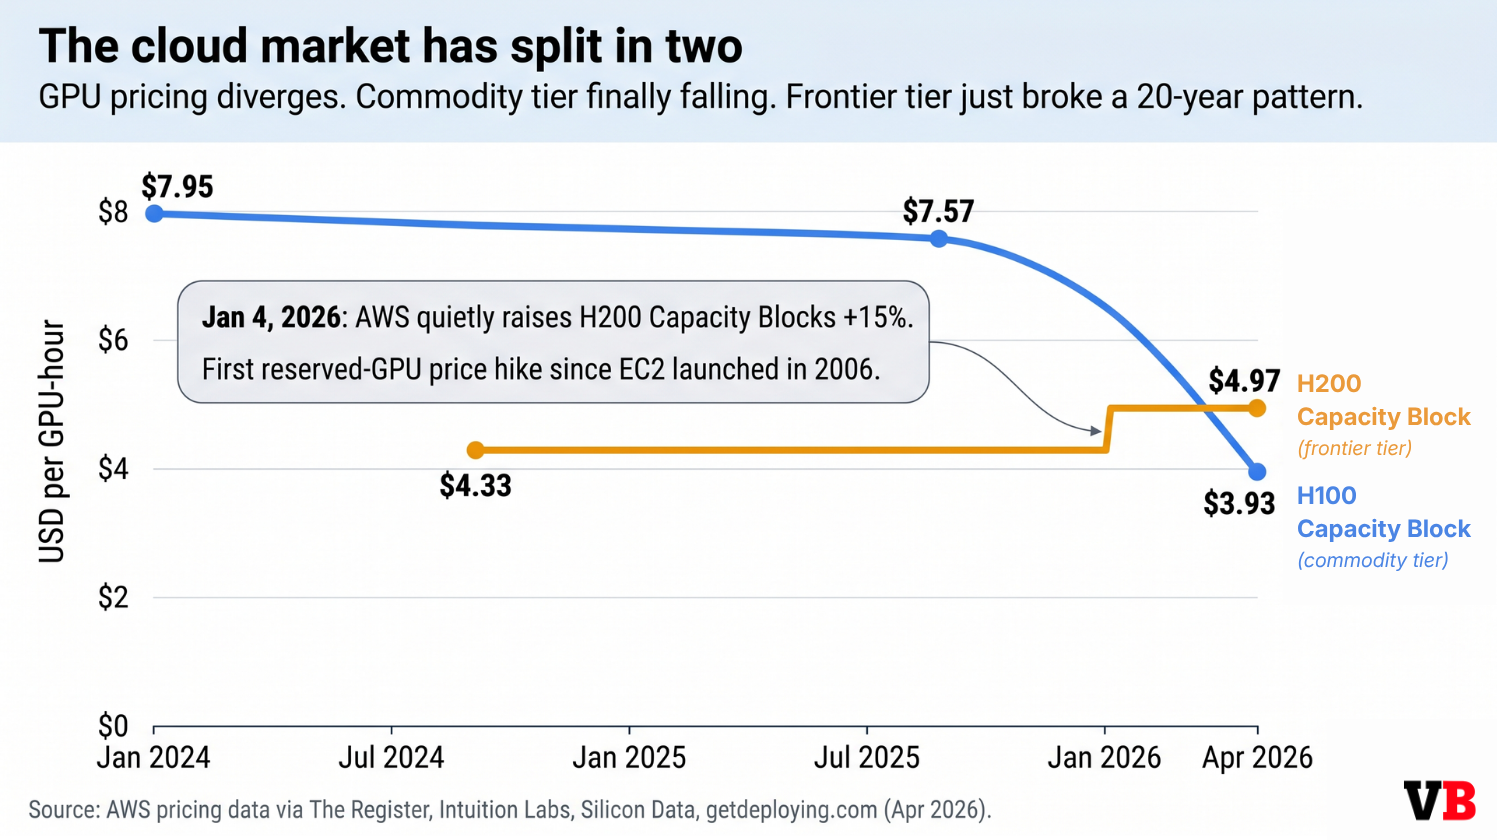
AWS тихо подняла цены на зарезервированные GPU H200 примерно на 15% в субботу в январе, без каких-либо официальных анонсов. Поставщики памяти подтолкнули цены на HBM3e вверх на 20% на 2026 год. Это первый случай с момента запуска AWS EC2 в 2006 году, когда облачный провайдер значимо повысил цены на зарезервированные GPU, а не снизил их. На данный момент предположение, лежащее в основе большинства бюджетов корпоративного ИИ — о том, что облачные вычисления с каждым годом становятся дешевле, — больше не работает на верхнем уровне стека.
Рынок облачных услуг раскололся надвое
Ценовой маневр важен не столько сам по себе, сколько тем, что он сигнализирует о том, где именно дефицит дает о себе знать. Облачные вычисления разделились на два слоя. На базовом уровне старая дефляция все еще работает. Цены на H100 по требованию (on-demand) упали примерно с $7,57 за GPU-час в сентябре 2025 года примерно до $3,93 сегодня, причем Lambda Labs и RunPod предлагают H100 дешевле $3, а более старые A100 — около $1,92. Чипы Nvidia T4, которые раньше было невозможно найти по спотовым ценам, теперь сохраняют вероятность доступности выше 90% в течение 24 часов в нескольких регионах AWS.
Создано автором с помощью Nano Banana 2
На передовом уровне ситуация обратная. Nvidia получила заказы на 2 миллиона чипов H200 на 2026 год при наличии на складе 700 000. Передовая упаковка TSMC, которая является узким местом для каждого GPU с памятью HBM, забронирована как минимум до середины 2027 года. AMD предупредила о собственном повышении цен в 2026 году, сославшись на тот же кризис. Даже цены на A100, которые, как ожидалось, должны были снизиться по мере истечения трехлетних броней 2023 года, начали снова ползти вверх. Мнение Жиля: страх упущенной выгоды (FOMO) теперь распространяется и на более старые поколения. На каком именно слое находятся рабочие нагрузки предприятия, определяет степень его подверженности рискам.
Почему 5%? Часть первая: цикл закупки
Как загрузка парка падает до 5%, когда GPU стоят так дорого? Рассказ Жиля о корпоративных закупках GPU — это самое понятное объяснение из всех, что я слышал.
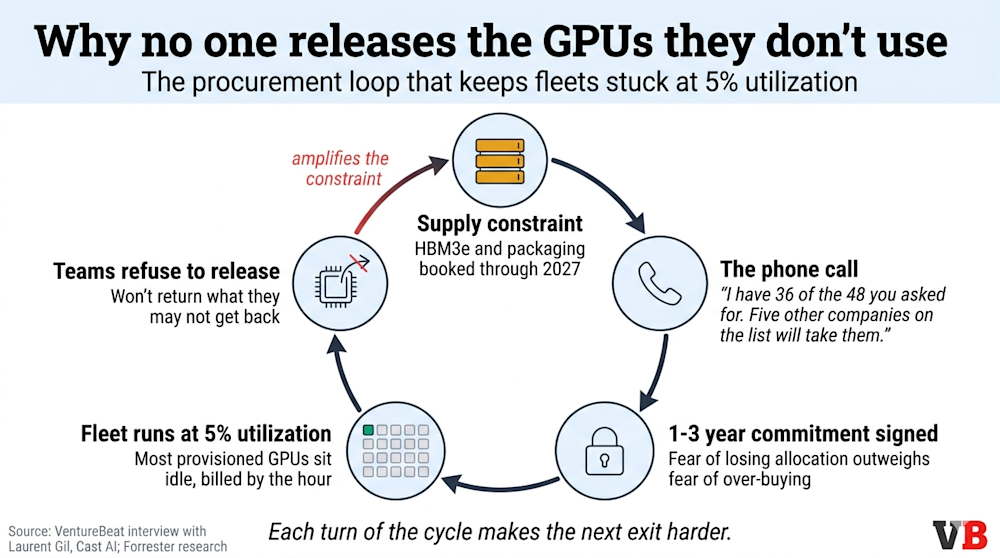
Предприятию нужны GPU. Оно встает в очередь у облачного провайдера. Ничего не происходит неделями, иногда месяцами. Затем телефонный звонок: «Вы просили 48, у меня есть 36. Ваши, если хотите, но только с обязательством на один или три года, причем три года дешевле. Если вам не нужно, пять других компаний из списка их заберут». Страх потерять выделенный объем высок. Обязательство подписывается. Будут ли рабочие нагрузки потреблять такое количество GPU или подойдет ли это поколение чипов под то, что на них будет запущено, на данный момент не главный вопрос. Главный вопрос — сказать «да» или потеряв слот.
Получив эти GPU, расставаться с ними становится слишком болезненно. Их повторное приобретение займет месяцы, и никто не хочет быть той командой, которая вернула мощности, а потом не смогла их получить. Вот почему парк оборудования простаивает, оплачиваясь по часам, независимо от того, используется он или нет. Жиль описал ситуации, когда предприятия платят по требованию (on-demand), что примерно в три раза дороже однолетних резервов, потому что даже такая переплата кажется безопаснее, чем риск остаться ни с чем.
В этом и заключается парадоксальность цифры в 5%. Очевидный способ повысить утилизацию — отказаться от GPU, которые вы не используете. Но именно тот дефицит, который делает эти GPU дорогими, является причиной, почему от них никто не отказывается. В результате парк остается избыточно обеспеченным ресурсами, дефицит сохраняется, цены растут, а страх упущенной выгоды, породивший этот цикл, только усиливается. Каждый виток петли делает следующий выход из нее еще более сложным.
Создано автором с помощью Nano Banana 2
Данные Forrester подтверждают эту динамику с другой стороны. Главный аналитик Трейси Ву выяснила, что практики самостоятельно оценивают потери в Kubernetes примерно в 60%, что близко к тому, что Cast AI измеряет напрямую. Широко распространенный паттерн в практике использования Kubernetes объясняет эту динамику: инженеры регулярно запрашивают в пять-десять раз больше ресурсов, чем они используют на самом деле, потому что стоимость недостаточного выделения ресурсов заметна (срабатывает пейджер), а стоимость избыточного выделения невидима (одна строка в облачном счете, которую никакой инженер не видит).
Почему 5%? Часть вторая: цикл архитектуры
Исправление только лишь процесса закупок не поднимет этот показатель до хорошего уровня, поскольку GPU, которыми предприятия уже владеют, также неэффективны изнутри. И архитектурная половина этой истории независимо друг от друга диагностируется командами, конкурирующими с Cast AI.
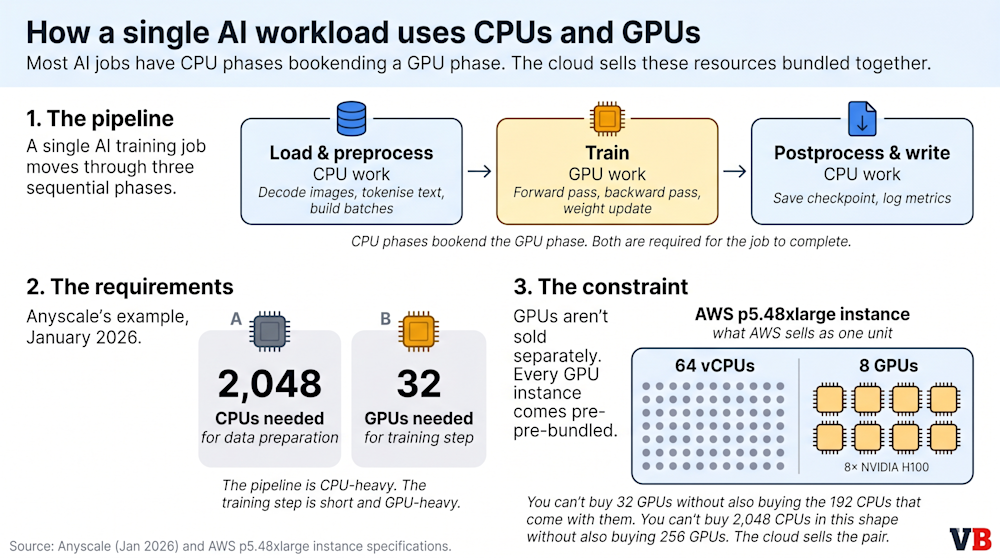
Anyscale, компания, стоящая за фреймворком Ray, опубликовала собственный анализ 21 января, утверждая, что современные рабочие нагрузки ИИ регулярно имеют загрузку GPU ниже 50%, даже когда размер парка выбран идеально, из-за того, как эти рабочие нагрузки контейнеризированы. Одна задача ИИ проходит через этапы с интенсивным использованием CPU (загрузка данных, предварительная обработка), этапы с интенсивным использованием GPU (обучение или инференс) и снова возвращается к CPU. Когда все это работает в одном контейнере, GPU выделяется на весь жизненный цикл, но выполняет полезную работу лишь малую его часть.
Создано автором с помощью Nano Banana 2
Gartner приходит к такому же выводу независимо. В исследовательской записке за ноябрь 2025 года по локальной (on-premises) ИИ-инфраструктуре компания рекомендует объединять совместное использование GPU между изолированными проектами с дезагрегированным инференсом, при котором обработка промптов и генерация токенов выполняются на различном «железе». Собственный фреймворк инференса Dynamo от Nvidia, представленный для MLPerf Inference v6.0 в прошлом месяце, построен на том же принципе.
Тот факт, что два вендора и независимое аналитическое агентство (Cast AI, Anyscale, Gartner) приходят к одинаковому диагнозу, является более весомым сигналом, чем история любого отдельного вендора, особенно когда один из них конкурирует с остальными. Два вида потерь суммируются. Парк с избыточными обязательствами на момент закупки, выполняющий задачи, чьи контейнеры оставляют GPU простаивать в ожидании предобработки на CPU, оставляет предприятия на уровне 5%. Если исправить одно, не исправив другое, большая часть потенциальной экономии так и останется нереализованной.
Что на самом деле требуется для утилизации в 40%
Если высвобождение GPU заблокировано страхом упущенной выгоды (FOMO), а контракты на закупку уже подписаны, единственный оставшийся рычаг — выполнение большей полезной работы на уже задействованных GPU. Именно это на практике означает «повысить коэффициент утилизации», и ничто из этого не требует покупки продуктов какого-либо вендора.
Самый простой пример из практики — старейший прием в книге: совместное использование GPU в разных часовых поясах. Банк с системой принятия кредитных решений, обслуживающий клиентов из Азии и США, может использовать один пул GPU, который обслуживает оба рынка в разное время. Nvidia выпустила MIG (Multi-Instance GPU) и примитивы разделения времени (time-slicing) много лет назад. Большинство предприятий не делают это вручную, потому что это операционно скучно и сопряжено с накладными расходами на координацию, которыми никто не хочет заниматься. Автоматизированный планировщик делает это, не уставая.
Canva, австралийская дизайнерская платформа, на которой работает более 100 производственных ИИ-моделей, сообщила Anyscale, что поддерживает коэффициент использования GPU, близкий к 100% во время распределенного обучения, с примерно 50-процентным сокращением облачных затрат по сравнению с предыдущей настройкой. Согласно собственным данным Cast AI, кластер из 136 GPU H200 поддерживает среднюю загрузку на уровне 49% после применения шеринга GPU, упаковки контейнеров (размещения нескольких рабочих нагрузок на меньшем количестве узлов оптимального размера) и комбинации спотовых/почасовых мощностей. Это в десять раз больше среднего показателя по парку и меньше точки насыщения, что честно: большинство реальных корпоративных парков со смешанными рабочими нагрузками разработки, стейджинга и продакшна, вероятно, поддерживают от 40% до 70% при полной оптимизации, а не 100%. Но даже это на порядок лучше, чем 5%.
Одно предостережение: цифра в 5% из отчета явно исключает ИИ-лаборатории, проводящие специализированное обучение. Организации, которые больше похожи на передовые лаборатории, чем на смешанные корпоративные парки, вероятно, уже видят гораздо более высокую утилизацию.
Пути закупок перестали быть взаимозаменяемыми
Что предприятиям действительно стоит делать по-другому в 2026 году? Доступные на рынке пути больше не являются взаимозаменяемыми, и каждый из них делает свою ставку на то, где окажутся спрос и предложение.
|
Путь закупки |
Типичная цена за класс H100 |
Доступность |
Риск прерывания |
Обязательства |
Лучшее применение |
|
По требованию у гиперскейлера (On-demand) |
От $3,00 до $6,98 за GPU-час |
Ограничено для H100/H200 |
Отсутствует |
Отсутствуют |
Непредсказуемые рабочие нагрузки, короткие запуски |
|
Блоки емкости гиперскейлеров (Capacity Blocks) |
От $4,33 до $4,97 за GPU-час (H200 после янв. 2026 г.) |
Предзаказ до 8 недель; окно на 6 месяцев |
Отсутствует в пределах окна |
Среднесрочные |
Планируемое обучение с известными временными окнами |
|
Спотовые мощности гиперскейлеров (Spot) |
Скидка до 90% |
Переменная; H100/H200 в дефиците |
Высокий (предупреждение за минуты) |
Отсутствуют |
Отказоустойчивый инференс, обучение с контрольными точками |
|
Специализированные GPU-облака (CoreWeave, Lambda, RunPod, GMI) |
От $1,99 до $3,99 за GPU-час для H100 |
Шире для новых поколений |
От низкого до среднего |
По запуск или короткая бронь |
Чувствительные к цене команды, гибкое развертывание |
|
Собственная инфраструктура или колокация |
Окупаемость примерно через 12–18 месяцев при стабильной утилизации >60% |
Сроки поставки от 3 до 9 месяцев |
Отсутствует |
Капитальные затраты от 3+ лет |
Рабочие нагрузки с высокой постоянной утилизацией, строгие требования к комплаенсу |
|
Децентрализованные маркетплейсы (Vast.ai, io.net, Aethir) |
Часто менее $1,00 за GPU-час |
Сильно варьирующееся качество |
Высокий |
Отсутствуют |
Экспериментальные или пакетные задачи, не связанные с продакшном |
Паттерн, который больше не работает — это выбор одного пути и фиксация на многолетнем плане. Более надежным стандартом на 2026 год является комбинирование путей в соответствии с разделением рынка: базовые провайдеры для рабочих нагрузок, которые могут там функционировать, и блоки емкости гиперскейлеров только для задач, которым требуется гарантированное окно.
Пять рычагов, которые стоит задействовать
Ни один из следующих пунктов не требует обратного выкупа мощностей, которые уже были законтрактованы.
-
Непрерывная оптимизация ресурсов (rightsizing), а не разовая настройка. Запросы ресурсов, заданные при развертывании, почти всегда неверны спустя шесть месяцев. Karpenter, OpenCost и Kubecost — это варианты с открытым исходным кодом; Cast AI, ScaleOps, nOps и PerfectScale автоматизируют сам процесс оптимизации. Cast AI сообщает, что их непрерывная оптимизация сокращает выделенные ресурсы CPU примерно на 50% в среднем по всей их клиентской базе.
-
Региональное размещение спотовых мощностей, особенно для инференса класса T4. Данные кривой выживаемости от Cast AI показывают риск прерывания спотовых инстансов T4 в диапазоне от примерно 10% за 24 часа в eu-west-3 до 80% в eu-central-1 и us-east-1. Выбор региона — это вопрос надежности, а не только задержек (латентности).
-
Шеринг GPU посредством MIG и разделения времени (time-slicing). Функция MIG от Nvidia разделяет чипы A100, H100 и H200 на изолированные экземпляры с выделенными вычислительными ресурсами и памятью. vLLM и Dynamo реализуют непрерывный батчинг (continuous batching) и дезагрегированный инференс. Открытые примитивы, контракты с вендорами не требуются.
-
Дезагрегированная среда выполнения. Ray позволяет масштабировать подготовку данных на базе CPU независимо от обучения или инференса на базе GPU.
-
Ребалансировка обязательств. Зарезервированные инстансы (Reserved Instances) и планы экономии (Savings Plans) теряют актуальность по мере изменения рабочих нагрузок. Cast AI, nOps и Vantage отслеживают использование по отношению к зарезервированным мощностям и автоматически корректируют распределение.
Суть дела
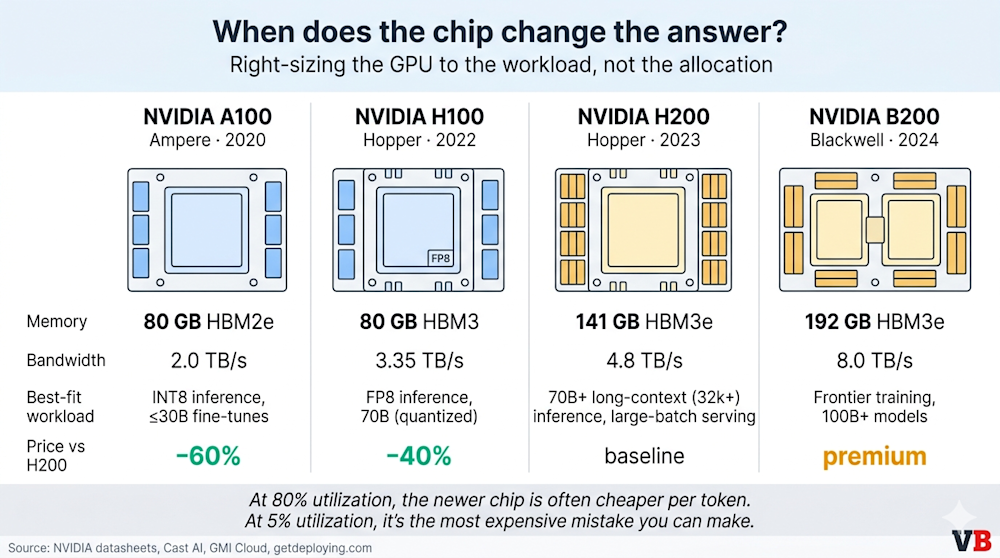
Самый практичный вопрос, который большинство предприятий не задали себе в этом году: действительно ли им нужен H200?
H200 разработан для очень больших моделей (от 70 млрд параметров) с очень длинным контекстом (от 128 тыс. токенов), где его память объемом 141 ГБ (почти вдвое больше 80 ГБ у H100) позволяет чипу справляться с нагрузкой без замедления. Для меньших моделей, дообученных (fine-tuned) производных, квантованного инференса и большей части рабочего ИИ, который реально поставляется клиентам, H100 выполняет ту же работу примерно на 40% дешевле в расчете на GPU-час, согласно данным Cast AI. A100 часто тоже подходит, обходясь примерно на 60% дешевле. Эпоха единого универсального GPU в качестве ответа по умолчанию подходит к концу. Выбор чипа становится вопросом маршрутизации — рабочая нагрузка за рабочей нагрузкой, а не решением о закупках поколенческого уровня.
Создано автором с помощью Nano Banana 2
Собственное наблюдение Жиля подчеркивает это. При 80% утилизации B200 действительно обеспечивает лучшую удельную стоимость за токен, чем A100: он мощнее в час, чем дороже в час. При 5% утилизации математика инвертируется. Премиальный чип усугубляет отходы. Покупка новейшего чипа при его недоиспользовании — это самая дорогая из возможных версий цикла FOMO.
Первый рычаг бесплатен, и это аудит рабочих нагрузок, а не покупка ПО. Для задействования этого рычага не нужно высвобождать ни один GPU. Каждую рабочую нагрузку на базе GPU в продакшне стоит проверить на предмет одного вопроса: действительно ли чип, на котором она работает, соответствует тому, что она делает. Удивительное количество покупок H200 в 2026 году окажутся совершенными потому, что подошла очередь на выделение квоты, а не потому, что этого требовала рабочая нагрузка. Затем исправьте архитектуру среды выполнения, прежде чем тратить средства на дополнительные резервные мощности. Комбинируйте базовые и зарезервированные уровни в соответствии с разделением рынка, вместо того чтобы выбирать что-то одно.
Сбалансируется ли в конечном итоге более широкий рынок GPU — это отдельный вопрос, и не тот, на который стоит ставить бюджет 2026 года. Предложение может догнать спрос. Емкость памяти может вырасти. Специализированный кремний для инференса может перетянуть спрос с уровня H200. Все это возможно. Ничто из этого не гарантировано. Что не вызывает сомнений, так это то, что закупки и среда выполнения — это одна и та же проблема, видимая с двух сторон: FOMO стимулирует избыточные обязательства на переднем фронте, а контейнерная архитектура оставляет избыточно выделенный парк простаивать на заднем. Предприятия, которые рассматривают их как единый цикл, могут разорвать его. Предприятия, которые продолжают рассматривать их как две отдельные статьи бюджета, будут и дальше платить за то, чтобы их самая дорогостоящая инфраструктура работала на 5%.