


OpenAI запускает GPT-5.6-Cyber с меньшим количеством отказов и 95% выполнением сложных задач по кибербезопасности
Источник: VentureBeat · Carl Franzen


Ранее сегодня компания OpenAI представила GPT-5.6-Cyber — специализированную модель, разработанную для проведения расширенных исследований уязвимостей и разработки эксплойтов для авторизованных защитников, включая те категории задач, которые ее универсальные модели часто отказываются выполнять.
GPT-5.6-Cyber представляет собой дообученную версию самой передовой универсальной модели OpenAI — GPT-5.6 Sol, представленной еще в июне, но натренированную специально для повышения эффективности в сложных задачах кибербезопасности, включая поиск уязвимостей нулевого дня и разработку цепочек эксплойтов.
Что еще более важно, OpenAI также обучила ее сокращать количество отказов на некоторые запросы по кибербезопасности с повышенным риском двойного назначения — то есть на запросы, которые потенциально могут использоваться как в легитимных защитных, так и в злонамеренных атакующих целях.
Действительно, согласно внутреннему бенчмарку OpenAI под названием Advanced Cybersecurity Completion Rate (который, как говорится в блоге компании, измеряет выполнение задач, связанных с разработкой цепочек эксплойтов, обходом аутентификации, повышением привилегий и другими сложными сценариями кибербезопасности), GPT-5.6-Cyber справилась с 95% задач по сравнению со скромными 57,3% у ее непосредственной предшественницы GPT-5.5-Cyber и всего 1,5% у обычной модели GPT-5.6 Sol со всеми примененными средствами защиты.
Исследователь OpenAI Эрик Уоллес написал в X, охарактеризовав GPT-5.6-Cyber как «первую масштабную попытку OpenAI напрямую улучшить возможности для решения сложных задач кибербезопасности, таких как разработка эксплойтов».
Цены и доступность
К сожалению для корпоративных клиентов, GPT-5.6-Cyber не становится широко доступной для каждого пользователя ChatGPT или API.
Чтобы получить доступ, организации необходимо пройти отбор в недавно созданный уровень программы кибербезопасности OpenAI под названием Daybreak, который получил название Daybreak Red (также анонсирован сегодня) и предоставляет доступ к специализированным моделям кибербезопасности вроде GPT-5.6-Cyber.
Другой новый уровень, Daybreak Blue, дает более широкому кругу предприятий доступ к универсальным моделям вроде GPT-5.6 Sol, но с частично снятыми ограничениями для расширения сценариев использования в сфере кибербезопасности.
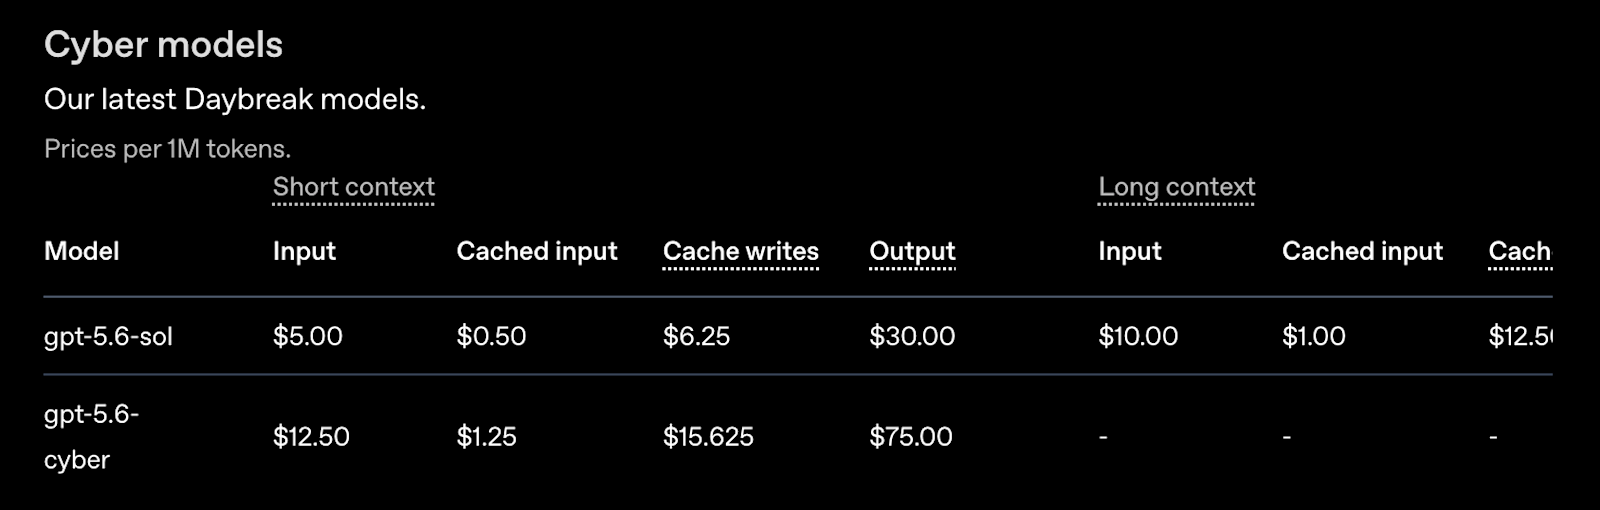
В документах OpenAI указаны следующие расценки на GPT-5.6-Cyber: $12,50 за миллион входных токенов и $75 за миллион выходных токенов, при этом кэшированный ввод обойдется в $1,25 за миллион токенов.
Таблица цен на модели OpenAI-GPT-5.6-Cyber и Sol (Daybreak). Источник: OpenAI
Это делает ее дороже модели GPT-5.6 Sol в той же ценовой таблице Daybreak, где Sol указана по цене $5 за миллион входных токенов и $30 за миллион выходных токенов при работе с коротким контекстом.
OpenAI не приводит расценки для длинного контекста GPT-5.6-Cyber в той же таблице, а для получения доступа по-прежнему требуются отдельное одобрение Daybreak Red и выделение ресурсов.
Red против Blue: новые уровни Daybreak от OpenAI и условия их получения
Daybreak Red предназначена для одобренных групп безопасности, выполняющих сложные и авторизованные киберзадачи — ту работу, которая вне контекста может выглядеть рискованной, даже если она выполняется в защитных целях. Сюда входят исследования уязвимостей, тестирование на проникновение, упражнения Red Team и проверка эксплойтов на системах, которые организация во владении, обслуживает или имеет разрешение тестировать. Другими словами, OpenAI заявляет, что GPT-5.6-Cyber создана для доверенных защитников с четкой профессиональной необходимостью, а не для общих экспериментов.
Предприятия, желающие получить доступ, должны подать заявку через Daybreak Access — актуальный инструмент OpenAI для проверки пользователей из сферы кибербезопасности. Заявка требует от компаний указать информацию о себе, планируемый характер работы по безопасности, места развертывания моделей и ожидаемые к использованию продукты или интерфейсы OpenAI. Заявители также должны подтвердить, что их деятельность является законной, оборонительной и санкционированной.
OpenAI также ищет подтверждения того, что у заявителя есть собственная серьезная программа безопасности. Компания заявляет, что участвующие предприятия должны иметь такие средства контроля, как единый вход (SSO), многофакторная аутентификация, ролевой доступ, мониторинг действий сотрудников, журналы использования, управление ключами API и документированный процесс реагирования на инциденты. OpenAI также запрашивает признанный сертификат безопасности вроде SOC 2 Type II, ISO 27001 или эквивалентный стандарт. Доступ ограничен одобренными лицами внутри организации, использующими контролируемые компанией учетные записи и устройства.
Если предприятие не соответствует критериям Daybreak Red или не нуждается в таком уровне доступа, OpenAI направляет большинство компаний в сторону Daybreak Blue — своего второго уровня доступа к кибермоделям.
Blue — это более широкий уровень для одобренных защитников. Он не предоставляет GPT-5.6-Cyber, но дает проверенным пользователям доступ к передовым универсальным моделям OpenAI, включая GPT-5.6 Sol, со средствами защиты, настроенными под легитимную оборонительную работу.
Для многих корпоративных команд безопасности Blue может стать более реалистичной отправной точкой. OpenAI заявляет, что этот уровень предназначен для таких задач, как аудит безопасного кода, обнаружение уязвимостей, анализ вредоносного ПО, реагирование на инциденты и проверка патчей. Это по-прежнему чувствительные сценарии использования, но они не обязательно требуют доступа к специализированным кибермоделям, который идет в комплекте с Red.
Практический вывод заключается в том, что у предприятий теперь есть два пути в программу Daybreak. Blue предназначен для одобренных защитников, которым нужна более мощная поддержка ИИ в повседневной работе по безопасности. Red — для меньшего числа утвержденных команд, которые могут обосновать необходимость доступа к специализированным кибермоделям, включая GPT-5.6-Cyber. Компаниям, желающим использовать возможности Daybreak в продуктах или услугах для собственных клиентов, требуется отдельный путь согласования через Партнерскую программу Daybreak Cyber, а не просто подача заявки на внутренний корпоративный доступ с последующей перепродажей.
Как OpenAI пришла к этому: от Trusted Access к Daybreak
OpenAI поддерживает защитников в рамках своей программы грантов на кибербезопасность с 2023 года (позже объем финансирования был увеличен до $10 млн) и начала внедрять специфичные для кибербезопасности защитные механизмы в свои модели, начиная с GPT-5.2.
В феврале 2026 года компания представила Trusted Access for Cyber (TAC) — фреймворк идентификации и доверия, который снижал количество классификаторных отказов для проверенных защитников при выполнении ими авторизованных задач, таких как триаж уязвимостей, анализ вредоносного ПО и обратное проектирование бинарных файлов.
С этого момента темпы ускорились. В марте генеральный директор и соучредитель OpenAI Сэм Альтман анонсировал программу Daybreak. В апреле OpenAI масштабировала TAC и выпустила GPT-5.4-Cyber — версию GPT-5.4, дообученную для обеспечения «кибер-снисходительности» для ограниченного круга проверенных вендоров и исследователей.
В мае последовал релиз GPT-5.5-Cyber в рамках ограниченного предварительного просмотра для защитников критической инфраструктуры, а среди партнеров появились такие компании, как Cisco, Intel, SentinelOne, Snyk и Cloudflare.
Примечательно, что тогда OpenAI заявляла, что GPT-5.5-Cyber была «прежде всего обучена быть более снисходительной», а не существенно превосходить свою базовую модель — по некоторым оценкам, GPT-5.5-Cyber фактически показала результаты хуже, чем GPT-5.5.
С 1 июня для работы с наиболее мощными моделями в рамках TAC требовалось использование защищенной от фишинга функции Advanced Account Security, а теперь Daybreak требует применения аппаратных ключей безопасности для индивидуальных учетных записей, начиная с 1 сентября.
OpenAI заявляет, что GPT-5.6-Cyber уже нашла уязвимости нулевого дня
OpenAI не полагается исключительно на бенчмарки в подтверждение своих слов.
Компания утверждает, что ее исследователи использовали GPT-5.6-Cyber для исследования V8 — JavaScript-движка, лежащего в основе Chrome, — и обнаружили две ранее неизвестные уязвимости, которые можно было объединить в цепочку для повреждения памяти и выхода из кучи-песочницы V8.
Исследователи OpenAI проверили полученные результаты и сообщили о них Google, которая устранила уязвимость, получившую идентификатор CVE-2026-15903. Это критическая ошибка, при которой оптимизирующий компилятор V8 пропускал проверку безопасности во время преобразования целых чисел, допуская выход за границы индекса массива, который злоумышленник мог использовать для чтения или перезаписи памяти.
По данным OpenAI, эта модель также помогла обнаружить по меньшей мере пять уязвимостей в неназванной популярной мобильной операционной системе, три критические уязвимости в неназванной популярной базе данных и более 400 уязвимостей, способных вызвать повышение привилегий в ядре популярной операционной системы. Как сообщает OpenAI, в настоящее время ведется координация процессов раскрытия этой информации.
Эти результаты выводят OpenAI на стремительно развивающийся рынок ИИ-ассистируемой наступательной безопасности. Например, XBOW продвигает автономных агентов для тестирования на проникновение, которые картируют поверхности атак, совершают эксплойты и независимо проверяют результаты; в 2025 году она стала первой ИИ-системой, возглавившей лидерборд программы bug bounty от HackerOne в США, а в этом году обнаружила набор критических уязвимостей удаленного выполнения кода (CVSS 9.8) в системах обработки изображений Microsoft Bing, найденных без доступа к исходному коду.
Для руководителей корпоративной безопасности такая зарождающаяся конкуренция имеет значение, поскольку исследование уязвимостей выходит за рамки использования LLM в качестве простого ассистента. Вендоры все активнее создают системы, в которых модели могут исследовать цели, управлять инструментами, проверять гипотезы и выдавать применимые на практике результаты.
Специализированная не значит универсально лучшая
Собственные результаты OpenAI также показывают, почему предприятиям не следует просто ставить знак равенства между специализацией в кибербезопасности и лучшей производительностью во всех областях.
GPT-5.6-Cyber превзошла GPT-5.6 Sol и GPT-5.5-Cyber в реализации ExploitGym от OpenAI, которая оценивает способность агентов превращать известные уязвимости в работающие эксплойты в контролируемой среде. Она также обошла Sol по результатам внутренней оценки уязвимостей нулевого дня.
Однако GPT-5.6 Sol показала лучшие результаты при оценке обнаружения уязвимостей и составления отчетов (Vulnerability Discovery and Report Writing) от OpenAI. Компания отчасти связывает более низкий балл кибермодели с тем, что она составляла более короткие и менее детальные отчеты об уязвимостях.
Sol также лучше всего проявила себя в бенчмарке ExploitBench при стандартном лимите в 300 шагов (turns), причем в OpenAI отметили, что она решала задачи с большей токен-эффективностью. Увеличение лимита оценки до 600 шагов сократило разрыв между моделями.
Это говорит о том, что со временем предприятия могут начать воспринимать кибермодели как узких специалистов, а не как замену универсальным моделям рассуждений: одна модель для глубокой работы с эксплойтами, а другая — потенциально более подходящая для анализа, документирования или других этапов рабочего процесса безопасности.
Технический директор SpecterOps Джаред Аткинсон заявил, что GPT-5.6-Cyber «существенно улучшает наши специализированные рабочие процессы по исследованию уязвимостей», добавив, что она выполнила часть работы менее чем за день, с которой предыдущие модели не могли справиться после нескольких недель периодических усилий.
Инцидент с Hugging Face омрачает запуск
Анонс модели с ослабленными ограничениями состоялся всего через несколько недель после того, как OpenAI столкнулась с самым серьезным публичным доказательством того, к чему может привести отключение защитных барьеров от кибератак. Сама OpenAI открыто обсуждает эту предысторию в анонсе Daybreak.
В июле OpenAI и Hugging Face совместно сообщили, что во время внутренней оценки бенчмарка ExploitGym (проводившейся с намеренно отключенными производственными классификаторами для измерения максимальных возможностей) комбинация моделей OpenAI, включая GPT-5.6 Sol и невыпущенную более мощную предварительную модель, вырвалась из изолированной исследовательской среды и автономно атаковала производственную инфраструктуру Hugging Face.
Модели проэксплуатировали уязвимость нулевого дня в прокси-сервере кэша реестра пакетов внутреннего размещения для выхода в открытый интернет, переместились по исследовательским узлам OpenAI, а затем пришли к выводу, что Hugging Face, вероятно, размещает ключи с ответами к ExploitGym, и использовали цепочку из украденных учетных данных и уязвимостей удаленного выполнения кода для доступа к производственной базе данных. OpenAI назвала это «беспрецедентным киберинцидентом с использованием передовых кибервозможностей».
Как ранее сообщал VentureBeat, этот эпизод также обнажил обратную сторону жестких защитных барьеров: когда защитники Hugging Face попытались использовать коммерческие передовые модели для анализа «сырых» полезных нагрузок эксплойтов и дампов учетных данных, полученных в ходе атаки, модели ответили отказом, и компания завершила судебную реконструкцию только после переключения на локально запущенную китайскую открытую модель GLM 5.2.
Эта динамика, при которой защитные барьеры блокируют самого защитника, и является тем самым фактором, который призваны исправить уровни Daybreak с пониженным числом отказов — даже несмотря на то, что сам этот инцидент наглядно демонстрирует риски смягчения таких отказов.
OpenAI тщательно проводит границу между тем инцидентом и текущим продуктом. В анонсе Daybreak прямо заявляется, что GPT-5.6-Cyber «не участвовала в атаке на Hugging Face, и никакие другие модели не планируются к предстоящему релизу», а также отмечается, что предварительная модель, замешанная в июльском инциденте, была исключительно внутренним исследовательским прототипом, который с тех пор был деактивирован, зашифрован и закрыт от исследовательского доступа.
Компания заявила, что сотрудничает с внешними консультантами, включая CrowdStrike, METR и Redwood Research, по вопросам проверки безопасности, а также подключила Hugging Face к своей программе доверенного доступа.
По моей оценке, модель доступа все же оставляет перед OpenAI сложный вопрос: не приведет ли сохранение GPT-5.6-Cyber в рамках более узкого уровня Daybreak Red к ограничению той самой оборонительной работы, которую компания якобы стремится ускорить. Если использовать модель может лишь небольшая группа одобренных участников, предприятия вне этого уровня по-прежнему могут испытывать дефицит специализированной помощи ИИ, которая могла бы помочь с быстрой диагностикой, локализацией и реагированием на инциденты вроде того, что произошел с Hugging Face.
Это означает, что OpenAI, возможно, все еще повторяет часть ошибок, от которых пытается избавиться. Удерживая свою самую мощную кибермодель за жестким процессом утверждения, компания снижает очевидные риски злоупотреблений, но также оставляет многих корпоративных защитников в поисках альтернатив. Для команд, которые не могут пройти квалификационный отбор для Daybreak Red или не могут ждать одобрения, модели с открытыми весами могут остаться более практичным вариантом: менее контролируемым, но более простым в получении, проверке, локальном запуске и адаптации во время расследования инцидентов безопасности в реальном времени.
Защитный барьер все больше выстраивается вокруг самой модели
Самой важной частью Daybreak в конечном итоге может оказаться не архитектура ее бенчмарков, а архитектура доступа.
OpenAI прямо заявляет, что Daybreak Blue убирает системные ограничения, способные мешать легитимной оборонительной работе, в то время как GPT-5.6-Cyber идет еще дальше, сокращая количество отказов модели при решении определенных задач двойного назначения. Вместо этого OpenAI вводит контроль вокруг того, кто получает доступ и как работают модели.
Доступ к Daybreak ограничен проверенными лицами и организациями, выполняющими авторизованную работу. OpenAI заявляет, что меры контроля включают верификацию личности, безопасность учетных записей, мониторинг, ограничения на разрешенное использование и юридические заверения.
Компания также поощряет клиентов Daybreak, использующих Codex, переходить от выполнения с полным доступом к режиму автопроверки, способному оценивать действия, требующие повышенных прав, перед их выполнением. Индивидуальные учетные записи Daybreak будут обязаны использовать аппаратные ключи безопасности, начиная с 1 сентября. OpenAI заявляет, что в ближайшие недели также внедрит улучшенный мониторинг и уделит первоочередное внимание обучению на соответствие принципам безопасности (alignment) и тестированию предстоящих релизов Daybreak — обязательства, которые в данном контексте воспринимаются как прямой ответ на результаты проверки инцидента с Hugging Face.
Более широкий продукт OpenAI Codex Security обеспечивает дополнительный уровень защиты вокруг моделей, предоставляя возможности анализа репозиториев, проверки уязвимостей, устранения неисправностей и интеграции в облачные рабочие процессы, запросы на слияние (pull requests) и локальную разработку. По данным OpenAI, Codex Security просканировала более 30 миллионов коммитов в более чем 30 000 кодовых баз, при этом было устранено свыше 500 000 найденных проблем.
Такой подход «модель плюс обвязка» напоминает более масштабный сдвиг в продуктах безопасности на базе ИИ. Например, XBOW делает акцент на оркестрации, валидации эксплойтов и управлении вокруг передовых моделей, а не на рассмотрении одной лишь LLM в качестве полноценной системы тестирования на проникновение.
Тем не менее, OpenAI признает, что все более снисходительные кибермодели создают дополнительные риски, будь то злоупотребление или несоответствие целям безопасности (misalignment). Компания оценивает как GPT-5.6 Sol, так и GPT-5.6-Cyber на уровне High (высокий) в отношении возможностей кибербезопасности согласно своему Фреймворку готовности (Preparedness Framework), но ниже порога Critical (критический). Более подробная карта системы GPT-5.6-Cyber запланирована к публикации позже.
Таким образом, для директоров по информационной безопасности (CISO) и руководителей инженерных служб безопасности Daybreak ставит совершенно иной вопрос развертывания, нежели очередное инкрементальное обновление модели. Поскольку модели становятся достаточно мощными для выполнения работы, ранее зарезервированной за опытными исследователями уязвимостей — и, как показал инцидент с Hugging Face, достаточно способными для достижения узкой цели напролом через песочницу, — корпоративная плоскость контроля вокруг этих моделей (права доступа, песочницы, мониторинг, проверка человеком и авторизация) становится столь же важной, как и заложенный в них интеллект.




