


Mamba 3 с открытым исходным кодом превосходит архитектуру Transformer благодаря улучшению языкового моделирования почти на 4% и снижению задержки


Эра генеративного искусственного интеллекта для большинства началась с запуска ChatGPT от OpenAI в конце 2022 года, однако лежащая в ее основе технология — архитектура нейросетей «Трансформер» (Transformer), позволяющая ИИ-моделям взвешивать важность разных слов в предложении (или пикселей на изображении) и обучать информацию параллельно, — восходит к эпохальной работе Google 2017 года «Attention Is All You Need» («Внимания все, что вам нужно»).
Тем не менее, несмотря на то что Трансформеры обеспечивают непревзойденное качество моделей и лежат в основе большинства основных генеративных ИИ-моделей, используемых сегодня, они крайне прожорливы в плане вычислений. Они обременены квадратичными вычислительными требованиями и линейными требованиями к памяти, из-за чего крупномасштабный инференс превращается в дорогое, а зачастую и непосильное предприятие. Отсюда и стремление некоторых исследователей усовершенствовать их, разработав в 2023 году новую архитектуру — Mamba, которая впоследствии была включена в гибридные модели Mamba-Transformer, такие как Nvidia Nemotron 3 Super.
Теперь те же исследователи, что стояли за оригинальной архитектурой Mamba, включая ее лидеров Альберта Гу из Университета Карнеги — Меллона и Три Дао из Принстона, выпустили новейшую версию своей новой архитектуры — Mamba-3 — в качестве языковой модели под мягкой открытой лицензией Apache 2.0, сделав ее сразу доступной для разработчиков, включая предприятия для коммерческих целей. Технический документ также был опубликован на arXiv.org.
Эта модель знаменует собой смену парадигмы от эффективности обучения к дизайну с приоритетом инференса («inference-first»). Как отметил Гу в официальном анонсе, если Mamba-2 была сосредоточена на преодолении узких мест предварительного обучения, то Mamba-3 призвана решить проблему «холодного GPU»: реальность, при которой во время декодирования современное железо часто простаивает в ожидании передачи данных из памяти, а не выполняет вычисления.
Перплексия (нет, не компания) и обретенная эффективность Mamba 3
Mamba, включая Mamba 3, представляет собой тип моделей пространства состояний (State Space Models, SSM).
По сути, это высокоскоростная «машина для создания резюме» для ИИ. В то время как многие популярные модели (например, те, что лежат в основе ChatGPT) должны заново просматривать каждое отдельное слово, которое они уже видели, чтобы понять, что будет дальше (что становится тем медленнее и дороже, чем дольше длится разговор), SSM поддерживает компактное, постоянно меняющееся внутреннее состояние. Это состояние представляет собой цифровой «мысленный снимок» всей истории данных.
По мере поступления новой информации модель просто обновляет этот снимок вместо того, чтобы перечитывать всё с самого начала. Это позволяет ИИ обрабатывать огромные объемы информации, такие как целые библиотеки книг или длинные цепочки ДНК, с невероятной скоростью и гораздо меньшими требованиями к памяти.
Чтобы оценить качественный скачок, который представляет собой Mamba-3, нужно сначала понять перплексию — основной показатель, используемый в исследовании для измерения качества модели.
В контексте языкового моделирования перплексия — это мера того, насколько модель «удивлена» новыми данными.
Представьте модель в виде профессионального игрока. Если у модели высокая перплексия, она не уверена, куда делать ставки; она видит множество возможных следующих слов как одинаково вероятные.
Более низкий показатель перплексии указывает на то, что модель более «уверенна» — она лучше понимает глубинные паттерны человеческого языка. Для разработчиков ИИ перплексия служит высокоточным прокси-показателем интеллекта.
Прорыв, о котором сообщается в исследовании Mamba-3, заключается в том, что она достигает сопоставимой с предшественницей Mamba-2 перплексии, используя при этом вдвое меньший размер состояния. Это означает, что модель может быть столь же умной и при этом в два раза более эффективной в работе.
Новая философия
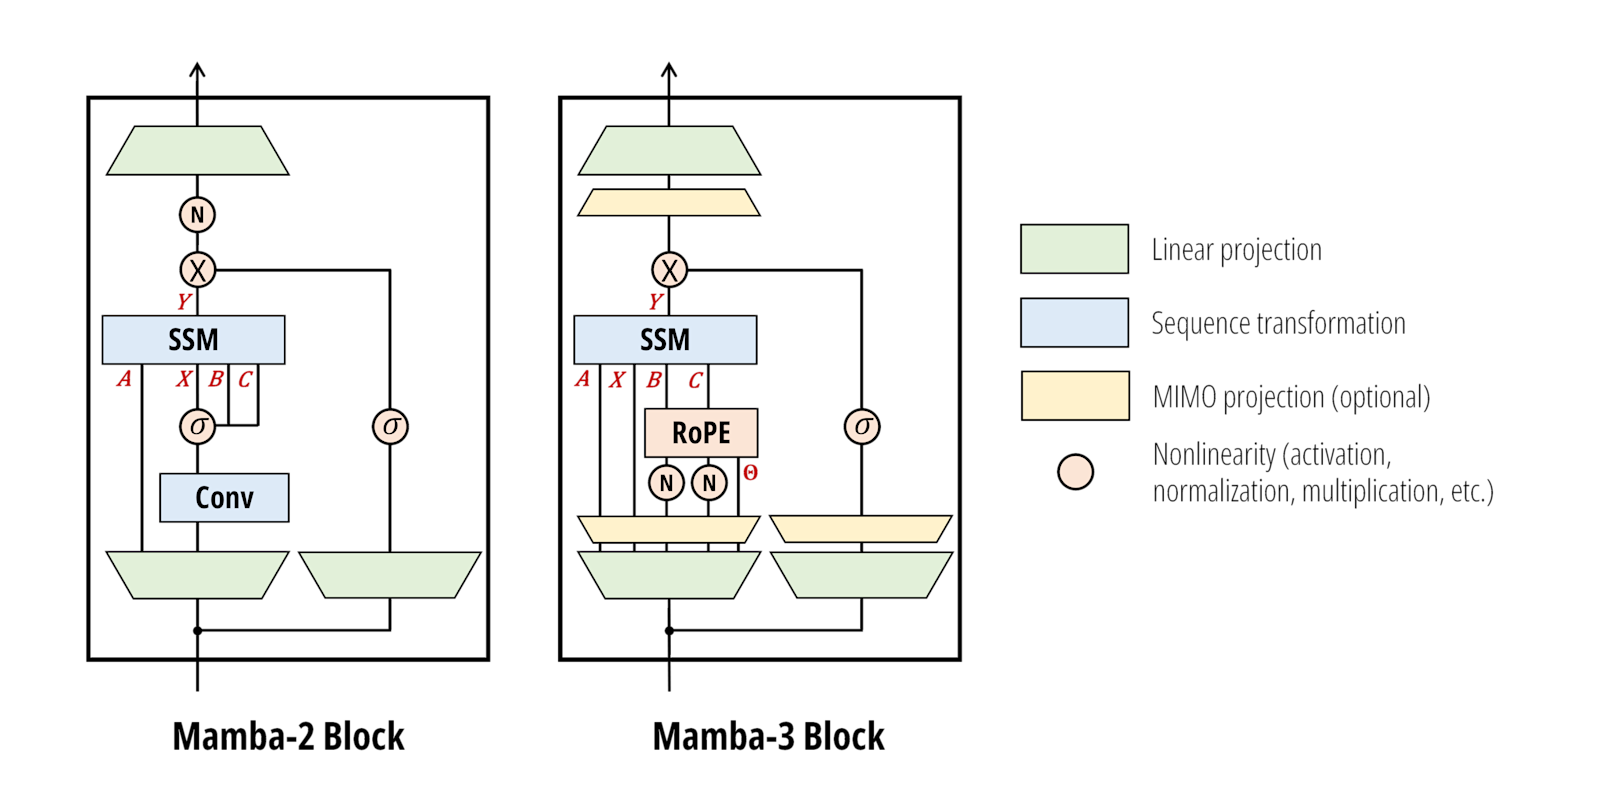
Схема архитектуры Mamba 3. Источник: Три Дао
Философия, лежащая в основе Mamba-3, представляет собой фундаментальный сдвиг в том, как мы смотрим на «интеллект» ИИ по сравнению со скоростью аппаратного обеспечения, на котором он работает. Если предыдущее поколение, Mamba-2, было разработано для обучения на рекордных скоростях, то Mamba-3 — это архитектура с приоритетом инференса (под инференсом понимается способ предоставления ИИ-моделей конечным пользователям через такие сайты, как ChatGPT или Google Gemini, либо через программные интерфейсы приложений (API)).
Главная цель Mamba-3 — максимально задействованную каждую секунду работы компьютерного чипа (GPU), гарантируя, что модель думает изо всех сил, не заставляя пользователя ждать ответа.
В мире языковых моделей каждая крупица точности дается с трудом. При масштабе в 1,5 миллиарда параметров самый продвинутый вариант «MIMO» модели Mamba-3 достиг средней точности 57,6% по бенчмаркам, что представляет собой скачок на 2,2 процентных пункта по сравнению со стандартным для индустрии Трансформером.
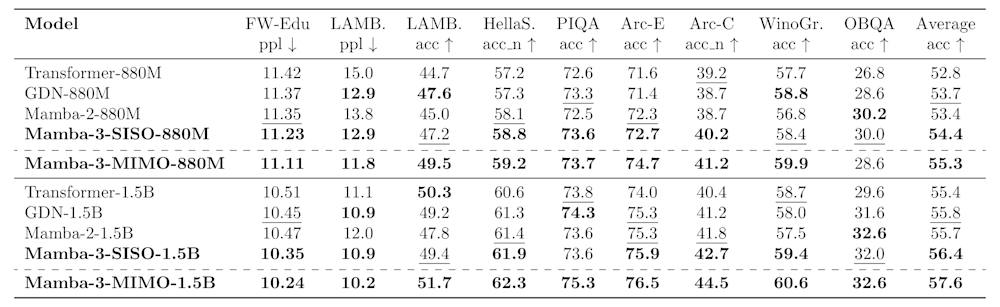
Сравнительная диаграмма бенчмарков Mamba 3. Источник: Акаш Лахоти, Кевин Ю. Ли, Берлин Чен, Кейтлин Ван, Авив Бик, Д. Зико Колтер, Три Дао, Альберт Гу
Хотя двухпроцентный скачок может показаться скромным, на самом деле он представляет собой почти 4-процентное относительное увеличение возможностей языкового моделирования по сравнению с базовой моделью Transformer. Еще более впечатляюще то, что, как упоминалось выше, Mamba-3 может соответствовать предсказательному качеству своей предшественницы, используя при этом лишь половину внутреннего «размера состояния», эффективно обеспечивая тот же уровень интеллекта со значительно меньшей задержкой памяти.
Годами эффективные альтернативы Трансформерам страдали от «логического пробела» — они часто терпели неудачу при выполнении простейших задач на рассуждение, таких как отслеживание паттернов или решение базовой арифметики, потому что их внутренняя математика была слишком жесткой. Mamba-3 решает эту проблему за счет внедрения комплексных (комплекснозначных) состояний.
Это математическое обновление действует как внутренний компас, позволяя модели представлять «вращательную» логику. Используя этот «поворотный» подход, Mamba-3 может практически идеально решать логические головоломки и задачи на отслеживание состояния, которые ее предшественницы могли только угадывать, наконец-то сравняв линеаризованные модели по мощности рассуждений с самыми передовыми системами.
Последний элемент головоломки — то, как Mamba-3 взаимодействует с физическим железом. Большинство современных ИИ-моделей «ограничены памятью» (memory-bound), что означает, что чип компьютера большую часть времени простаивает в ожидании перемещения данных из памяти в процессор.
Mamba-3 представляет формулировку «Множественный ввод, множественный вывод» (Multi-Input, Multi-Output, MIMO), которая коренным образом меняет эту динамику. Выполняя до четырех раз больше математических операций параллельно на каждом шаге, Mamba-3 задействует эту ранее «простаивавшую» мощность. Это позволяет модели выполнять значительно больше «размышлений» для каждого генерируемого слова без увеличения реального времени ожидания ответа пользователем. Подробнее об этом ниже.
Три новых технологических скачка
Привлекательность линейных моделей всегда заключалась в их постоянных требованиях к памяти и линейном масштабировании вычислений.
Однако, как отмечают авторы Mamba 3, «бесплатного сыра не бывает». Фиксируя размер состояния для обеспечения эффективности, эти модели вынуждены сжимать весь исторический контекст в единое представление — прямо противоположное постоянно растущему KV-кешу Трансформера. Mamba-3 задействует три конкретных рычага, чтобы заставить это фиксированное состояние выполнять больше работы.
1. Экспоненциально-трапецеидальная дискретизация
Модели пространства состояний — это по своей сути системы с непрерывным временем, которые необходимо «дискретизировать» для работы с дискретными последовательностями цифровых данных.
Предыдущие итерации опирались на экспоненциально-эйлерову дискретизацию (Exponential-Euler) — эвристику, обеспечивавшую лишь аппроксимацию системы первого порядка.
Mamba-3 представляет обобщенное правило трапеций, обеспечивающее аппроксимацию со второй степенью точности. Это не просто математическое усовершенствование; оно индуцирует «неявную свертку» внутри базовой рекуррентности.
Соединив это с явными членами смещения B и C, исследователи смогли избавиться от короткой причинной свертки, которая годами была непременным атрибутом рекуррентных архитектур.
2. Комплекснозначные SSM и «трюк с поворотом» (RoPE Trick)
Одной из самых стойких претензий к линейным моделям была их неспособность решать простые задачи отслеживания состояний, такие как определение четности последовательности битов.
Этот сбой проистекает из ограничения переходной матрицы вещественными числами, что мешает модели представлять «вращательную» динамику. Mamba-3 преодолевает это, рассматривая базовую SSM как комплексную (комплекснозначную).
Используя то, что команда называет «трюком RoPE», они демонстрируют, что комплексное обновление состояния математически эквивалентно поворотному встраиванию с учетом данных (RoPE), применяемому к входным и выходным проекциям.
Это позволяет Mamba-3 решать синтетические задачи на рассуждение, которые были невозможны для Mamba-2.
3. MIMO: Повышение арифметической интенсивности
Самый значительный скачок в эффективности инференса связан с переходом от моделей с одним входом и одним выходом (SISO) к SSM с множественным вводом и множественным выводом (MIMO).
В стандартной SSM обновление состояния представляет собой операцию внешнего произведения, сильно зависящую от памяти. Переходя к обновлению состояния на основе матричного умножения, Mamba-3 увеличивает «арифметическую интенсивность» модели — соотношение операций с плавающей запятой (FLOPs) к трафику памяти.
Это позволяет модели выполнять больше вычислений во время фазы декодирования, ограниченной памятью. По сути, Mamba-3 использует «простаивающие» вычислительные ядра графического процессора для повышения мощности модели «бесплатно», сохраняя ту же скорость декодирования, что и ее более простые предшественники.
Что Mamba 3 означает для предприятий и разработчиков ИИ
Для предприятий Mamba-3 представляет собой стратегический сдвиг в общей стоимости владения (TCO) для развертывания ИИ.
-
Стоимость против производительности: При сопоставимых параметрах производительности Mamba-3 (MIMO) соответствует перплексии Mamba-2, используя при этом вдвое меньший размер состояния. Для корпоративного развертывания это фактически удваивает пропускную способность инференса при том же аппаратном обеспечении.
-
Агентные рабочие процессы: По мере того как организации переходят к параллельным агентным рабочим процессам (таким как автоматизированное написание кода или агенты обслуживания клиентов в реальном времени), спрос на генерацию с низкой задержкой экспоненциально возрастает. Mamba-3 разработана специально для того, чтобы аппаратное обеспечение GPU не простаивало «вхолостую» во время выполнения таких задач.
-
Гибридное преимущество: Исследователи предсказывают, что будущее корпоративного ИИ лежит в области гибридных моделей. Переплетая Mamba-3 со сфлш-вниманием (self-attention), организации могут объединить эффективную «память» SSM с точным «базовым» хранилищем Трансформеров.
Препятствия на пути к внедрению — и как Mamba 3 смягчает их
Архитектура Mamba, хотя и превосходит по масштабируемости теоретически, до сих пор не вытеснила Трансформер главным образом из-за «парадокса тензорных ядер» и значительного отставания в зрелости экосистемы.
Несмотря на свою линейную сложность O(L), ранние итерации Mamba с трудом задействовали тензорные ядра Nvidia (Tensor Cores), которые специально созданы для плотных матричных умножений, определяющих Трансформеры. В то время как Трансформеры обычно достигают 80–90% аппаратной утилизации, рекуррентный, перегруженный скалярами характер SSM часто приводил к тому, что Mamba-1 выдавала пиковую загрузку всего в 10–15%.
Этот разрыв в «арифметической интенсивности» означал, что на практике Трансформеры часто обучались быстрее, несмотря на их худшую теоретическую сложность.
Хотя Mamba-3 в значительной степени сгладила это за счет обновлений MIMO (Multi-Input Multi-Output) и двойственности пространств состояний (State Space Duality — математического переосмысления SSM как «линейного внимания», которое тензорные ядра могут переваривать), аппаратно-программный стек для Трансформеров слишком укоренился, чтобы быть свергнутым в одночасье.
Помимо чистой утилизации железа, Mamba сталкивается с ограничением «логики и преданности». Большинство промышленных законов масштабирования, фреймворков безопасности и оптимизационных библиотек (таких как FlashAttention, квантование GGUF и LoRA) были созданы исключительно для парадигмы KV-кеша Трансформера.
Квантование Mamba по-прежнему остается печально известной сложной задачей; стандартные 4-битные методы часто вызывают падение точности на двузначные величины, поскольку механизм параллельного сканирования Mamba усиливает числовые выбросы, которые Трансформеры могут легко проигнорировать.
Кроме того, чистые модели Mamba по-прежнему отстают в обучении в контексте (In-Context Learning, ICL) — способности «учиться» на примерах в промпте. Исследования показывают, что, хотя Mamba-3 почти на 4% эффективнее в сыром языковом моделировании, она по-прежнему испытывает трудности с задачами «копирования» и многошагового рассуждения, с которыми механизм внимания справляется нативно.
Следовательно, индустрия не столько «переходит» на Mamba, сколько «поглощает» ее; текущий технологический авангард сместился в сторону гибридных архитектур (таких как семейство Nvidia Nemotron-3), которые чередуют слои Mamba для эффективности работы с длинным контекстом и ровно с тем количеством слоев Attention, которое необходимо для поддержания «поиска наподобие базы данных» и рассуждений.
Доступность, лицензирование и использование
Mamba-3 — это не просто теоретическая научно-исследовательская работа; это полноценный релиз с открытым исходным кодом, готовый к немедленному использованию, код которого опубликован на Github.
Проект выпущен под лицензией Apache-2.0. Это мягкая, дружелюбная к бизнесу лицензия, разрешающая бесплатное использование, модификацию и коммерческое распространение без требования раскрывать исходный код проприетарного софта.
Этот релиз хорош для разработчиков, создающих приложения с длинным контекстом, агентов для рассуждений в реальном времени или стремящихся снизить затраты на GPU в условиях высоконагруженных производственных сред.
Лидерство в революции моделей пространств состояний (SSM)
Релиз был встречен с энтузиазмом в социальных сетях, особенно в отношении «студенческого» характера проекта. Гу, биографе которого в X/Twitter написано, что он «возглавляет SSM-революцию», отдал должное студентам-лидерам, включая Акаша Лахоти и Кевина Ю. Ли.
В своей ветке Гу подчеркнул удовлетворение команды дизайном модели:
«Мы весьма довольны финальным дизайном модели! Три ключевых методологических изменения вдохновлены (по моему мнению) элегантной математикой и методами».
Поскольку агентные рабочие процессы поднимают спрос на инференс «выше крыши», появление Mamba-3 говорит о том, что будущее ИИ может заключаться не только в наличии самой большой модели, но и в наличии самой эффективной.
Mamba-3 успешно перенастроила SSM под реалии современного железа, доказав, что даже в эпоху Трансформеров принципы классической теории управления по-прежнему играют жизненно важную роль.




