


Новая модель Nvidia с открытыми весами Nemotron 3 объединяет три различные архитектуры, чтобы превзойти gpt-oss и Qwen по пропускной способности


Мультиагентные системы, предназначенные для решения долгосрочных задач, таких как разработка программного обеспечения или кибербезопасность, могут генерировать объем токенов, в 15 раз превышающий показатели стандартных чат-ботов, что ставит под угрозу их экономическую эффективность при обработке корпоративных задач.
Но сегодня компания Nvidia попыталась помочь решить эту проблему, выпустив Nemotron 3 Super — гибридную модель со 120 миллиардами параметров, веса которой опубликованы на Hugging Face.
Объединяя различные архитектурные подходы — модели пространства состояний, трансформеры и инновационную конструкцию «латентной» смеси экспертов (Latent Mixture-of-Experts), — Nvidia стремится обеспечить специализированную глубину, необходимую для агентных рабочих процессов, без избыточности, типичной для плотных моделей рассуждений, причем все это доступно для коммерческого использования на условиях преимущественно открытых весов.
Тройная гибридная архитектура
В основе Nemotron 3 Super лежит сложная архитектурная триада, которая балансирует между эффективностью использования памяти и точностью рассуждений. Модель использует гибридную магистраль Mamba-Transformer, которая чередует слои Mamba-2 со стратегическими слоями внимания трансформера.
Чтобы понять последствия для корпоративного производства, рассмотрите проблему «иголки в стоге сена». Слои Mamba-2 действуют как система скоростных магистралей, обрабатывая подавляющее большинство последовательностей с линейной временной сложностью. Это позволяет модели поддерживать массивное окно контекста на 1 миллион токенов без взрывного роста объема памяти кэша KV. Тем не менее, чистые модели пространства состояний часто испытывают трудности с ассоциативным извлечением.
Чтобы исправить это, Nvidia стратегически внедряет слои внимания трансформера в качестве «глобальных якорей», гарантируя, что модель сможет точно извлекать конкретные факты, скрытые глубоко в кодовой базе или стопке финансовых отчетов.
Помимо магистрали, в модели представлена латентная смесь экспертов (LatentMoE). Традиционные архитектуры смеси экспертов (MoE) направляют токены к экспертам в их полном скрытом измерении, что создает вычислительное «бутылочное горлышко» по мере масштабирования моделей. LatentMoE решает эту проблему путем проекции токенов в сжатое пространство перед их направлением к специалистам.
Такое «экспертное сжатие» позволяет модели обращаться к четырем специалистам одновременно при той же вычислительной стоимости. Эта детализация жизненно важна для агентов, которым необходимо переключаться между синтаксисом Python, логикой SQL и разговорными рассуждениями в рамках одного запроса.
Дальнейшее ускорение модели обеспечивается за счет многотокенового прогнозирования (Multi-Token Prediction — MTP). В то время как стандартные модели прогнозируют один следующий токен, MTP прогнозирует несколько будущих токенов одновременно. Это служит «встроенной черновой моделью», обеспечивая нативное спекулятивное декодирование, которое может обеспечить до 3-кратного ускорения реального времени для структурированных задач генерации, таких как код или вызовы инструментов.
Преимущество Blackwell
Для бизнеса самым значительным техническим скачком в Nemotron 3 Super является ее оптимизация под графическую платформу Nvidia Blackwell. Проведя предварительное обучение нативно в формате NVFP4 (4-битная плавающая запятая), Nvidia совершила прорыв в производственной эффективности.
На платформе Blackwell модель обеспечивает вывод в 4 раза быстрее по сравнению с 8-битными моделями, работающими на предыдущей архитектуре Hopper, без потери точности.
С точки зрения практической производительности, Nemotron 3 Super представляет собой специализированный инструмент для агентных рассуждений.
В настоящее время она занимает первое место в бенчмарке DeepResearch Bench, который измеряет способность ИИ проводить тщательные многоэтапные исследования по крупным наборам документов.
|
Бенчмарк |
Nemotron 3 Super |
Qwen3.5-122B-A10B |
GPT-OSS-120B |
|
Общие знания |
|||
|
MMLU-Pro |
83.73 |
86.70 |
81.00 |
|
Рассуждения |
|||
|
AIME25 (без инструментов) |
90.21 |
90.36 |
92.50 |
|
HMMT Фев 25 (без инструментов) |
93.67 |
91.40 |
90.00 |
|
HMMT Фев 25 (с инструментами) |
94.73 |
89.55 |
— |
|
GPQA (без инструментов) |
79.23 |
86.60 |
80.10 |
|
GPQA (с инструментами) |
82.70 |
— |
80.09 |
|
LiveCodeBench (v5 2024-07↔2024-12) |
81.19 |
78.93 |
88.00 |
|
SciCode (подзадача) |
42.05 |
42.00 |
39.00 |
|
HLE (без инструментов) |
18.26 |
25.30 |
14.90 |
|
HLE (с инструментами) |
22.82 |
— |
19.0 |
|
Агентные возможности |
|||
|
Terminal Bench (сложное подмножество) |
25.78 |
26.80 |
24.00 |
|
Terminal Bench Core 2.0 |
31.00 |
37.50 |
18.70 |
|
SWE-Bench (OpenHands) |
60.47 |
66.40 |
41.9 |
|
SWE-Bench (OpenCode) |
59.20 |
67.40 |
— |
|
SWE-Bench (Codex) |
53.73 |
61.20 |
— |
|
SWE-Bench Multilingual (OpenHands) |
45.78 |
— |
30.80 |
|
TauBench V2 |
|||
|
Airline |
56.25 |
66.0 |
49.2 |
|
Retail |
62.83 |
62.6 |
67.80 |
|
Telecom |
64.36 |
95.00 |
66.00 |
|
Среднее |
61.15 |
74.53 |
61.0 |
|
BrowseComp с поиском |
31.28 |
— |
33.89 |
|
BIRD Bench |
41.80 |
— |
38.25 |
|
Чат и следование инструкциям |
|||
|
IFBench (промпт) |
72.56 |
73.77 |
68.32 |
|
Scale AI Multi-Challenge |
55.23 |
61.50 |
58.29 |
|
Arena-Hard-V2 |
73.88 |
75.15 |
90.26 |
|
Длинный контекст |
|||
|
AA-LCR |
58.31 |
66.90 |
51.00 |
|
RULER @ 256k |
96.30 |
96.74 |
52.30 |
|
RULER @ 512k |
95.67 |
95.95 |
46.70 |
|
RULER @ 1M |
91.75 |
91.33 |
22.30 |
|
Многоязычность |
|||
|
MMLU-ProX (среднее по языкам) |
79.36 |
85.06 |
76.59 |
|
WMT24++ (en→xx) |
86.67 |
87.84 |
88.89 |
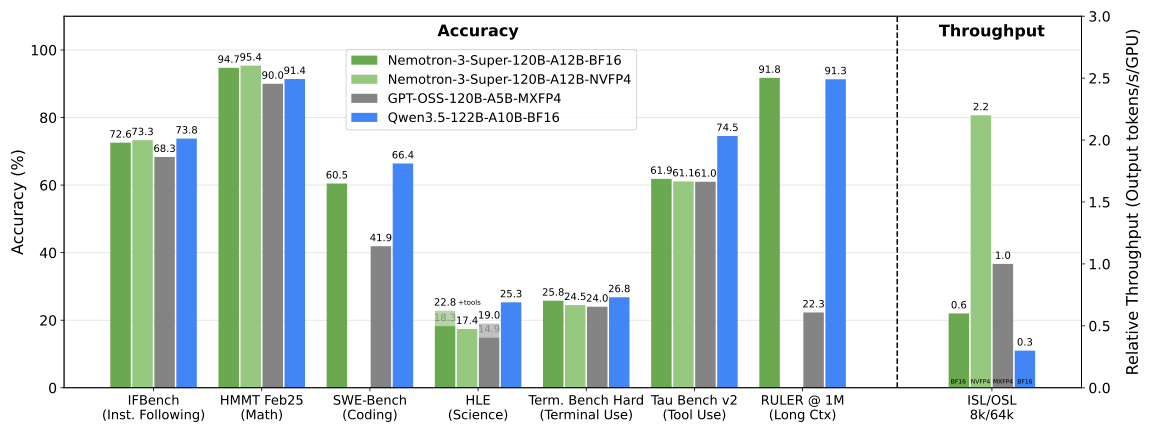
Она также демонстрирует значительные преимущества в пропускной способности, достигая в условиях высокой нагрузки показателя, превышающего gpt-oss-120B в 2,2 раза, а Qwen3.5-122B — в 7,5 раз.
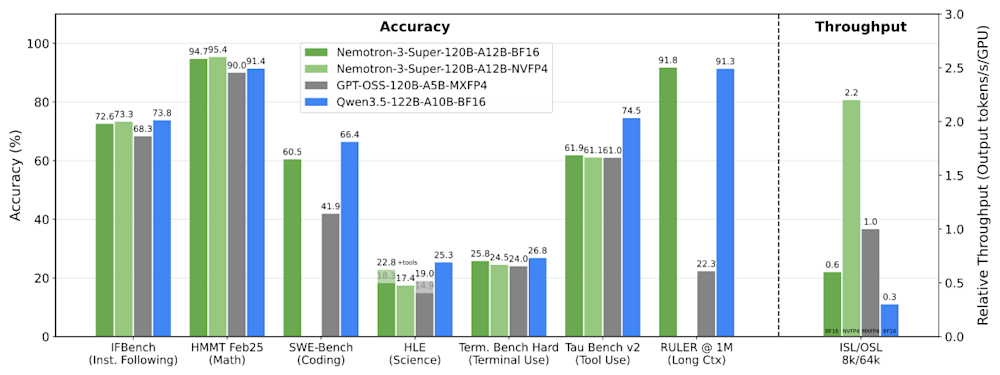
График основных бенчмарков Nvidia Nemotron 3 Super. Nvidia
Кастомная «открытая» лицензия: коммерческое использование, но с важными оговорками
Выпуск Nemotron 3 Super на условиях лицензионного соглашения Nvidia Open Model License Agreement (обновлено в октябре 2025 года) предоставляет благоприятную основу для внедрения на предприятиях, хотя оно содержит четкие пункты о «средствах защиты», которые отличают его от чисто открытых лицензий, таких как MIT или Apache 2.0.
Ключевые положения для корпоративных пользователей:
-
Коммерческая применимость: Лицензия прямо указывает, что модели являются «пригодными для коммерческого использования» и предоставляет бессрочную, всемирную, безвозмездную лицензию на продажу и распространение продуктов, созданных на базе модели.
-
Права на результаты: Nvidia не претендует на результаты, сгенерированные моделью; ответственность за эти результаты и права на них целиком и полностью лежат на пользователе.
-
Производные работы: Предприятия могут свободно создавать и владеть «производными моделями» (дообученными версиями) при условии включения обязательного уведомления об авторстве: «Лицензировано корпорацией Nvidia по лицензии Nvidia Open Model License».
«Красные линии»:
Лицензия включает два критических условия прекращения действия, за которыми производственные команды должны следить:
-
Предохранительные барьеры безопасности (Guardrails): Лицензия автоматически аннулируется, если пользователь обходит или уклоняется от «защитных барьеров» модели (технических ограничений или гиперпараметров безопасности) без внедрения «существенно аналогичной» замены, подходящей для данного варианта использования.
-
Триггер судебного разбирательства: Если пользователь инициирует судебный иск против Nvidia в отношении авторских прав или патентов, утверждая, что модель нарушает их интеллектуальную собственность, его лицензия на использование модели немедленно прекращает свое действие.
Такая структура позволяет Nvidia развивать коммерческую экосистему, защищая себя от «патентного троллинга» и гарантируя, что модель не будет лишена функций безопасности в злонамеренных целях.
«Команда потрудилась на славу»
Релиз вызвал значительный резонанс в сообществе разработчиков. Крис Алекьюк (Chris Alexiuk), старший инженер по исследованию продуктов в Nvidia, приветствовал запуск в X под ником @llm_wizard как «СУПЕРДЕНЬ», подчеркнув скорость и прозрачность модели. «Модель: БЫСТРАЯ. Модель: УМНАЯ. Модель: САМАЯ ОТКРЫТАЯ ИЗ ВСЕХ, ЧТО МЫ СОЗДАЛИ», — написал Крис, отметив выпуск не только весов, но и 10 триллионов токенов обучающих данных и рецептов.
Отраслевое внедрение отражает этот энтузиазм:
-
Облако и аппаратное обеспечение: Модель развертывается в виде микросервиса Nvidia NIM, что позволяет запускать ее локально через Dell AI Factory или HPE, а также в Google Cloud, Oracle и в скором времени в AWS и Azure.
-
Производственные агенты: Такие компании, как CodeRabbit (разработка программного обеспечения) и Greptile, интегрируют модель для масштабного анализа кодовой базы, в то время как лидеры промышленности, такие как Siemens и Palantir, развертывают ее для автоматизации сложных рабочих процессов в производстве и кибербезопасности.
Как отметила Кари Бриски (Kari Briski), вице-президент Nvidia по ИИ-программному обеспечению: «По мере того как компании выходят за рамки чат-ботов и переходят к мультиагентным приложениям, они сталкиваются с… взрывом контекста».
Nemotron 3 Super — это ответ Nvidia на этот взрыв: модель, которая обеспечивает «мозговой потенциал» системы со 120 миллиардами параметров при операционной эффективности гораздо более мелкого специалиста. Для бизнеса вывод очевиден: «налог на мышление» наконец-то снижается.




