


Mistral Small 4 объединяет модели для предприятий


Предприятиям, которым приходилось использовать разные модели для логических выводов, мультимодальных задач и написания кода агентами, возможно, удастся упростить свой стек: новая модель Small 4 от Mistral объединяет все три функции в одной открытой модели с регулируемыми уровнями логического рассуждения «под капотом».
Small 4 пополняет ряды многочисленных небольших моделей — включая Qwen и Claude Haiku, — которые конкурируют в области стоимости инференса и производительности в бенчмарках. Главное предложение Mistral: более короткие ответы, которые обеспечивают меньшую задержку и более дешевые токену.
Mistral Small 4 обновляет Mistral Small 3.2, вышедшую в июне 2025 года, и доступна по лицензии Apache 2.0. «С появлением Small 4 пользователям больше не нужно выбирать между быстрой инструктивной моделью, мощным механизмом рассуждений или мультимодальным ассистентом: теперь одна модель обеспечивает все три возможности, предлагая настраиваемую интенсивность логических выводов и лучшую в своем классе эффективность», — говорится в блоге Mistral.
Компания заявила, что, несмотря на свой небольшой размер (Mistral Small 4 имеет 119 миллиардов общих параметров при всего 6 миллиардах активных параметров на токен), модель объединяет возможности всех моделей Mistral. Она обладает способностями к рассуждению Magistral, мультимодальным пониманием Pixtral и производительностью при написании кода Devstral. Она также имеет контекстное окно на 256 тыс. токенов, которое, по словам компании, отлично подходит для объемных диалогов и анализа.
Роб Мэй (Rob May), соучредитель и генеральный директор маркетплейса малых языковых моделей Neurometric, рассказал VentureBeat, что Mistral Small 4 выделяется своей архитектурной гибкостью. Тем не менее, она пополняет ряды растущего числа небольших моделей, которые, по его словам, рискуют внести еще большую фрагментацию на рынок.
«С технической точки зрения, да, она может быть конкурентоспособной по сравнению с другими моделями, — сказал Мэй. — Более серьезная проблема заключается в том, что ей приходится преодолевать путаницу на рынке. Mistral должна завоевать авторитет у аудитории, чтобы сначала получить шанс попасть в этот набор для тестирования. Только после этого они смогут продемонстрировать технические возможности модели».
Рассуждения по запросу
Небольшие модели по-прежнему предлагают хорошие варианты для корпоративных разработчиков, стремящихся получить те же возможности LLM при меньших затратах.
Модель построена на архитектуре «мощности экспертов» (mixture-of-experts), во многом похожей на другие модели Mistral. В ней насчитывается 128 экспертов, из которых четыре активны для каждого токена, что, по словам Mistral, обеспечивает эффективное масштабирование и специализацию.
Это позволяет Mistral Small 4 реагировать быстрее даже на задачи, требующие более интенсивных логических выводов. Она также может обрабатывать текст и изображения и делать на их основе выводы, позволяя пользователям разбирать документы и графики.
В Mistral сообщили, что модель оснащена новым параметром под названием reasoning_effort, который позволяет пользователям «динамически настраивать поведение модели». Предприятия смогут настроить Small 4 так, чтобы она выдавала быстрые и легкие ответы в стиле Mistral Small 3.2 или же более подробные в духе Magistral, обеспечивая пошаговые рассуждения для сложных задач, отмечают в Mistral.
По словам представителей Mistral, Small 4 работает на меньшем количестве чипов, чем сопоставимые модели: рекомендуемая конфигурация включает четыре ускорителя Nvidia HGX H100 или H200 либо два Nvidia DGX B200.
«Создание передовых открытых моделей ИИ требует масштабной оптимизации. Благодаря тесному сотрудничеству с Nvidia инференс был оптимизирован как для открытого исходного кода vLLM, так и для SGLang, что обеспечивает эффективное обслуживание с высокой пропускной способностью в различных сценариях развертывания», — заявили в Mistral.
Результаты тестов (бенчмарков)
Судя по бенчмаркам Mistral, Small 4 работает на уровне, близком к Mistral Medium 3.1 и Mistral Large 3, особенно в тесте MMLU Pro.
В Mistral отметили, что показатели точности выполнения инструкций делают Small 4 подходящей для ресурсоемких корпоративных задач, таких как понимание документов.
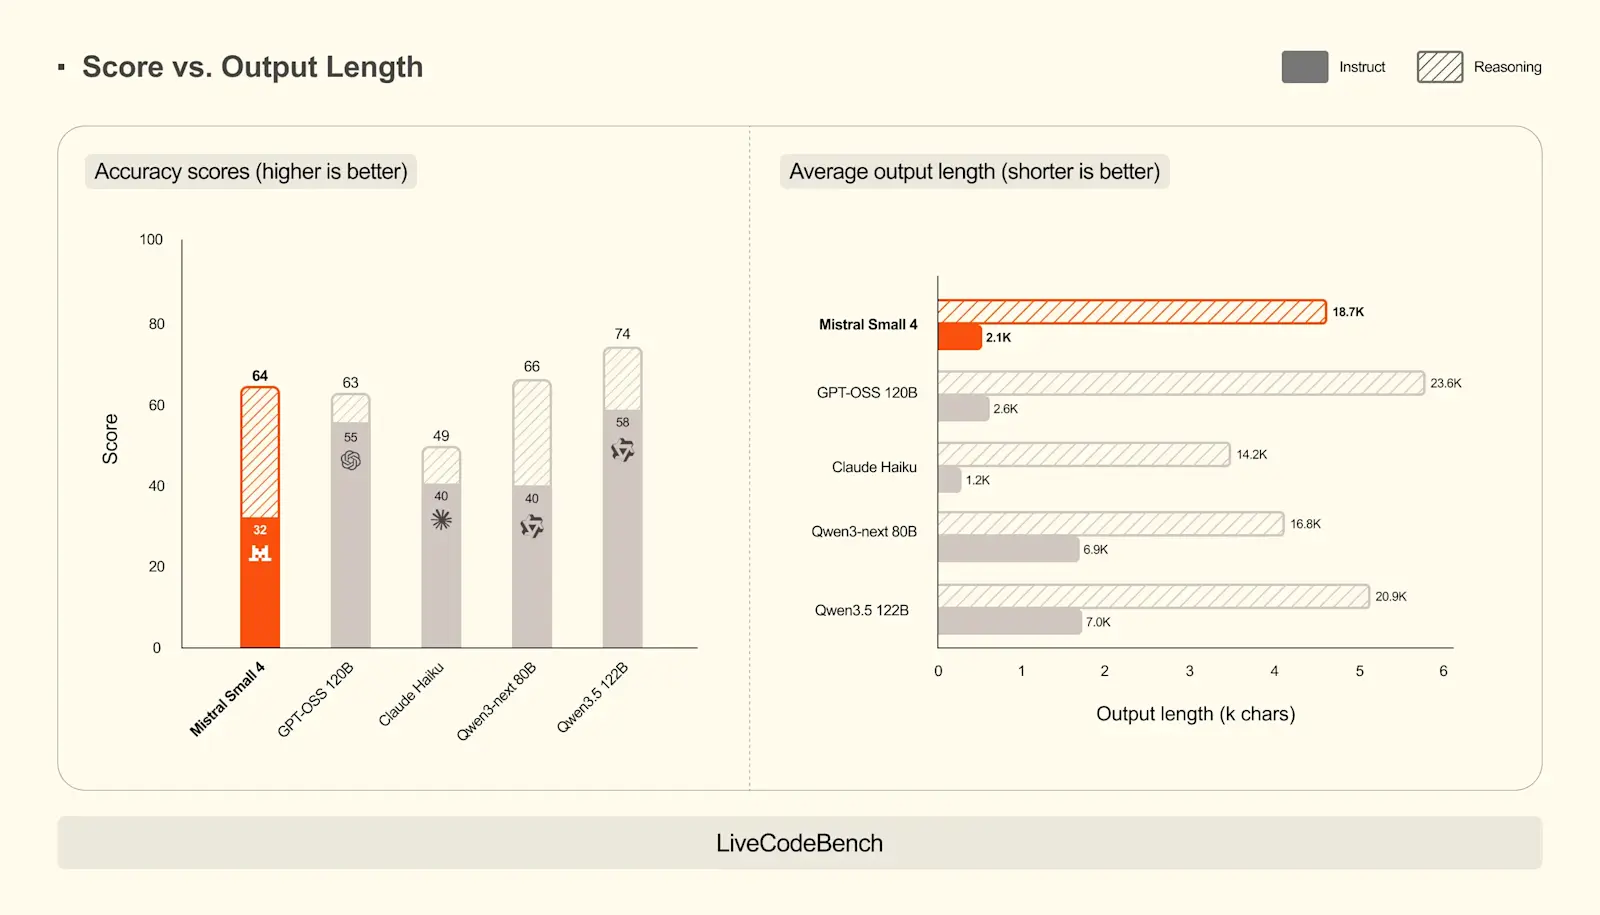
Хотя Small 4 конкурентоспособна по сравнению с небольшими моделями от других компаний, она все же уступает другим популярным открытым моделям, особенно в задачах, требующих интенсивных рассуждений. Qwen 3.5 122B и Qwen 3-next 80B превосходят Small 4 в LiveCodeBench, равно как и Claude Haiku в режиме инструкций.
Источник: Mistral
Mistral Small 4 удалось превзойти GPT-OSS 120B от OpenAI в тесте LCR.
В Mistral утверждают, что Small 4 достигает таких результатов при «значительно более коротких ответах», что означает меньшие затраты на инференс и меньшую задержку по сравнению с другими моделями. В частности, в режиме инструкций Small 4 выдает самые короткие ответы среди всех протестированных моделей: 2,1 тыс. символов против 14,2 тыс. у Claude Haiku и 23,6 тыс. у GPT-OSS 120B. В режиме рассуждений ответы получаются намного длиннее (18,7 тыс.), что ожидаемо для данного сценария использования.
Мэй отметил, что хотя выбор модели зависит от целей организации, задержка (latency) — это один из трех столпов, которым следует уделять первоочередное внимание. «Это зависит от ваших целей и от того, для решения каких задач вы оптимизируете свою архитектуру. Предприятиям следует расставить приоритеты по трем направлениям: надежность и структурированный вывод, соотношение задержки и интеллекта, а также возможность тонкой настройки и конфиденциальность», — подчеркнул Мэй.




