


Meituan открывает исходный код LongCat-2.0 — модели для автономного написания кода с 1.6 трлн параметров, приближенной к передовому уровню, которая лидирует на OpenRouter и обучена исключительно на китайских чипах
Источник: VentureBeat · Carl Franzen


Несколько часов назад китайская компания-разработчик приложений для доставки Meituan официально представила LongCat-2.0 на GitHub, Hugging Face и на своей собственной платформе. Модель оказалась тем самым анонимным секретным движком под кодовым названием «Owl Alpha», который последние два месяца возглавлял мировые чаты разработчиков на OpenRouter.
Эта созданная для коренного подрыва доминирования закрытых коммерческих систем в области автономной разработки программного обеспечения 1,6-триллионная модель «Экспертная смесь» (Mixture-of-Experts, MoE) приносит в открытый доступ нативную поддержку контекстного окна в 1 миллион токенов под чрезвычайно мягкой, пригодной для корпоративного использования лицензией MIT. Тем не менее, компания пока не выложила полные веса — на страницах GitHub и Hugging Face указано: «Веса модели появятся в ближайшее время — следите за новостями!»
Коммерческий доступ к архитектуре предусматривает крайне агрессивную ценовую политику: все обращения к кэшу контекста обрабатываются абсолютно бесплатно, в дополнение к ограниченной по времени программе быстрых продаж «Пакеты токенов» (Token Pack). Также доступен стандартный API с оплатой по факту использования (pay-as-you-go) для запросов, не попадающих в кэш, по базовой цене $0.75 / $2.95 за миллион токенов на вход и выход соответственно.
Тем не менее, ограниченная по времени акционная скидка агрессивно снижает эти операционные расходы до $0.30 за миллион токенов для некэшированного ввода и $1.20 за миллион токенов для вывода, что находится на более дешевой стороне среди лучших мировых моделей.
|
Модель |
Вход ($/1M) |
Выход ($/1M) |
Итого ($/1M) |
Источник |
|
MiMo-V2.5 Flash |
$0.10 |
$0.30 |
$0.40 |
|
|
deepseek-v4-flash |
$0.14 |
$0.28 |
$0.42 |
|
|
deepseek-v4-pro |
$0.435 |
$0.87 |
$1.305 |
|
|
MiniMax-M3 |
$0.30 |
$1.20 |
$1.50 |
|
|
LongCat-2.0 — лимитированная акция |
$0.30 |
$1.20 |
$1.50 |
|
|
Gemini 3.1 Flash-Lite |
$0.25 |
$1.50 |
$1.75 |
|
|
Qwen3.7-Plus |
$0.40 |
$1.60 |
$2.00 |
|
|
MiMo-V2.5 |
$0.40 |
$2.00 |
$2.40 |
|
|
LongCat-2.0 — стандартная |
$0.75 |
$2.95 |
$3.70 |
|
|
Grok 4.3 (низкий контекст) |
$1.25 |
$2.50 |
$3.75 |
|
|
MiMo-V2.5 Pro (≤256K) |
$1.00 |
$3.00 |
$4.00 |
|
|
Kimi-K2.6 |
$0.95 |
$4.00 |
$4.95 |
|
|
GLM-5.2 |
$1.40 |
$4.40 |
$5.80 |
|
|
GPT-5.6 Luna |
$1.00 |
$6.00 |
$7.00 |
|
|
Grok 4.3 (высокий контекст) |
$2.50 |
$5.00 |
$7.50 |
|
|
MiMo-V2.5 Pro (>256K) |
$2.00 |
$6.00 |
$8.00 |
|
|
Qwen3.7-Max |
$2.50 |
$7.50 |
$10.00 |
|
|
Gemini 3.5 Flash |
$1.50 |
$9.00 |
$10.50 |
|
|
Gemini 3.1 Pro Preview (≤200K) |
$2.00 |
$12.00 |
$14.00 |
|
|
GPT-5.6 Terra |
$2.50 |
$15.00 |
$17.50 |
|
|
GPT-5.4 |
$2.50 |
$15.00 |
$17.50 |
|
|
Gemini 3.1 Pro Preview (>200K) |
$4.00 |
$18.00 |
$22.00 |
|
|
Claude Opus 4.8 |
$5.00 |
$25.00 |
$30.00 |
|
|
GPT-5.5 |
$5.00 |
$30.00 |
$35.00 |
|
|
GPT-5.5 Instant (chat-latest) |
$5.00 |
$30.00 |
$35.00 |
|
|
Sakana Fugu Ultra (≤272K) |
$5.00 |
$30.00 |
$35.00 |
|
|
GPT-5.6 Sol |
$5.00 |
$30.00 |
$35.00 |
|
|
Claude Fable 5 / Claude Mythos 5 |
$10.00 |
$50.00 |
$60.00 |
Что делает этот релиз поворотным моментом для мировой технологической инфраструктуры, так это его операционная независимость: массивредная модель была полностью обучена на кластере из более чем 50 000 отечественных китайских специализированных интегральных схем (ASIC). Это доказало, что ИИ-модели, близкие к передовым, можно успешно масштабировать без опоры на типичные американские графические процессоры Nvidia, на которых до сих пор строилась большая часть глобальных усилий по обучению передовых моделей генеративного ИИ.
Успешное развертывание альтернативного кремния знаменует собой глубокий структурный сдвиг. Если китайские конгломераты смогут стабильно итеративно создавать архитектуры с триллионами параметров на базе отечественных ASIC, а не универсальных GPU, это создаст угрозу доминированию Nvidia в данном секторе.
Что особенно важно, этот технологический поворот происходит как раз в тот момент, когда Вашингтон оказывает давление на ведущие американские лаборатории, требуя ограничить доступ к их новейшим моделям. По запросу американского правительства компания OpenAI была вынуждена ограничить доступ к своим новым моделям GPT-5.6, в то время как Anthropic ранее также получила распоряжение от властей США ограничить доступ к новейшим моделям Claude Fable 5 / Mythos 5, из-за чего их вообще полностью отключили. В то же время все больше технологов, активистов и экспертов индустрии предупреждают, что эти оборонительные регуляторные маневры дали обратный эффект. Заблокировав западные закрытые модели и взвинтив цены на API, правительство США оставило широкое операционное окно для мировых разработчиков, ищущих доступные и высокопроизводительные альтернативы — такие как китайские опенсорсные модели вроде Meituan LongCat-2.0.
Сырые операционные показатели подтверждают энтузиазм разработчиков: во время своего пребывания под брендом Owl Alpha на OpenRouter модель обрабатывала примерно 10,1 триллиона токенов в месяц (в среднем 559 миллиардов токенов в день), продемонстрировав взрывной рост объема на 242% по сравнению с предыдущим месяцем, что вывело ее в глобальную тройку лидеров платформы.
К тому моменту, когда Meituan открыто заявила о своих правах на эту архитектуру, модель уже заняла первое место в рабочем пространстве агента Hermes, второе место при развертывании в Claude Code и третье место в международных средах OpenClaw.
VB Transform · 14–15 июля · Менло-Парк · Инференс и ИИ-инфраструктура
GM добилась 300% роста числа объединенных PR (merged pull requests) за счет перепроектирования архитектуры под агентов. Вот что они создали.
Инфраструктурный трек на конференции Transform охватывает генерацию видео в реальном времени, стеки межмашинных рассуждений и то, что на самом деле требуется для запуска агентов в масштабах предприятия.
Технологии: проектирование разреженного контекста на 1 млн токенов
В основе LongCat-2.0 лежит агрессивная оптимизация разреженности архитектуры Mixture-of-Experts (MoE), которая масштабирует общее число параметров до 1,6 триллиона, ограничивая при этом активные вычисления в среднем 48 миллиардами параметров на один токен.
В зависимости от структурной сложности запроса динамическая активация модели варьируется от 33 до 56 миллиардов параметров. Эта конструкция реализует концепцию «экспертов с нулевыми вычислениями» (Zero-Compute Experts), гарантируя, что рутинные элементы выполнения проходят через более легкие подсети, что полностью устраняет избыточные вычислительные накладные расходы, которые обычно снижают производительность ультраплотных моделей.
Чтобы обеспечить функциональное контекстное окно в 1 миллион токенов без возникновения критических аппаратных узких мест, компания Meituan представила разреженное внимание LongCat Sparse Attention (LSA). Созданное как эволюционное развитие разреженного внимания DeepSeek Sparse Attention, LSA решает проблемы квадратичных затрат на подсчет очков и фрагментации памяти, характерные для мелкозернистых разреженных механизмов, по трем раздельным ортогональным векторам:
-
Потоковая индексация (Streaming-aware Indexing, SI): Эта система реструктурирует конвейер выбора токенов путем объединения выровненных по железу непрерывных чтений данных с динамическим случайным выбором. Превращая фрагментированный доступ к памяти в высокопредсказуемые последовательные блоки, система обеспечивает коалесцированное использование памяти High Bandwidth Memory (HBM) и повышенную эффективную пропускную способность.
-
Межслойная индексация (Cross-Layer Indexing, CLI): Опираясь на эмпирический факт того, что важность внимания (saliency) остается весьма стабильной в соседних скрытых слоях, CLI амортизирует вычислительные затраты. Один проход индексации успешно направляет несколько последовательных слоев во время инференса — способность, подкрепленная межслойной дистилляцией на этапе обучения.
-
Иерархическая индексация (Hierarchical Indexing, HI): Этот подход использует двухэтапную схему оценки от грубого к точного. Индексатор выполняет быстрый приблизительный поиск на уровне блоков для фильтрации кандидатов перед тем, как запустить мелкозернистый выбор токенов исключительно по оставшейся совокупности.
Кроме того, Meituan интегрировала модуль встраивания N-gram (N-gram Embedding), унаследованный от своих более легких модельных линеек. За счет расширения распределения параметров в разреженных измерениях, полностью ортогональных структуре экспертов MoE, архитектура добавляет 135 миллиардов параметров к фреймворку комбинации 5-граммовых токенов.
Это примерно в 100 раз расширяет базовое пространство эмбеддингов, позволяя модели фиксировать плотные локальные связи токенов и ускорять операции пакетного инференса за счет уменьшения узких мест ввода-вывода (I/O) памяти.
Продукт: посткальибровка, фреймворк MOPD и результаты бенчмарков
В то время как универсальные большие языковые модели уделяют первостепенное внимание плавным диалоговым интерфейсам, LongCat-2.0 четко сфокусирована на многоэтапных инженерных задачах, интеграции инструментов и автоматизированных манипуляциях с репозиториями — иными словами, на агентных задачах.
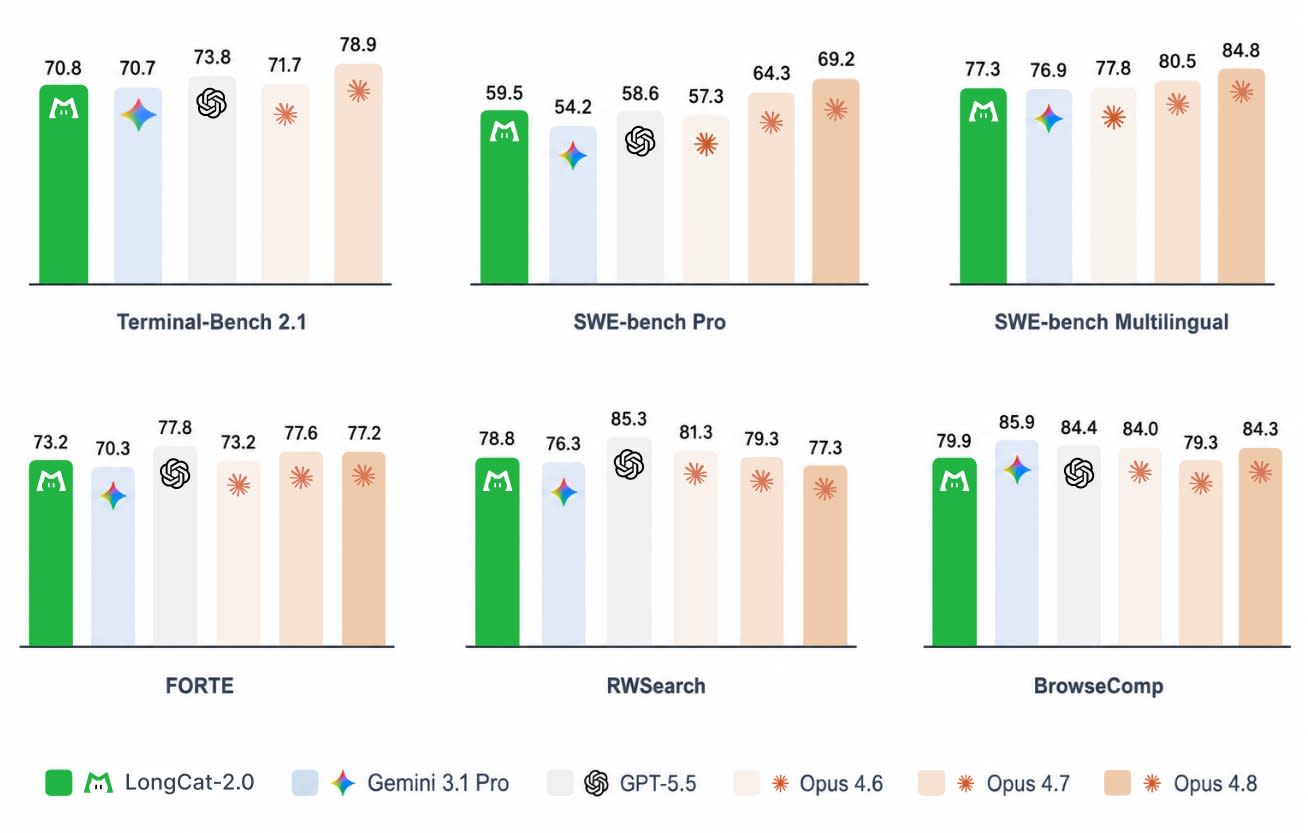
В стандартизированных тестах LongCat-2.0 набирает эмпирические 59.5 балла на SWE-bench Pro, превосходя результат GPT-5.5, равный 58.6 балла. Модель дополнительно подтверждает свою агентную специализацию, показывая 70.8 балла на Terminal-Bench 2.1, 77.3 балла на SWE-bench Multilingual и 73.2 балла на симуляторе общего корпоративного рабочего процесса FORTE.
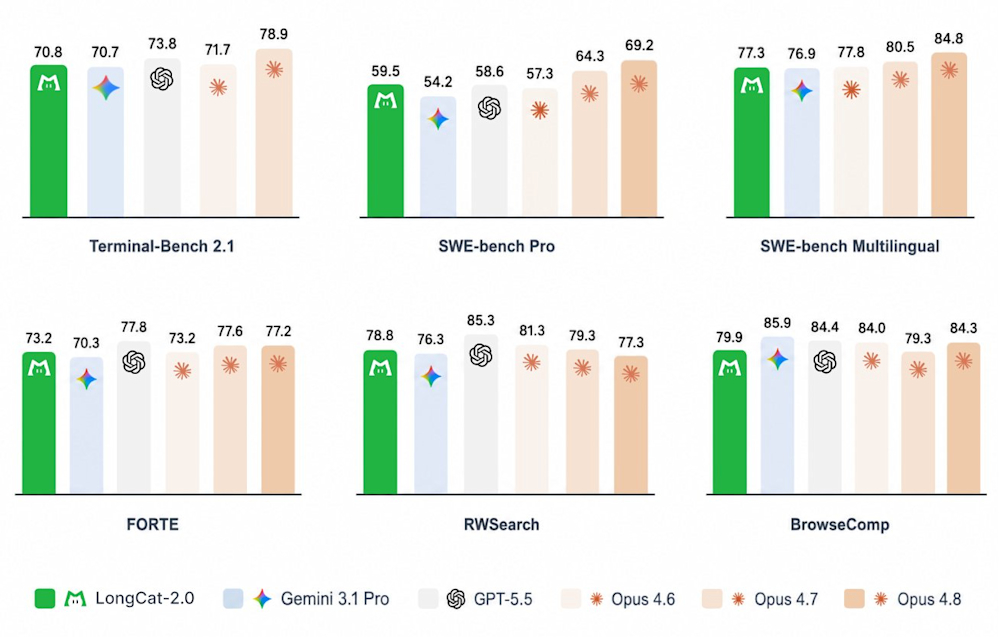
Гистограммы сравнения бенчмарков LongCat-2.0. Источник: Meituan LongCat
Такое точное операционное поведение достигается за счет структурного слоя посткалибровки под названием «Многоучительская оптимизация через смесь специализированных экспертов» (Multi-Teacher Optimization via Mixture of Specialized Experts, MOPD). Вместо того чтобы объединять сырые человеческие отзывы в единую функцию вознаграждения, архитектура MOPD разделяет посттренировочную оптимизацию на три независимых высокоспециализированных кластера экспертов.
-
Агентные эксперты (Agent Experts) дообучены строго для структурного выполнения задач, специализируясь на точном вызове инструментов, многошаговом синтаксическом анализе параметров API и механизмах самокорректирующихся циклов во избежание зависания выполнения.
-
Эксперты по рассуждениям (Reasoning Experts) оптимизированы изолированно для развития многошаговой логики, сложного мышления по цепочке (chain-of-thought), математики и решения задач в сфере STEM на высшем уровне.
-
Эксперты по взаимодействию (Interaction Experts) полностью сосредоточены на выравнивании по человеку (human alignment), нюансах следования инструкциям, фактической достоверности для подавления галлюцинаций, а также на поддержании жестких защитных барьеров без снижения общей полезности модели.
Разделяя эти векторы в процессе посткалибровки, LongCat-2.0 предотвращает функциональную деградацию. Механизм динамической маршрутизации запросов плавно объединяет эти специализированные поведения во время выполнения, позволяя итоговой модели одновременно координировать глубокие рассуждения, стабильное выполнение инструментов и безопасное взаимодействие с пользователем.
Хотя LongCat-2.0 в целом уступает передовым топовым системам вроде Claude Opus 4.8 в общих агентных бенчмарках широкого профиля вроде FORTE и BrowseComp, она явно превосходит ожидания в области разработки программного обеспечения.
Что делает эту архитектуру с открытыми весами особенной, так это ее гиперфокус на автономную разработку; ей удается с небольшим отрывом превзойти проприетарную GPT-5.5 от OpenAI в строгом софтверном бенчмарке SWE-bench Pro (59.5 против 58.6 балла), что доказывает ее высокую эффективность и жесткую конкурентоспособность в сложных задачах программирования при меньших вычислительных затратах.
Коммерческая структура: оплата по факту использования против быстрых распродаж пакетов токенов
Стратегия развертывания Meituan представляет специализированную коммерческую модель, которая разделяет сетевой доступ между традиционным биллингом API в реальном времени и структурированными «пакетами токенов» (Token Packs).
Для традиционной корпоративной интеграции доступны стандартные пополняемые счета, которые списывают операционный капитал в реальном времени на основе метрик ввода и генерации токенов.
Однако, чтобы справиться с непредсказуемыми пиками вычислений, характерными для автономных агентов разработки, Meituan запустила структурированную систему пакетов токенов. Приобретаемые в виде фиксированных разовых объемных квот, действительных ровно в течение 30-дневного окна, эти пакеты накладываются поверх существующего базового аккаунта организации в API.
Для управления сетевой нагрузкой на свои кластеры ASIC компания Meituan выпускает эти крупные объемы токенов посредством ограниченных быстрых распродаж четыре раза в день: точно в 10:00, 16:00, 21:00 и 23:00 по пекинскому времени по принципу «первым пришел — первым обслужен». Экономической изюминкой этой структуры является бесплатная обработка попаданий в кэш контекста.
В массивных агентных средах, где помощник программиста должен многократно читать, ссылаться и изменять один и тот же многомиллионный кодовая база в ходе длительной сессии, стандартные архитектуры наказывают разработчиков, взимая полную плату за повторяющийся входной контекст. В инфраструктуре Meituan квоту пакета расходуют только входы, промахнувшиеся мимо кэша, и финальная генерация токенов. Эта архитектура полностью меняет экономику операционных затрат при крупномасштабной разработке ПО с помощью агентов, позволяя глубоко и итеративно исследовать контекст без увеличения расходов.
Лицензирование: структурная свобода открытого исходного кода
Регистрируя репозиторий LongCat-2.0 под открытой лицензией MIT, Meituan наделяет архитектуру максимальной юридической гибкостью для корпоративной интеграции.
В отличие от парадигм copyleft вроде Стандартной общественной лицензии GNU (GPL), которая юридически обязывает разработчиков делать открытым исходный код любых производных фреймворков или внутреннего ПО, ссылающегося на этот код, лицензия MIT предоставляет практически неограниченную свободу.
Для корпоративных инженерных команд этот юридический стандарт гарантирует, что LongCat-2.0 может быть глубоко модифицирована, скомпилирована и жестко встроена непосредственно в закрытые коммерческие приложения, проприетарные инструменты разработки и внутренние бэкенды автоматизации.
Корпорации могут форкнуть репозиторий, оптимизировать внутренние механизмы LSA для работы с приватными базами данных и продавать полученный программный стек конечным пользователям без каких-либо обязательств по раскрытию своей проприетарной интеллектуальной собственности или структурных улучшений.
Эволюция Meituan: от супериприложения доставки до ИИ-тяжеловеса
Основанная в марте 2010 года серийным предпринимателем Ван Син (Wang Xing), компания Meituan изначально запускалась как сайт ежедневных скидок в стиле Groupon, после чего стремительно превратилась в одно из доминирующих «супериприложений» Китая.
После масштабного слияния с Dianping в 2015 году пекинский технологический гигант закрепил за собой доминирующую рыночную долю в коридорах городской доставки страны, объединив отзывы местных потребителей, мгновенную розничную торговлю, бронирование отелей и доставку еды. Будучи публичной компанией на Гонконгской фондовой бирже, Meituan заявляет о более чем 770 миллионах активных пользователей в год и поддерживает сеть из более чем 14,5 миллионов продавцов.
Однако, столкнувшись с жесткой конкуренцией на внутреннем рынке, серьезным сокращением маржи и падением прибыльности, компания агрессивно сместила фокус стратегии за пределы логистики. Meituan публично пообещала инвестировать «миллиарды» в искусственный интеллект и технологии создания собственных чипов, чтобы вдохнуть новую жизнь в свои технологические предложения.
Этот стратегический сдвиг в сторону глобальной гонки ИИ начал материализоваться в конце 2025 года с выпуска LongCat-Flash — базовой экспертно-смесевой модели с 560 миллиардами параметров, за которой быстро последовала модель глубокого рассуждения LongCat-Flash-Thinking. Выпустив эти передовые модели в открытый доступ под дружественными для бизнеса лицензиями, Meituan заявила о своих амбициях стать ключевым игроком в глобальной ИИ-инфраструктуре, а не оставаться сугубо региональным гигантом электронной коммерции и доставки.
Значение для бизнеса: автономные рабочие процессы
Для современных предприятий релиз LongCat-2.0 открывает четкие операционные стратегии в сфере разработки программного обеспечения, системных операций и долгосрочной интерпретации данных.
Сочетание модели с открытыми весами по лицензии MIT и обширного контекстного окна на 1 миллион токенов означает, что организации могут обойти проблемы с конфиденциальностью данных и регулярные расходы, связанные с хостингом проприетарных сторонних API. В крупномасштабных корпоративных средах разработки команды могут задействовать специализированных агентных экспертов модели для организации автономных миграций кодовой базы.
Вместо того чтобы тратить сотни часов разработчиков на ручное переписывание устаревших фреймворков приложений, инженеры могут передать весь корпоративный репозиторий вместе с современной документацией по SDK напрямую в контекстное окно размером 1 миллион токенов. LongCat-2.0 способна составить карту зависимостей, выполнить структурные обновления на уровне репозитория, скомпилировать новую кодовую базу и самостоятельно отловить баги компиляции и выполнения в локальных песочницах перед созданием финального пулл-реквеста.
Архитектурное разделение модели с помощью механизма маршрутизации MOPD дает значительные преимущества для строгого корпоративного комплаенса. Направляя специфические операционные запросы через изолированные кластеры экспертов, финансовое учреждение или медицинская компания могут проводить глубокие логические и математические вычисления без риска появления фактических галлюцинаций или нарушения строгих норм безопасности.
Эксперты по взаимодействию функционируют как неявный уровень защитных барьеров, подавляя ошибки и обеспечивая выполнение протоколов следования инструкциям без снижения чистой вычислительной мощности внутренних экспертов по рассуждениям. В сочетании с моделью кэширования с нулевой стоимостью предприятия могут поддерживать ультрафокусированные автономные сети разработки ПО, которые способны многократно изучать корпоративные пулы данных, непрерывно обслуживая и оптимизируя внутреннюю инфраструктуру за малую долю стандартных операционных расходов.




