


DiffusionGemma от Google генерирует текст в 4 раза быстрее
Источник: VentureBeat · Sean Michael Kerner


Генераторы изображений на основе генеративного искусственного интеллекта (GenAI), такие как Stable Diffusion, не рисуют картинку попиксельно слева направо. Они начинают с шума и итеративно уточняют все изображение параллельно, пока оно не сойдется в единое целое — этот процесс известен как диффузия. Годами применение того же принципа к генерации текста оставалось недостижимым в промышленных масштабах.
Стандартные языковые модели работают подобно печатной машинке: по одному токену за раз, слева направо, без возможности исправить уже выданный результат. Такой подход эффективен в облаке, где размер батчей поддерживает постоянную загрузку графических процессоров (GPU). При локальном выводе или развертывании с низким уровнем параллелизма GPU большую часть времени простаивает.
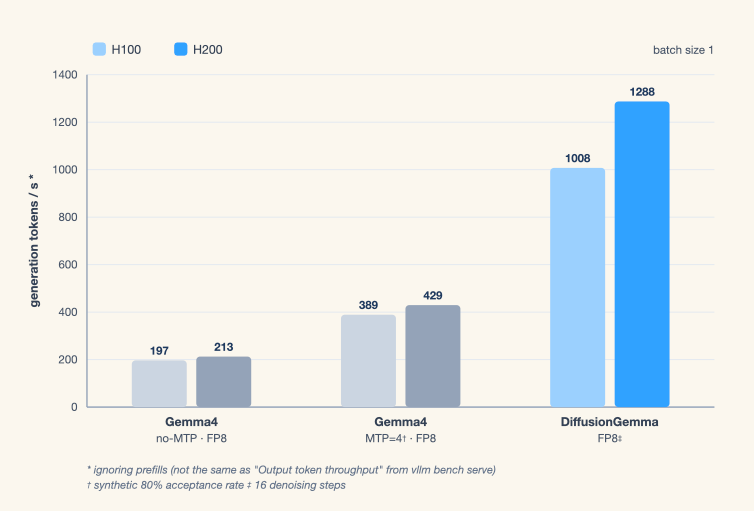
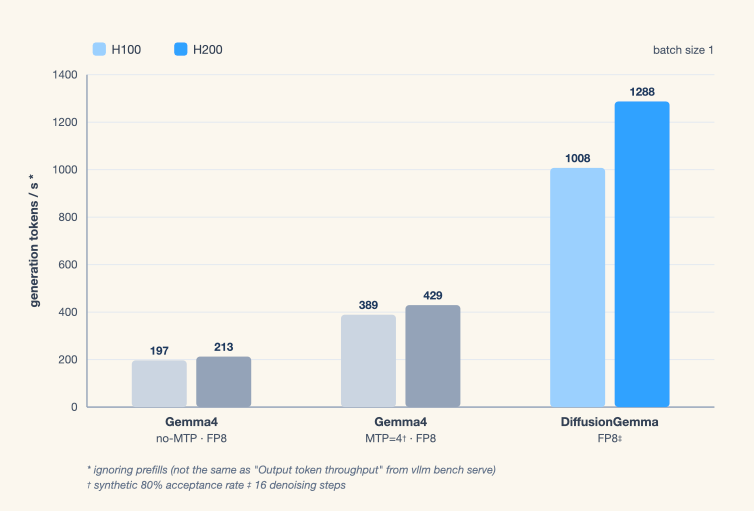
Представленная на этой неделе модель DiffusionGemma от Google — это экспериментальная модель с открытым исходным кодом, которая применяет диффузию к генерации текста в продакшн-масштабе. Созданная на базе Gemma 4 и выпущенная под лицензией Apache 2.0, она является первой языковой моделью на основе диффузии с нативной поддержкой в платформе инференса с открытым исходным кодом vLLM. Она генерирует блок из 256 токенов параллельно, а не последовательно, причем каждая позиция токена учитывает контекст всех остальных. По данным Google, DiffusionGemma генерирует текст на GPU до 4 раз быстрее стандартных моделей. При размере батча 1 на единственной карте Nvidia H100 версия FP8 достигает 1008 токенов в секунду. На H200 этот показатель составляет 1288 токенов — примерно в шесть раз больше стандартного авторегрессионного базового уровня, согласно опубликованным сегодня результатам тестов vLLM.
Несмотря на прирост скорости, в Google не стали преувеличивать достоинства релиза. В публикация компании, посвященной запуску, прямо признается, что общее качество генерации DiffusionGemma ниже, чем у стандартной Gemma 4, и добавляется: «Для приложений, требующих максимального качества, мы рекомендуем развертывать стандартную Gemma 4».
Что делает DiffusionGemma
DiffusionGemma генерирует токены не по порядку. Она начинает с блока из 256 случайных токенов-заполнителей, представляющих собой чистый холст, и выполняет множество проходов уточнения по всему блоку одновременно. На каждом проходе модель оценивает каждую позицию и фиксирует те, в которых она наиболее уверена. Неуверенные позиции рандомизируются и пересматриваются на следующем проходе, причем модель использует то, что было разрешено на предыдущем этапе, для формирования следующей попытки. Блок сходится постепенно до тех пор, пока достаточное количество позиций не стабилизируется, чтобы зафиксировать остальные.
Из этой архитектуры вытекают два следствия.
-
Самокоррекция. Авторегрессионная модель, выдавшая ошибочный токен, застревает с ним, поскольку последующие токены уже зависят от этой ошибки. DiffusionGemma способна выявлять позиции с низкой степенью уверенности и переоценивать их на следующем проходе.
-
Двунаправленный контекст. Каждая позиция учитывает все остальные позиции в блоке одновременно, включая токены, которые появляются позже в последовательности. Это делает модель структурно более подходящей для задач с ограничениями генерации, где генерация слева направо терпит неудачу.
Google продемонстрировала оба свойства с помощью дообученного решателя судоку. Базовая модель не решила ни одной головоломки. После дообучения на датасете судоку она достигла 80% успеха и сходилась за 12 шагов шумоподавления вместо 48. Прирост эффективности произошел напрямую за счет способности модели к самокоррекции и досрочной остановке.
Как она создавалась
DiffusionGemma работает как модель «смесь экспертов» (Mixture of Experts) на 26 млрд параметров, которая задействует лишь 3,8 млрд параметров во время инференса. В квантованном виде она помещается в 18 ГБ видеопамяти (VRAM) на потребительском «железе», включая Nvidia RTX 4090 и 5090. Google и NVIDIA также оптимизировали ее для корпоративных серверов Hopper и Blackwell с использованием ядер NVFP4.
Интеграция с vLLM потребовала новой работы, поскольку DiffusionGemma не вписывается в стандартную модель обслуживания. Типичный батч в vLLM применяет один и тот же тип внимания (attention) к каждому запросу. Запросы к DiffusionGemma чередуют причинное (causal) и двунаправленное внимание по мере прохождения циклов чтения промпта, уточнения холста и фиксации блока. Команда встроила переключение внимания для каждого запроса в бэкенды Triton и FlashAttention 4, а для цикла уточнения повторно использовала существующий путь спекулятивного декодирования.
Новый интерфейс ModelState, созданный командой для этой интеграции, разработан с расчетом на поддержку дополнительных диффузионных моделей в vLLM по мере их появления.
Где кроется выигрыш в скорости, а где нет
Преимущество DiffusionGemma в скорости реально, но условно. Области ее применения полностью зависят от контекста развертывания.
Цифры. При размере батча 1 на одном чипе H100 опубликованные тесты vLLM показывают для модели FP8 производительность примерно в пять раз выше стандартного авторегрессионного базового уровня. На H200 — примерно в шесть раз. Эти пиковые показатели отражают оптимальные условия: один пользователь, выделенное «железо», квантование FP8.
Источник: проект vLLM
Где она побеждает. Локальный инференс, однопользовательские приложения и обслуживание с низким уровнем параллелизма. В таких условиях у GPU есть избыток вычислительной мощности, а узким местом является пропускная способность памяти. Параллельная генерация блоков DiffusionGemma устраняет этот разрыв.
Где она проигрывает. Облачное обслуживание с высокой пропускной способностью. Когда сервер обрабатывает сотни одновременных запросов пакетами, авторегрессионные модели уже полностью загружают доступные вычисления, и параллельное декодирование DiffusionGemma дает уменьшающуюся отдачу.
Потолок качества. Исследователь искусственного интеллекта Гильерме О’Тина (Guilherme O’Tina) точнее сформулировал это в X. «Локальные артефакты и галлюцинации — это разные проблемы, и именно это определяет, где она действительно побеждает», — написал О’Тина.
Сравнение с аналогами
Диффузионные языковые модели не являются новшеством. Исследователи создавали их в меньших масштабах в течение нескольких лет, а Mercury Coder от Inception Labs применила этот подход на коммерческой основе для задач программирования в 2025 году. DiffusionGemma привносит масштаб — бэкенд MoE на 26 млрд параметров, нативный сервис vLLM и универсальную модель, настроенную на следование инструкциям, вместо узкоспециализированной.
Более полезное сравнение для инженеров, оценивающих эту систему в сравнении с существующими инструментами инференса — это спекулятивное декодирование, и здесь различие имеет принципиальное значение. Спекулятивное декодирование сохраняет стандартную авторегрессионную целевую модель и использует меньшую модель-черновик для прогнозирования нескольких токенов вперед. Целевая модель проверяет их за один проход. Если выборка корректна, распределение вывода остается идентичным целевому. Архитектура остается неизменной.
Андрей Кунцевич (Andrew Kuncevich), исследователь в области машинного обучения и ИИ, специализирующийся на производственных системах ИИ, прямо написал об этом в X. «DiffusionGemma устроена иначе. Она не просто угадывает будущие токены. Она создает зашумленный 256-токенный холст и многократно очищает весь блок от шума параллельно. Так что это не просто трюк с декодированием — это совершенно другая парадигма генерации», — написал Кунцевич.
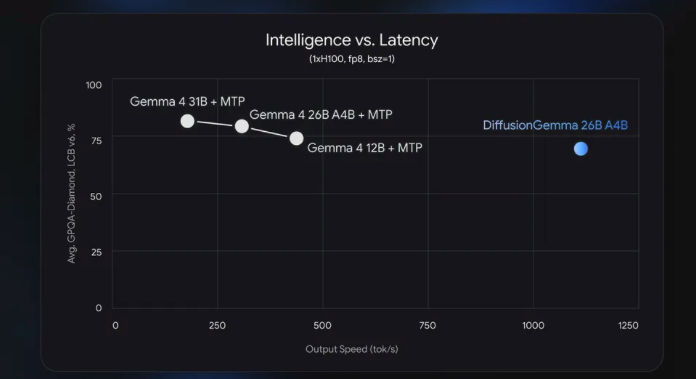
По сравнению со стандартной Gemma 4, здесь происходит обмен скорости на качество. Данные бенчмарков Google показывают, что DiffusionGemma уступает стандартной Gemma 4 по общим метрикам качества вывода, причем разрыв варьируется в зависимости от задачи.
Источник: Google
В структурированных задачах с ограничениями, включая заполнение кода (infilling), генерацию шаблонов и проблемы, требующие распространения двунаправленных ограничений, архитектура имеет структурное преимущество, которое дообучение способно выявить, как демонстрирует результат с судоку. В задачах с открытым концом генерации стандартная Gemma 4 остается более сильным вариантом.
Что это значит для бизнеса
DiffusionGemma обслуживается через стандартный эндпоинт vLLM, совместимый с OpenAI, без необходимости каких-либо изменений пайплайна под диффузию.
Это не универсальное обновление модели.
Для команд, запускающих локальный инференс или инференс с низким уровнем параллелизма, выбор архитектуры только что расширился. До сих пор сокращение задержки генерации на специализированном «железе» GPU означало использование меньшей модели и смирение с компромиссом в качестве. DiffusionGemma предлагает третий путь при том же объеме параметров, на потребительском оборудовании и с поддержкой vLLM в день релиза.
Для рабочих нагрузок с ограничениями генерации двунаправленное внимание заслуживает оценки. Заполнение кода, генерация структурированных данных и задачи, где правильный результат зависит от еще не сгенерированного контекста — это области, где данная архитектура имеет структурное преимущество.
Интерфейс ModelState, созданный для этой интеграции, спроектирован с учетом универсальности по мере появления новых диффузионных моделей.
Компромисс в качестве реален, и Google признает это. Командам, выполняющим локальный инференс на выделенном оборудовании GPU, стоит провести тестирование.




