


Anthropic выпускает Claude Opus 4.7, с небольшим отрывом возвращая себе лидерство среди самых мощных общедоступных LLM


Компания Anthropic сегодня официально выпускает свою самую мощную большую языковую модель на сегодняшний день — Claude Opus 4.7. При этом компания продолжает удерживать еще более мощного преемника, Mythos, в закрытом доступе для небольшого числа внешних корпоративных партнеров в целях тестирования кибербезопасности и устранения уязвимостей в используемом ими программном обеспечении (которые Mythos быстро обнаружил).
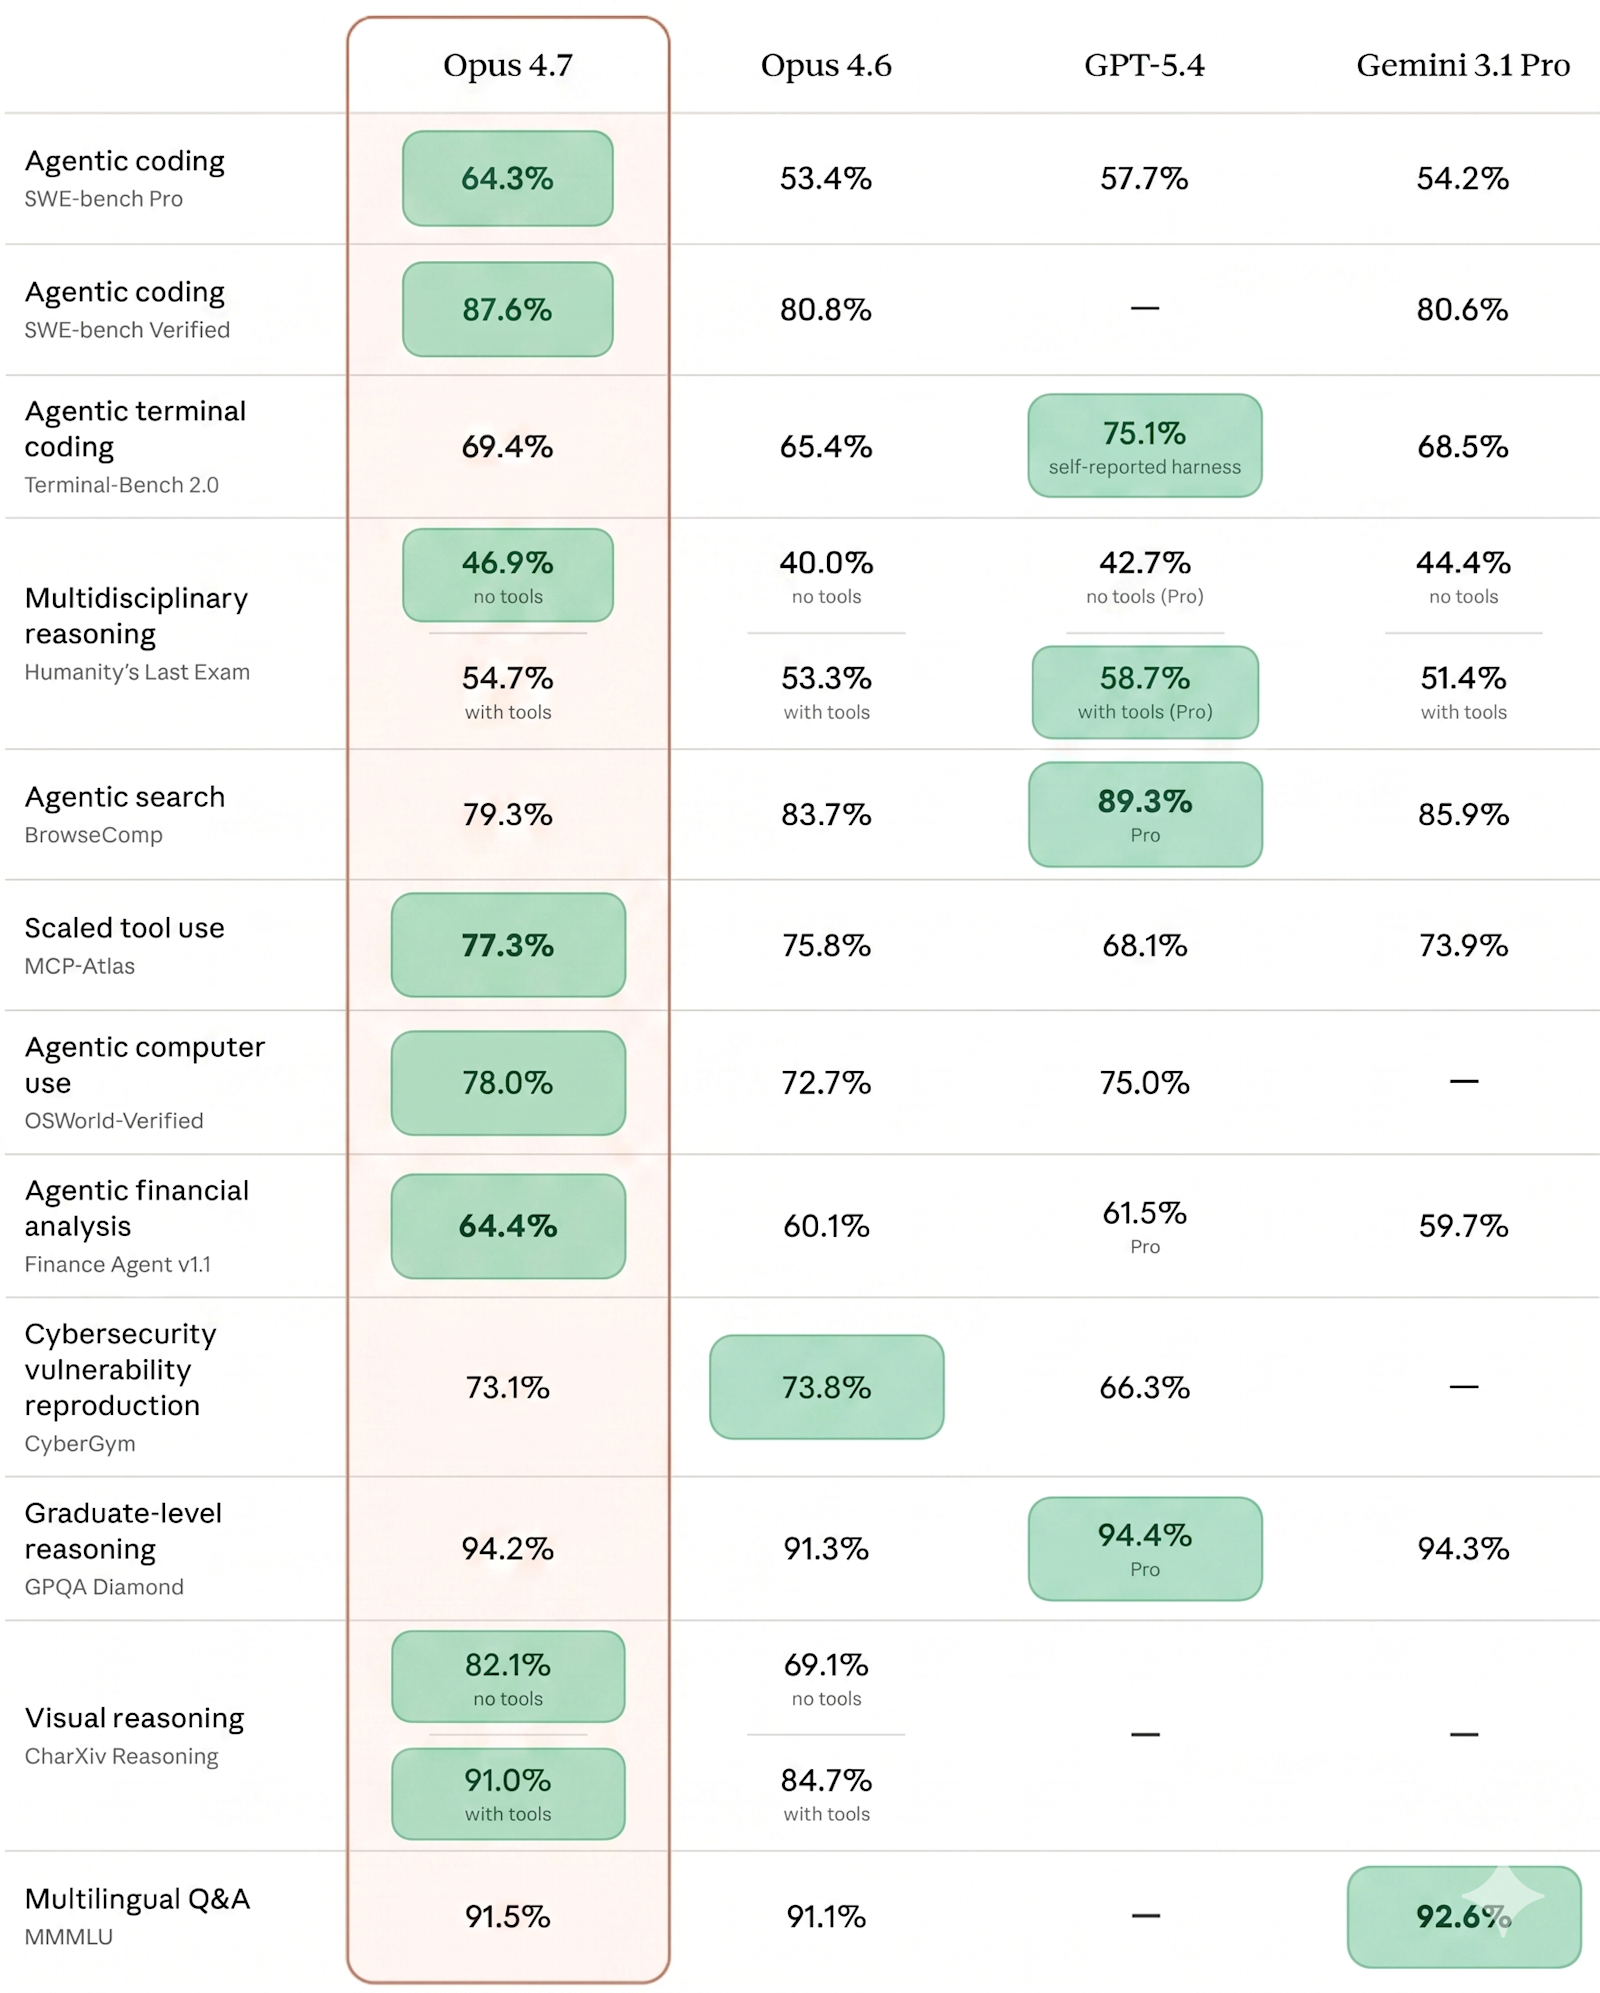
Главная новость заключается в том, что Opus 4.7 превосходит своих прямых соперников — модель GPT-5.4 от OpenAI, выпущенную в начале марта 2026 года (чуть больше месяца назад), и последнюю флагманскую модель Google Gemini 3.1 Pro от февраля — по ключевым бенчмаркам, включая агентское программирование, масштабное использование инструментов, агентское использование компьютера и финансовый анализ.
Тем не менее, примечательно, насколько плотной становится гонка: по напрямую сопоставимым тестам Opus 4.7 опережает GPT-5.4 со счетом всего 7:4.
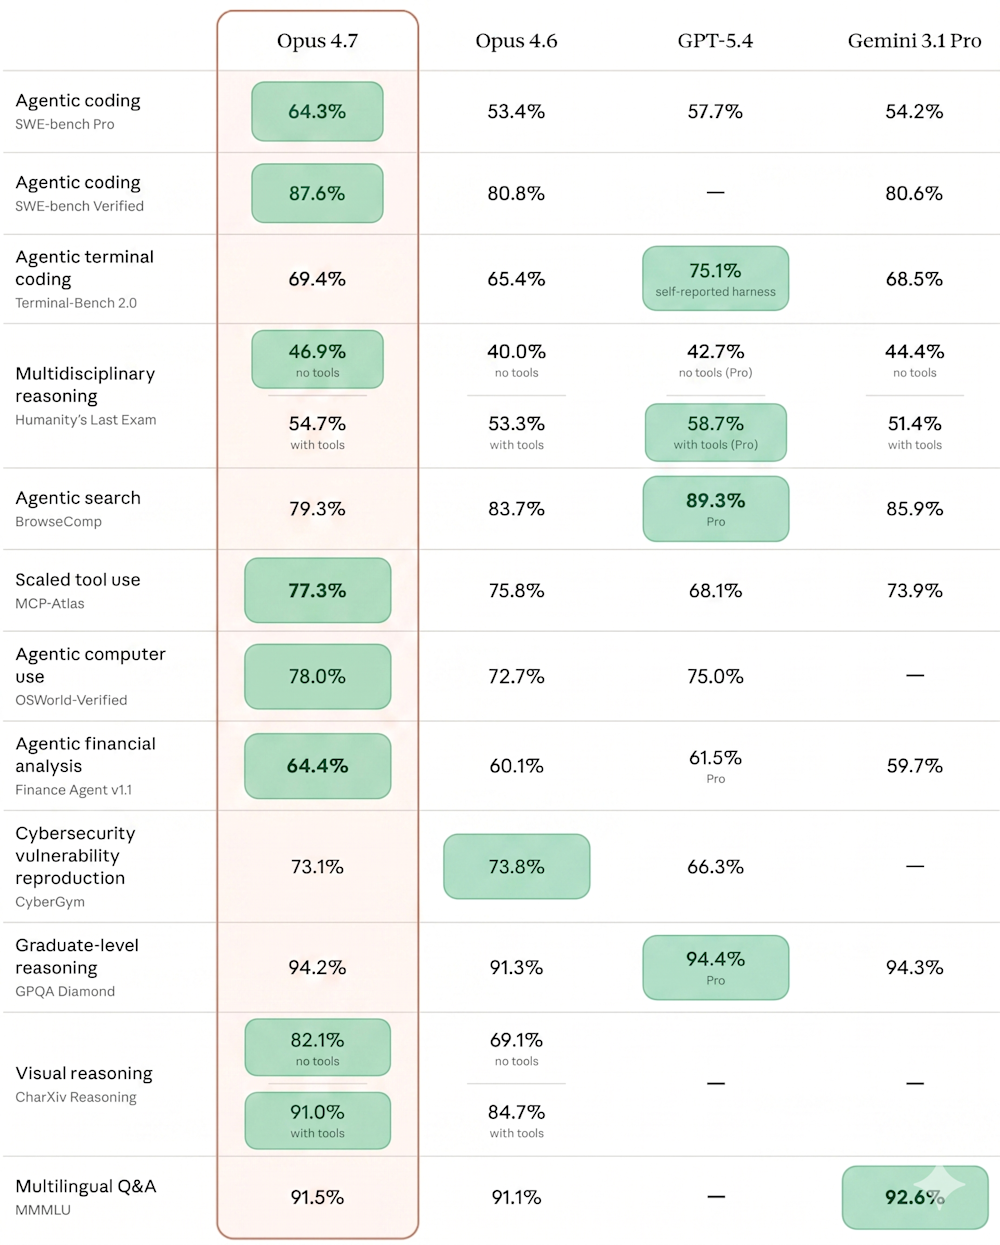
Аннотированная диаграмма тестов Claude Opus 4.7. Источник: Anthropic, отредактировано VentureBeat с использованием изображения Google Gemini 3.1 Pro
В настоящее время модель лидирует на рынке по оценке интеллектуальной работы GDPVal-AA с показателем Elo 1753, опережая как GPT-5.4 (1674), так и Gemini 3.1 Pro (1314).
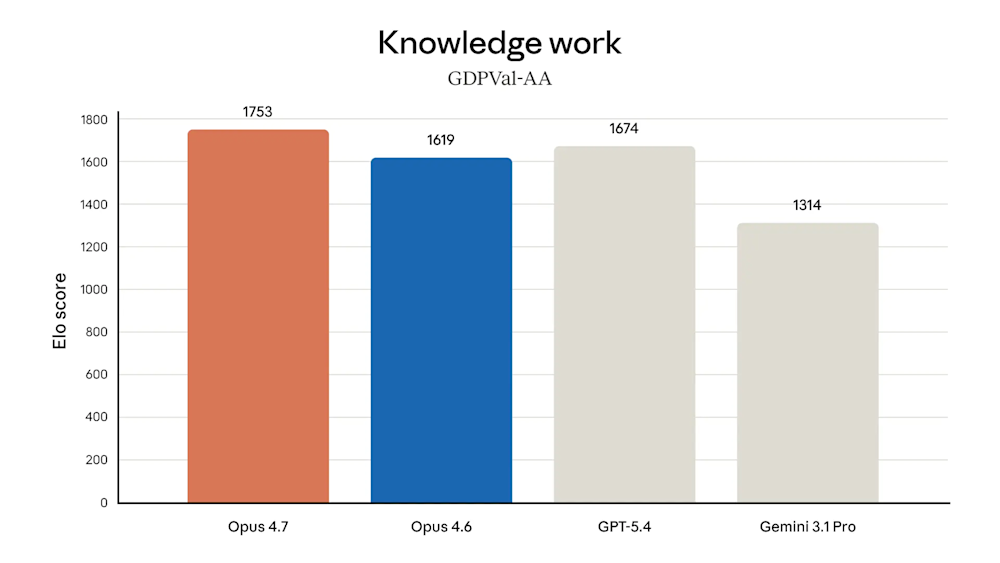
Сравнительная диаграмма бенчмарка интеллектуальной работы GPDVal-AA для Opus 4.7 и других моделей. Источник: Anthropic
Тем не менее, модель не демонстрирует абсолютной победы во всех категориях.
Конкуренты вроде GPT-5.4 и Gemini 3.1 Pro по-прежнему удерживают лидерство в таких специфических областях, как агентский поиск (где GPT-5.4 набирает 89,3% против 79.3% у Opus 4.7), а также в многоязычных вопросно-ответных системах и программировании на уровне сырого терминала.
Такое позиционирование определяет Opus 4.7 не как единоличного победителя во всех ИИ-задачах, а как специализированный тяжелый инструмент, оптимизированный для надежности и долгосрочной автономности, востребованных в стремительно развивающейся агентской экономике.
Claude Opus 4.7 доступна уже сегодня на всех основных облачных платформах, включая Amazon Bedrock, Vertex AI от Google Cloud и Microsoft Foundry, причем ценообразование API сохраняется на прежнем уровне: $5 / $25 за миллион токенов.
Улучшения в точных науках и агентских рабочих процессах
Claude Opus 4.7 является прямым развитием архитектуры Opus 4.6, однако наибольший прирост ее производительности заметен в «сложных» научных аспектах агентских рабочих процессов: разработке программного обеспечения и комплексном анализе документов.
В основу модели заложена перенастройка на обеспечение того, что Anthropic описывает как «строгость» (rigor). Это не просто маркетинговая терминология; речь идет о новой способности модели самостоятельно разрабатывать этапы верификации перед тем, как отчитываться о выполнении задачи.
Например, в ходе внутренних тестов было замечено, что модель с нуля создала движок преобразования текста в речь на Rust, а затем независимо пропустила собственное сгенерированное аудио через отдельный распознаватель речи, чтобы проверить результат по эталону на Python.
Такой уровень автономной самокоррекции призван сократить «циклы галлюцинаций», которые часто преследуют более ранние итерации агентского ПО.
Самым значительным архитектурным обновлением стал переход на поддержку мультимодальности высокого разрешения. Теперь Opus 4.7 способна обрабатывать изображения с разрешением до 2576 пикселей по длинной стороне — примерно 3,75 мегапикселя.
Это представляет собой трехкратное увеличение разрешения по сравнению с предыдущими версиями. Для разработчиков, создающих агентов для «управления компьютером», которым приходится ориентироваться в плотных интерфейсах с высоким DPI, или для аналитиков, извлекающих данные из сложных технических схем, это изменение фактически снимает ограничение «размытого зрения», ранее сдерживавшее автономную навигацию.
Эта визуальная точность отражена в тестах от XBOW, где показатель успешности модели в тестах на визуальную остроту вырос с 54,5% до 98,5%.
Что касается бенчмарков, Opus 4.7 заняла первое место в нескольких критически важных категориях:
-
Интеллектуальная работа (GDPVal-AA): Модель достигла показателя Elo 1753, заметно превзойдя GPT-5.4 (1674) и Gemini 3.1 Pro (1314).
-
Агентское программирование (SWE-bench Pro): Модель успешно решила 64,3% задач против 53.4% у предшественницы.
-
Рассуждения на уровне аспирантуры (GPQA Diamond): Показатель достиг 94,2%, сохранив паритет с самыми передовыми моделями в отрасли и улучшив внутреннюю согласованность.
-
Визуальные рассуждения (arXiv Reasoning): С использованием инструментов модель набрала 91,0%, что является значительным скачком по сравнению с 84,7% у Opus 4.6.
Крайне важно, что Anthropic предупреждает: возросшая точность требует изменения подхода пользователей к промптинг-инжинирингу. Opus 4.7 следует инструкциям буквально. В то время как старые модели могли «читать между строк» и вольно интерпретировать двусмысленные запросы, Opus 4.7 выполняет точный текст, который ей предоставлен. Это означает, что старые библиотеки промптов могут потребовать перенастройки во избежание неожиданных результатов, вызванных буквальным следованием букве запроса со стороны модели.
Управление бюджетом «мышления»
«Агентская» природа Opus 4.7 — ее склонность делать паузы, планировать и проверять — сопряжена с компромиссом в виде расхода токенов и задержки ответа.
Чтобы решить эту проблему, Anthropic внедряет новый параметр «усилия» (effort). Теперь пользователи могут выбрать уровень усилий xhigh (экстра-высокий), расположенный между high (высоким) и max (максимальным), что позволяет более детально контролировать глубину рассуждений модели применительно к конкретной задаче.
Внутренние данные показывают, что хотя максимальные усилия дают самые высокие баллы (приближаясь к 75% в задачах по программированию), настройка xhigh обеспечивает оптимальный баланс между производительностью и затратами токенов.
Для управления расходами, связанными с такими более «осмысленными» запусками, в Claude API в режиме публичного бета-тестирования вводятся «бюджеты задач» (task budgets). Это позволяет разработчикам устанавливать жесткий лимит на траты токенов для автономных агентов, гарантируя, что затянувшаяся сессия отладки не приведет к неожиданному счету.
Эти изменения продукта свидетельствуют о взрослении рынка, на котором ИИ перестал быть новинкой и превратился в статью производственных расходов, требующую финансовых и операционных защитных барьеров.
Кроме того, в Opus 4.7 используется обновленный токенизатор, который повышает эффективность обработки текста, хотя это может увеличить количество токенов для определенных входных данных в 1,0–1,35 раза.
В среде Claude Code обновление добавляет новую команду /ultrareview . В отличие от стандартных код-ревью, которые ищут синтаксические ошибки, команда /ultrareview призвана имитировать старшего разработчика-человека, указывая на скрытые изъяны проектирования и пробелы в логике.
Кроме того, «автоматический режим» (auto mode) — настройка, при которой Claude может принимать автономные решения без постоянных запросов на разрешение — был распространен на пользователей тарифного плана Max.
Лицензирование, безопасность и «киберразрыв»
Anthropic продолжает соблюдать тонкий баланс в вопросах кибербезопасности. Недавнее объявление об упомянутом партнерстве в сфере кибербезопасности вокруг проекта Mythos с внешними отраслевыми партнерами — известным как «Проект Glasswing» — высветило риски двойного назначения моделей с высоким потенциалом.
Следовательно, хотя флагманская превью-версия Mythos остается ограниченной в доступе, Opus 4.7 служит полигоном для новых автоматизированных средств защиты. Модель включает системы, предназначенные для обнаружения и блокировки запросов, предполагающих кибератаки высокого риска, такие как автоматизированная эксплуатация уязвимостей.
Чтобы сократить разрыв для индустрии безопасности, Anthropic запускает Программу верификации в сфере кибербезопасности (Cyber Verification Program). Она позволяет легитимным профессионалам — исследователям уязвимостей, специалистам по тестированию на проникновение и экспертам red-team — подать заявку на получение доступа к возможностям Opus 4.7 в защитных целях.
Эта модель «верифицированного пользователя» намекает на будущее, в котором самые мощные функции ИИ будут доступны не всем подряд, а строго по профессиональным учетным данным и фреймворкам соответствия.
В задаче воспроизведения уязвимостей кибербезопасности (CyberGym) Opus 4.7 демонстрирует показатель успешности на уровне 73,1%, уступая 83,1% у превью-версии Mythos, но опережая 66,3% у GPT-5.4.
Первые реакции отраслевых партнеров свидетельствуют об измеримых улучшениях в корпоративных рабочих процессах
Ранние отзывы корпоративных клиентов, которыми поделилась Anthropic, указывают на ощутимый сдвиг в восприятии Opus 4.7 по сравнению с 4.6: от «впечатления от технологий» до «опоры на результаты работы».
Кларенс Хуанг (Clarence Huang), вице-президент по технологиям в Intuit, отметил, что способность модели «улавливать собственные логические ошибки на этапе планирования» кардинально меняет скорость работы.
Эту мысль поддержал президент Replit Микеле Катаста (Michele Catasta), заявивший, что модель достигла более высокого качества при меньших затратах на таких задачах, как анализ логов и поиск багов, добавив: «Она действительно ощущается как лучший коллега по работе».
Другие конкретные отзывы включают:
-
Cognition (Devin): Генеральный директор Скотт Ву (Scott Wu) сообщил, что Opus 4.7 способна слаженно работать «часами» и преодолевать сложные проблемы, на которых раньше модели останавливались.
-
Notion: Сара Сакс (Sarah Sachs), руководитель направления ИИ, отметила улучшение многошаговых рабочих процессов на 14% и сокращение ошибок при вызове инструментов на 66%, благодаря чему агент воспринимается как «настоящий товарищ по команде».
-
Factory Droids: Лео Чураков (Leo Tchourakov) заметил, что модель доводит работу до этапов валидации, а не «останавливается на полпути», на что часто жаловались в отношении предыдущих передовых моделей.
-
Harvey: Нико Групен (Niko Grupen), руководитель отдела прикладных исследований, отметил результат модели в 90,9% на BigLaw Bench, подчеркнув ее «заметно более умную работу со сложными задачами по редактированию документов».
Пожалуй, самый показательный отзыв оставил Ай Орбах (Aj Orbach), генеральный директор компании по созданию дашбордов, который отметил «дизайнерский вкус» модели, подчеркнув, что ее решения для интерфейсов с большим объемом данных имеют такое качество, которое он готов «реально выпустить в продакшн».
Стоит ли предприятиям немедленно переходить на Opus 4.7?
Для корпоративных лидеров Claude Opus 4.7 знаменует собой переход генеративного ИИ из статуса «творческого ассистента» в статус «надежного исполнителя».
Но что важно, она не является универсальным победителем для каждого сценария использования.
Вместо этого это решительное обновление для команд, создающих автономных агентов или сложные программные системы. Главное ценностное предложение заключается в новой способности модели к самоверификации и строгости; она больше не просто генерирует ответ, а создает внутренние тесты для проверки его правильности перед выдачей результата. Такая надежность делает ее превосходным выбором для долгосрочных инженерных задач, где затраты на человеческий контроль являются главным узким местом.
Тем не менее, немедленный и полный переход с Opus 4.6 требует осторожности. Возросший буквализм модели при следовании инструкциям означает, что промт-инжиниринг, созданный как «свободный» или разговорный в предыдущих версиях, теперь может приводить к неожиданным или излишне жестким результатам.
Кроме того, предприятиям следует подготовиться к значительному росту операционных расходов. В Opus 4.7 используется обновленный токенизатор, который может увеличить количество входных токенов в 1,0–1,35 раза, а ее склонность «сильнее думать» при высоких усилиях приводит к повышенному потреблению выходных токенов.
Для устаревших приложений, где промты хрупкие, а маржа узкая, рекомендуется поэтапное внедрение со значительной перенастройкой.
Какое место она занимает для Anthropic в гонке ИИ
Этот релиз происходит в парадоксальный для Anthropic момент. В финансовом отношении компания является бесспорным гигантом: венчурные фонды, по сообщениям, предлагают инвестиции при колоссальной оценке в $800 млрд — более чем вдвое превышающей ее оценку в $380 млрд при раунде Серии G в феврале 2026 года.
Этот импульс подпитывается взрывным ростом: годовая рур-выручка компании в апреле 2026 года взлетела до $30 млрд, чему во многом способствовало корпоративное внедрение и успех Claude Code.
Тем не менее, этот коммерческий успех сталкивается с жестким регуляторным и техническим сопротивлением. Anthropic в настоящее время вовлечена в судебную тяжбу с высокими ставками против Министерства войны США (DoW), которое недавно объявило компанию «риском для цепочки поставок» после того, как Anthropic отказалась разрешить использование своих моделей для массовой слежки или полностью автономного летального оружия.
Хотя судья в Сан-Франциско изначально заблокировал это решение, федеральная коллегия апелляционного суда недавно отклонила ходатайство Anthropic о приостановке внесения в черный список, оставив компанию исключенной из прибыльных оборонных контрактов в период активного военного конфликта.
Параллельно Anthropic отбивается от нарастающего бунта со стороны своих самых преданных пауэр-юзеров. Несмотря на статус «лидера рынка», разработчики заполнили GitHub и X обвинениями в «сокращении производительности ИИ» (AI shrinkflation), утверждая, что предыдущая модель Opus 4.6 и продукт Claude Code были тихо ухудшены.
Пользователи сообщают, что последние версии более склонны к циклам исследования, потере памяти и игнорированию инструкций, из-за чего некоторые описывают недавно выпущенное десктопное приложение Claude Code как «неотполированное» и недостойное компании с почти триллионной оценкой. Opus 4.7 — это попытка Anthropic заставить этих критиков замолчать, доказав, что «глубокое мышление» можно сочетать с тем жестким исполнением, которого теперь требуют ее корпоративные клиенты.
В конечном счете, Opus 4.7 — это модель, определяемая ее дисциплиной. На рынке, где модели часто стимулируются быть «полезными» в ущерб всему остальному — порой галлюцинируя в ответе ради угождения пользователю — Opus 4.7 знаменует собой возвращение к строгости. Позволяя пользователям контролировать усилия, устанавливать бюджеты и верифицировать результаты, Anthropic приближается к цели создания поистине автономной цифровой рабочей силы. Для инженерных команд в Replit, Notion и за их пределами переход от «наблюдения за работой ИИ» к «управлению результатами ИИ» официально начался.




