


Новая модель Qwen 3.5 от Alibaba превосходит более крупную модель с триллионом параметров — приличном снижении затрат


Alibaba выпустила модель Qwen3.5 в начале этой недели, приурочив релиз к Лунному новому году, и уже одни только ключевые показатели заставляют корпоративных покупателей ИИ остановиться и обратить на нее внимание.
Новая флагманская модель с открытыми весами — Qwen3.5-397B-A17B — насчитывает в общей сложности 397 миллиардов параметров, но активирует лишь 17 миллиардов на один токен. Она демонстрирует победы в бенчмарках над предыдущим флагманом Alibaba, Qwen3-Max, моделью, которая, по собственному признанию компании, превышала один триллион параметров.
Этот релиз знаменует собой важный момент в закупках корпоративного ИИ. Для ИТ-лидеров, оценивающих ИИ-инфраструктуру на 2026 год, Qwen 3.5 выдвигает иной аргумент: модель, которую вы действительно можете запускать, которой можете владеть и которую можете контролировать, теперь способна на равных конкурировать с моделями, которые приходится брать в аренду.
Новая архитектура, созданная для высокой скорости в масштабе
Инженерная история Qwen3.5 берет свое начало от ее предшественников. Модель является прямым преемником экспериментальной Qwen3-Next, вышедшей в сентябре прошлого года — ультраразреженной MoE-модели ( Mixture of Experts), которая представляла собой предварительную версию и многими считалась недообученной. Qwen3.5 развивает это архитектурное направление и агрессивно масштабирует его, увеличивая количество экспертов со 128 в предыдущих моделях Qwen3 MoE до 512 экспертов в новом релизе.
Практическим следствием этого и применения улучшенного механизма внимания (attention mechanism) стала значительно более низкая задержка вывода (inference latency). Поскольку для любого конкретного прямого прохода (forward pass) активны лишь 17 миллиардов из этих 397 миллиардов параметров, вычислительные затраты гораздо ближе к плотной (dense) модели на 17B, чем на 400B, — в то время как для специализированных рассуждений модель может задействовать всю глубину своего пула экспертов.
Прирост скорости весьма существенен. При длине контекста в 256K токенов Qwen 3.5 декодирует в 19 раз быстрее, чем Qwen3-Max, и в 7,2 раза быстрее, чем модель Qwen 3 235B-A22B.
Alibaba также заявляет, что запуск модели обходится на 60% дешевле по сравнению с предшественницей, а ее способность справляться с крупными параллельными рабочими нагрузками выше в восемь раз — показатели, которые имеют колоссальное значение для любой команды, следящей за расходами на вывод. Кроме того, ее стоимость составляет примерно 1/18 от стоимости Google Gemini 3 Pro.
Эти достижения усиливаются еще двумя архитектурными решениями:
-
Qwen3.5 использует предсказание нескольких токенов (multi-token prediction) — подход, впервые опробованный в ряде проприетарных моделей, который ускоряет сходимость при предварительном обучении и увеличивает пропускную способность.
-
Она также наследует систему внимания от Qwen3-Next, выпущенной в прошлом году и разработанной специально для снижения нагрузки на память при очень большой длине контекста.
В результате получилась модель, которая может комфортно работать в пределах окна контекста в 256K токенов в версии с открытыми весами и до 1 миллиона токенов в хостинговом варианте Qwen3.5-Plus на платформе Alibaba Cloud Model Studio.
Нативная мультимодальность без «прикручивания» сбоку
Годами компания Alibaba придерживалась стандартного отраслевого подхода: создавать языковую модель, а затем прикреплять к ней энкодер визуальных данных для получения отдельного VL-варианта. Qwen3.5 полностью отказывается от этого шаблона. Модель обучается с нуля одновременно на тексте, изображениях и видео, что означает интеграцию визуальных рассуждений в базовые представления модели, а не их искусственное добавление.
На практике это имеет большое значение. Нативно мультимодальные модели, как правило, превосходят аналоги на базе адаптеров в задачах, требующих тесного сопоставления текста и изображения — например, при анализе технической схемы вместе с ее документацией, обработке снимков экрана пользовательского интерфейса для агентских задач или извлечении структурированных данных из сложных визуальных макетов. В тесте MathVista модель набирает 90,3 балла; в MMMU — 85,0 баллов. Она уступает Gemini 3 в нескольких специфических для работы с изображениями бенчмарках, но превосходит Claude Opus 4.5 в мультимодальных задачах и показывает конкурентные результаты в сравнении с GPT-5.2, обладая при этом лишь фракцией от общего числа параметров.
Результаты Qwen3.5 в бенчмарках в сравнении с более крупными проприетарными моделями — это именно тот показатель, который будет определять дискуссии в корпоративной среде.
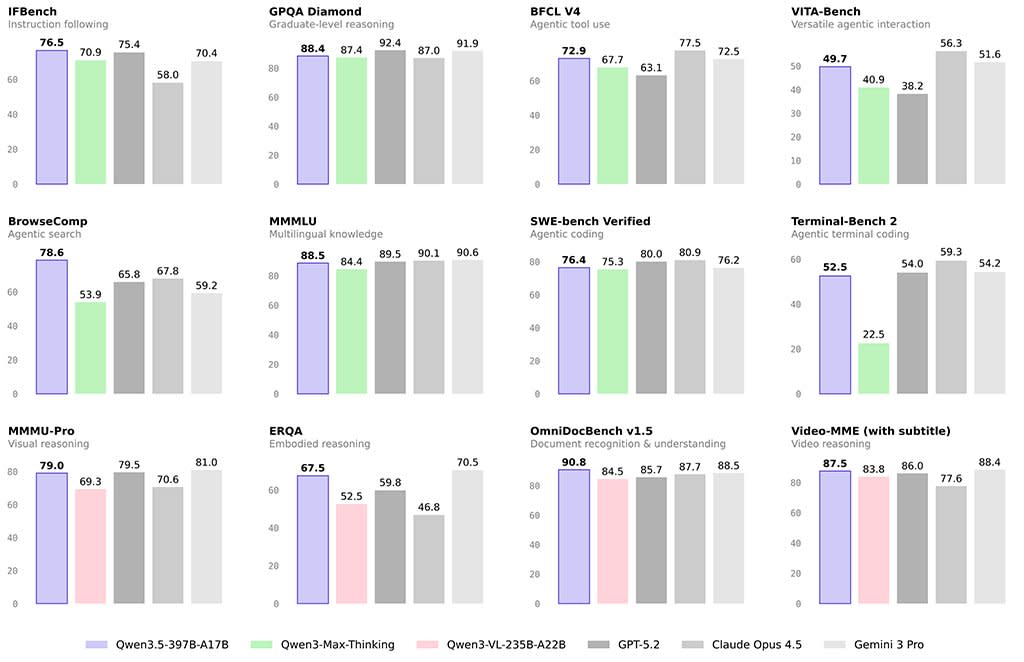
Согласно опубликованным Alibaba тестам, модель 397B-A17B превосходит Qwen3-Max — модель с более чем триллионом параметров — в различных задачах на рассуждение и написание кода.
График тестов Qwen3.5-397B-A17B. Источник: Alibaba Qwen
Она также заявляет о конкурентоспособных результатах по сравнению с GPT-5.2, Claude Opus 4.5 и Gemini 3 Pro в общих тестах на рассуждение и программирование.
Языковое покрытие и эффективность токенизатора
Одной из деталей релиза Qwen3.5, которой уделяют незаслуженно мало внимания, является расширенный многоязычный охват. Словарь модели вырос до 250 тыс. токенов по сравнению со 150 тыс. в предыдущих поколениях Qwen и теперь сопоставим с токенизатором Google на ~256K. Поддержка языков расширилась со 119 языков в Qwen 3 до 201 языка и диалекта.
Обновление токенизатора напрямую влияет на затраты при глобальном развертывании. Более крупные словари кодируют нелатинские письменности — арабский, тайский, корейский, японский, хинди и другие — более эффективно, сокращая количество токенов на 15–40% в зависимости от языка. Для ИТ-организаций, использующих ИИ в масштабах всей компании с многоязычной пользовательской базой, это не просто академическая деталь. Это напрямую переводится в снижение затрат на вывод и ускорение времени отклика.
Агентные возможности и интеграция с OpenClaw
Alibaba позиционирует Qwen3.5 именно как агентную модель — инструмент, созданный не просто для ответов на запросы, а для совершения многошаговых автономных действий от лица пользователей и систем. Компания выложила в открытый доступ Qwen Code — интерфейс командной строки, позволяющий разработчикам делегировать модели сложные задачи по кодированию на естественном языке, что примерно аналогично Claude Code от Anthropic.
В релизе также подчеркивается совместимость с OpenClaw, открытым агентным фреймворком, который в этом году резко вырос по популярности среди разработчиков. Используя 15 000 различных сред для обучения с подкреплением (RL), призванных отточить навыки рассуждения и выполнения задач модели, команда Qwen сделала осознанную ставку на RL-обучение для повышения практической эффективности агентов — тенденция, согласующаяся с тем, что продемонстрировала MiniMax с моделью M2.5.
Хостинговый вариант Qwen3.5-Plus также поддерживает адаптивные режимы вывода: быстрый режим для приложений, чувствительных к задержкам; режим размышлений (thinking mode), обеспечивающий расширенную цепочку рассуждений для сложных задач; и автоматический (адаптивный) режим, который осуществляет выбор динамически. Такая гибкость важна для корпоративных внедрений, где одна и та же модель может одновременно обслуживать взаимодействие с клиентами в реальном времени и глубокие аналитические рабочие процессы.
Реалии развертывания: что действительно нужно знать ИТ-командам
Запуск открытых весов Qwen3.5 на собственных мощностях требует серьезного железа. Квантованная версия требует около 256 ГБ оперативной памяти, а для комфортного запаса — реально все 512 ГБ. Это модель не для рабочей станции или скромного локального (on-prem) сервера. То, для чего она подходит — это GPU-нод (графический узел), конфигурация, которую многие предприятия уже используют для рабочих нагрузок вывода, и которая теперь представляет собой убедительную альтернативу развертываниям, зависящим от API.
Все модели Qwen 3.5 с открытыми весами выпускаются под лицензией Apache 2.0. Это существенное отличие от моделей с пользовательскими или ограниченными лицензиями: Apache 2.0 разрешает коммерческое использование, модификацию и перераспределение без роялти и каких-либо значимых скрытых условий. Для юридических отделов и команд по закупкам, оценивающих открытые модели, такая чистая лицензионная позиция значительно упрощает диалог.
Что дальше
Alibaba подтвердила, что это первый релиз в семействе Qwen3.5, а не полное развертывание. Основываясь на опыте Qwen3, которая включала модели размером вплоть до 600 миллионов параметров, индустрия ожидает появления в ближайшие недели и месяцы более мелких плотных дистиллированных моделей и дополнительных конфигураций MoE. Модель Qwen3-Next 80B из сентябрьского релиза широко считалась недообученной, что намекает на вероятный скорый выпуск версии 3.5 на этом масштабе.
Для ИТ-директоров траектория очевидна. Alibaba продемонстрировала, что модели с открытыми весами на передовом рубеже больше не являются компромиссом. Qwen3.5 — это реальный вариант для закупок для команд, которым нужны рассуждения передового уровня, нативные мультимодальные возможности и окно контекста в 1 миллион токенов — без привязки к проприетарному API. Следующий вопрос заключается не в том, достаточно ли способно это семейство моделей. Вопрос в том, готовы ли ваша инфраструктура и команда извлечь из этого выгоду.
Модель Qwen 3.5 доступна на Hugging Face под идентификатором модели Qwen/Qwen3.5-397B-A17B. Хостинговый вариант Qwen3.5-Plus доступен через Alibaba Cloud Model Studio. Qwen Chat по адресу chat.qwen.ai предоставляет бесплатный публичный доступ для оценки.




