


Qwen3-Max Thinking превосходит Gemini 3 Pro и GPT-5.2 в Humanity's Last Exam (с поиском)


Китайские компании, специализирующиеся на искусственном интеллекте и высоких технологиях, продолжают поражать своими разработками в области передовых языковых моделей ИИ.
Сегодня всеобщее внимание привлекает команда исследователей ИИ Qwen Team из Alibaba Cloud, представившая новую проприетарную модель языковых рассуждений Qwen3-Max-Thinking.
Как вы, возможно, помните из прошлогодних публикаций VentureBeat, Qwen завоевала себе имя на стремительно развивающемся мировом рынке ИИ, выпуская разнообразные мощные модели с открытым исходным кодом в различных модальностях — от текста и изображений до разговорного аудио. Компания даже получила одобрение от американского гиганта в сфере жилья Airbnb, генеральный директор и соучредитель которого Брайан Чески заявил, что компания полагается на бесплатные модели Qwen с открытым исходным кодом как на более доступную альтернативу американским аналогам, таким как продукты от OpenAI.
Теперь, выпустив проприетарную модель Qwen3-Max-Thinking, команда Qwen стремится не только догнать, но в некоторых случаях и превзойти возможности рассуждения GPT-5.2 и Gemini 3 Pro за счет архитектурной эффективности и агентной автономности.
Этот релиз появляется в критически важный момент. Западные лаборатории в основном сформировали категорию «рассуждений» (часто называемую логикой «Системы 2»), однако последние бенчмарки Qwen показывают, что этот разрыв сократился.
Кроме того, относительно доступная стратегия ценообразования API компании агрессивно нацелена на корпоративное внедрение. Тем не менее, поскольку это китайская модель, некоторые американские компании со строгими требованиями и соображениями национальной безопасности могут относиться к ее внедрению с осторожностью.
Архитектура: новое осмысление «масштабирования во время тестирования»
Ключевой инновацией, лежащей в основе Qwen3-Max-Thinking, является отход от стандартных методов вывода. В то время как большинство моделей генерируют токены линейно, Qwen3 использует «тяжелый режим», управляемый техникой, известной как «масштабирование во время тестирования» (Test-time scaling).
Проще говоря, этот метод позволяет модели обменивать вычислительные ресурсы на интеллектуальные способности. Но в отличие от наивной выборки «best-of-N» (когда модель может сгенерировать 100 ответов и выбрать лучший из них), Qwen3-Max-Thinking использует многораундовую стратегию с накоплением опыта.
Этот подход имитирует решение задач человеком. Когда модель сталкивается со сложным запросом, она не просто угадывает; она вовлекается в итеративную рефлексию. Она использует проприетарный механизм «извлечения опыта» для извлечения инсайтов из предыдущих шагов рассуждения. Это позволяет модели:
-
Выявлять тупиковые пути: распознавать, когда цепочка рассуждений заходит в тупик, без необходимости полностью ее проходить.
-
Концентрировать вычислительную мощность: перенаправлять производительность на «нерешенные неопределенности», а не на повторный вывод уже известных выводов.
Прирост эффективности вполне осязаем. Избегая избыточных рассуждений, модель интегрирует более богатый исторический контекст в то же окно. Команда Qwen сообщает, что этот метод привел к огромному скачку производительности без резкого роста затрат на токены:
За пределами чистого мышления: адаптивные инструменты
Хотя модели «мышления» очень мощны, исторически они были изолированы — они отлично справляются с математикой, но плохо ищут информацию в интернете или выполняют код. Qwen3-Max-Thinking преодолевает этот разрыв, эффективно интегрируя «режимы размышления и работы без размышлений».
Модель обладает возможностями адаптивного использования инструментов, что означает, что она автономно выбирает правильный инструмент для задачи без подсказок пользователя. Она может бесшовно переключаться между:
-
Поиском в интернете и извлечением данных: для получения актуальных фактических запросов в реальном времени.
-
Памятью: для хранения и вызова пользовательского контекста.
-
Интерпретатором кода: для написания и выполнения фрагментов кода на Python для вычислительных задач.
В «режиме мышления» модель поддерживает эти инструменты одновременно. Эта способность имеет решающее значение для корпоративных приложений, где модели может потребоваться проверить факт (Поиск), рассчитать прогноз (Интерпретатор кода), а затем проанализировать стратегические последствия (Мышление) — и всё это за один цикл.
Эмпирическим путем команда отмечает, что эта комбинация «эффективно смягчает галлюцинации», поскольку модель может обосновывать свои рассуждения проверяемыми внешними данными, а не полагаться исключительно на свои веса обучения.
Анализ бенчмарков: о чем говорят данные
Qwen не уклоняется от прямых сравнений.
В бенчмарке HMMT (февраль 2025 г.), представляющем собой строгий тест на рассуждения, Qwen3-Max-Thinking набрала 98,0 балла, немного опередив Gemini 3 Pro (97,5) и значительно опередив DeepSeek V3.2 (92.5).
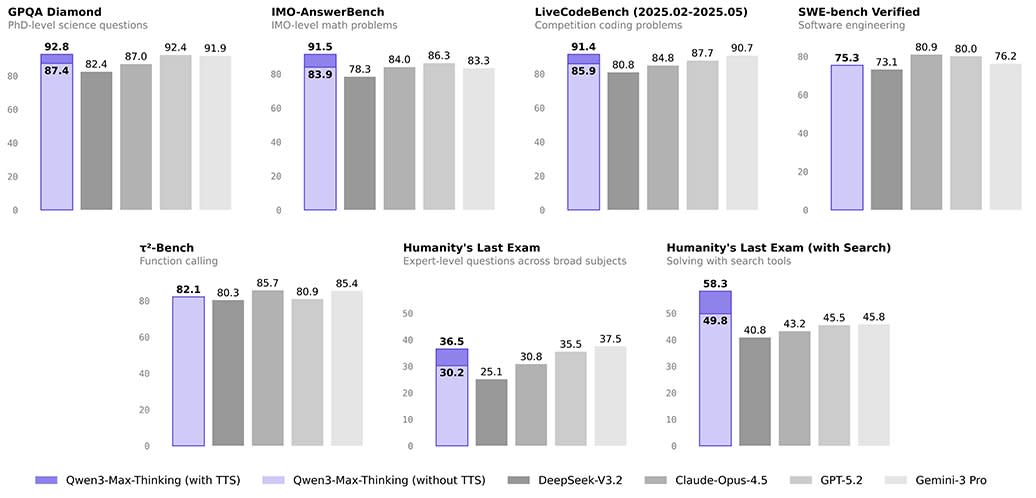
Тем не менее, самым важным сигналом для разработчиков является, пожалуй, агентный поиск. В тесте «Humanity’s Last Exam» (HLE) — бенчмарке, который измеряет производительность на 3000 «защищенных от Google» вопросов уровня аспирантуры по математике, естественным наукам, информатике, гуманитарным наукам и инженерии — Qwen3-Max-Thinking, оснащенная инструментами поиска в интернете, набрала 49,8 балла, обогнав как Gemini 3 Pro (45,8), так и GPT-5.2-Thinking (45,5).
Ключевые бенчмарки Qwen3-Max. Источник: команда Alibaba Cloud Qwen на X
Это говорит о том, что архитектура Qwen3-Max-Thinking уникально подходит для сложных многошаговых агентных рабочих процессов, где требуется извлечение внешних данных.
В задачах по программированию модель также сияет. В тесте Arena-Hard v2 она набрала 90,2 балла, оставив позади таких конкурентов, как Claude-Opus-4.5 (76.7).
Экономика рассуждений: анализ цен
Впервые мы получили четкое представление об экономике топовой модели рассуждений от Qwen. Alibaba Cloud позиционирует qwen3-max-2026-01-23 как премиальное, но доступное предложение через свой API.
На базовом уровне соотношение цен Qwen3-Max-Thinking выглядит следующим образом:
|
Модель |
Входные данные (/1M) |
Выходные данные (/1M) |
Общая стоимость |
Источник |
|
Qwen 3 Turbo |
$0.05 |
$0.20 |
$0.25 |
|
|
Grok 4.1 Fast (с рассуждениями) |
$0.20 |
$0.50 |
$0.70 |
|
|
Grok 4.1 Fast (без рассуждений) |
$0.20 |
$0.50 |
$0.70 |
|
|
deepseek-chat (V3.2-Exp) |
$0.28 |
$0.42 |
$0.70 |
|
|
deepseek-reasoner (V3.2-Exp) |
$0.28 |
$0.42 |
$0.70 |
|
|
Qwen 3 Plus |
$0.40 |
$1.20 |
$1.60 |
|
|
ERNIE 5.0 |
$0.85 |
$3.40 |
$4.25 |
|
|
Gemini 3 Flash Preview |
$0.50 |
$3.00 |
$3.50 |
|
|
Claude Haiku 4.5 |
$1.00 |
$5.00 |
$6.00 |
|
|
Qwen3-Max Thinking (2026-01-23) |
$1.20 |
$6.00 |
$7.20 |
|
|
Gemini 3 Pro (≤200K) |
$2.00 |
$12.00 |
$14.00 |
|
|
GPT-5.2 |
$1.75 |
$14.00 |
$15.75 |
|
|
Claude Sonnet 4.5 |
$3.00 |
$15.00 |
$18.00 |
|
|
Gemini 3 Pro (>200K) |
$4.00 |
$18.00 |
$22.00 |
|
|
Claude Opus 4.5 |
$5.00 |
$25.00 |
$30.00 |
|
|
GPT-5.2 Pro |
$21.00 |
$168.00 |
$189.00 |
Эта ценовая структура выглядит агрессивно, подрывая позиции многих устаревших флагманских моделей и обеспечивая при этом производительность ультравысокого уровня.
Тем не менее, разработчикам следует обратить внимание на детальное ценообразование новых агентных возможностей, поскольку Qwen разделяет стоимость «мышления» (токенов) и стоимость «действия» (использования инструментов).
-
Стратегия агентного поиска: И стандартный
search_strategy:agent, и более продвинутыйsearch_strategy:agent_maxстоят $10 за 1 000 вызовов. -
Поиск в интернете: Стоит $10 за 1 000 вызовов через Responses API.
Промо-период с бесплатным доступом: Чтобы стимулировать внедрение своих самых передовых функций, Alibaba Cloud в настоящее время предлагает два ключевых инструмента бесплатно в течение ограниченного времени:
Эта модель ценообразования (низкая стоимость токенов + цена инструментов à la carte) позволяет разработчикам создавать сложных агентов, которые экономически эффективны для обработки текста, и платить повышенную ставку только тогда, когда явно запускаются внешние действия, такие как поиск в реальном времени в интернете.
Экосистема для разработчиков
Понимая, что производительность бесполезна без интеграции, компания Alibaba Cloud обеспечила готовность Qwen3-Max-Thinking к немедленному использованию «из коробки».
-
Совместимость с OpenAI: API поддерживает стандартный формат OpenAI, позволяя командам переключаться между моделями простой сменой имени
base_urlиmodel. -
Совместимость с Anthropic: В качестве продуманного шага по захвату рынка программирования API также поддерживает протокол Anthropic. Это делает Qwen3-Max-Thinking совместимым с Claude Code — популярной средой для агентного написания кода.
Вердикт
Qwen3-Max-Thinking представляет собой взросление рынка искусственного интеллекта в 2026 году. Этот релиз переносит фокус обсуждения с вопроса «у кого самый умный чат-бот» на вопрос «у кого самый способный агент».
Сочетая высокоэффективные рассуждения с адаптивным автономным использованием инструментов и установив конкурентную цену, компания Qwen прочно закрепила за собой статус главного претендента на престол корпоративного ИИ.
Для разработчиков и предприятий окна «бесплатно в течение ограниченного времени» для интерпретатора кода и веб-экстрактора показывают, что сейчас самое время для экспериментов. Война рассуждений далека от завершения, но Qwen только что задействовала очень тяжелую артиллерию.




