


Сложнейшие задачи, с которыми сталкиваются технические директора (CTO) при внедрении ИИ-агентов, обусловлены неполными стандартами идентификации агентов, кустарными инструментами и тем, что компании внедряют агентов быстрее, чем успевают разрабатываться регулирующие их нормативные рамки
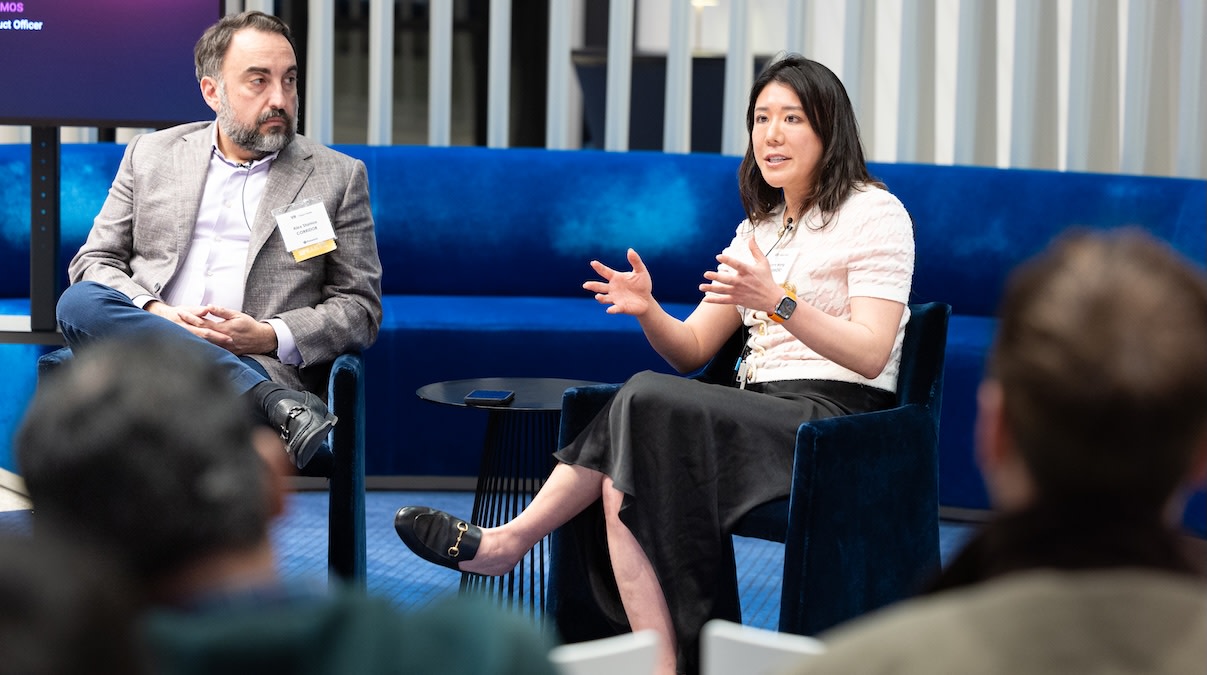


Когда ИИ-агенту необходимо войти в вашу CRM-систему, извлечь записи из базы данных и отправить от вашего имени электронное письмо, чью именно идентичность он использует? И что происходит, когда никто не знает ответа на этот вопрос? Алекс Стамос (Alex Stamos), директор по продукту в Corridor, и Нэнси Ван (Nancy Wang), технический директор 1Password, приняли участие в серии мероприятий VB AI Impact Salon Series, чтобы обсудить новые проблемы в сфере управления цифровыми идентификационными данными, которые возникают наряду с преимуществами агентного ИИ.
«Если говорить в общем, речь идет не только о том, кому принадлежит этот агент или к какой организации он относится, но и о том, какими полномочиями наделен данный агент, что в конечном итоге трансформируется в вопросы авторизации и доступа», — отметила Ван.
Как 1Password оказалась в эпицентре проблемы идентификации агентов
Ван проследила путь компании 1Password в эту сферу через историю ее собственного продукта. Компания начиналась как менеджер паролей для рядовых пользователей, а ее корпоративное присутствие росло естественным образом по мере того, как сотрудники приносили на рабочие места привычные и заслуживающие доверия инструменты.
«Как только эти люди привыкали к интерфейсу и по-настоящему оценивали стандарты безопасности и конфиденциальности, которые мы гарантируем нашим клиентам, они внедряли его в корпоративную среду», — рассказала она. По ее словам, сейчас с ИИ происходит та же самая динамика. «У агентов тоже есть секреты или пароли, совсем как у людей».
Внутри компании 1Password сталкивается с тем же внутренним противоречием, которое помогает разрешать своим клиентам: как позволить инженерам двигаться быстро и не устраивать при этом бардак в безопасности. Ван отметила, что компания активно отслеживает соотношение инцидентов и кода, сгенерированного искусственным интеллектом, поскольку инженеры используют такие инструменты, как Claude Code и Cursor. «Это метрика, за которой мы пристально следим, чтобы гарантировать создание качественного кода».
Как разработчики создают серьезные риски для безопасности
По словам Стамоса, одно из самых распространенных действий, которые фиксирует Corridor, — это когда разработчики вставляют учетные данные прямо в промпты (запросы), что представляет собой колоссальную угрозу безопасности. Corridor фиксирует подобные случаи и направляет разработчиков на путь правильного управления секретами.
«Обычное дело — просто взять ключ API или имя пользователя с паролем и вставить в промпт, — говорит он. — Мы постоянно с этим сталкиваемся, поскольку подключены к системе и перехватываем запросы».
Ван описала подход 1Password как работу со стороны вывода: сканирование кода в процессе его написания и помещение любых учетных данных в виде простого текста в защищенное хранилище до того, как они будут зафиксированы. Склонность разработчиков использовать метод «скопировать-вставить» для получения доступа к системам напрямую влияет на проектные решения 1Password, которые заключаются в отказе от инструментов безопасности, создающих лишние трудности.
«Если инструмент слишком сложен в использовании, развертывании и освоении, он не будет безопасным, потому что люди, говоря прямо, просто обойдут его и не станут применять», — пояснила она.
Почему нельзя относиться к агенту для написания кода как к традиционному сканеру безопасности
Еще одна проблема при выстраивании обратной связи между агентами безопасности и моделями программирования — это ложные срабатывания, к которым склонны крайне дружелюбные и уступчивые большие языковые модели. К сожалению, подобные ложные срабатывания от сканеров безопасности способны сорвать всю рабочую сессию по написанию кода.
«Если сказать ему, что это уязвимость, он ответит: „Есть, сэр, это полная уязвимость!“», — шутит Стамос. Но при этом он добавляет: «Нельзя допускать ошибок и выдавать ложные срабатывания, потому что, если вы укажете на ошибку и окажетесь неправы, вы полностью подорвете способность модели писать корректный код».
Этот компромисс между точностью и полнотой структурно отличается от того, на оптимизацию чего рассчитаны традиционные инструменты статического анализа, и для достижения нужного уровня задержек (порядка нескольких сотен миллисекунд на одно сканирование) потребовалась серьезная инженерная работа.
Аутентификация — это просто, а вот авторизация вызывает главные трудности
«Обычно агент обладает гораздо большим доступом, чем любое другое программное обеспечение в вашей среде», — отметил Спирос Ксантос (Spiros Xanthos), основатель и генеральный директор Resolve AI, на одном из предыдущих выступлений в рамках мероприятия. — Поэтому вполне понятно, почему команды безопасности очень этим обеспокоены. Ведь если этот вектор атаки будет задействован, это может привести не только к утечке данных, но — что еще хуже — в вашей системе может оказаться нечто, способное действовать от имени злоумышленника».
Так как же наделить автономные агенты ограниченными, аудируемыми и временными идентификационными данными? Ван указала на SPIFFE и SPIRE — стандарты идентификации рабочих нагрузок, разработанные для контейнеризированных сред, — в качестве вариантов, которые тестируются в контексте агентного ИИ. Однако она признала, что такое применение пока выглядит несовершенным.
«Мы пытаемся вбить квадратный колышек в круглое отверстие», — сказала она.
Но аутентификация — это лишь половина дела. Получив учетные данные, что именно агенту разрешено делать на практике? Здесь принцип наименьших привилегий должен применяться скорее к задачам, чем к ролям.
«Вы же не станете выдавать человеку ключ-карту от всего здания с доступом в каждую комнату, — пояснила она. — Вы также не хотите давать агенту „ключи от всех дверей“ — API-ключ для выполнения любых действий на неограниченный срок. Доступ должен быть ограничен по времени, а также привязан к конкретной задаче, которую вы хотите поручить этому агенту».
В корпоративной среде недостаточно будет просто предоставить ограниченный доступ: организациям потребуется точно знать, какой именно агент совершил действие, на основании каких полномочий и какие учетные данные при этом использовались.
Стамос назвал расширения OIDC нынешним фаворитом в дискуссиях по стандартизации, одновременно раскритиковав множество проприетарных решений.
«Существует полсотни стартапов, которые верят, что их запатентованное проприетарное решение победит, — заявил он. — К слову, ни одно из них не выиграет, поэтому я бы не стал их рекомендовать».
При аудитории в миллиард пользователей крайние случаи перестают быть редкостью
Что касается потребительского сектора, Стамос предсказал, что проблема идентификации сойдется вокруг небольшого числа доверенных провайдеров — скорее всего, тех платформ, которые уже обеспечивают аутентификацию пользователей. Опираясь на свой опыт работы директором по информационной безопасности (CISO) в Facebook, где команда ежедневно обрабатывала около 700 000 случаев захвата аккаунтов, он по-новому взглянул на то, как масштаб влияет на понятие «крайнего случая» (edge case).
«Когда вы являетесь CISO компании с миллиардом пользователей, понятие „крайний случай“ означает реальный вред для людей, — пояснил он. — И поэтому идентификация как для обычных людей, так и для агентов в будущем станет колоссальной проблемой».
В конечном счете проблемы, с которыми сталкиваются технические директора в сфере агентного ИИ, проистекают из неполноты стандартов агентской идентичности, импровизированных инструментов и того, что компании внедряют агентов быстрее, чем успевают разрабатывать регулирующие их фреймворки. Путь вперед требует создания инфраструктуры идентификации с нуля, ориентированной на то, чем агенты являются на самом деле, а не на переделку того, что строилось для создавших их людей.




