


Уведомления об инъекциях промптов: сравнение 4 лабораторий
Источник: VentureBeat · Louis Columbus


Среди передовых лабораторий самые высокие показатели инъекций промптов (prompt injection), опубликованные этой весной, принадлежат Anthropic. Если натравить «красную команду» (red team) на ее новейшую модель в браузере, злоумышленникам удавалось перехватить ее управление в 31,5% случаев до срабатывания защитных механизмов. OpenAI, Google и Meta никогда не предоставляли руководителям по безопасности сопоставимых цифр, с которыми можно было бы сравнить этот результат. Подобный показатель кажется уязвимостью. Но в данном сравнении все обстоит ровно наоборот. Это единственная твердая почва под ногами.
Четыре ведущие лаборатории опубликовали отчеты об уязвимости к инъекциям промптов, и ни один из них не совпадает с остальными. 28 мая Anthropic выложила на стол 244 страницы и данные по четырем агентским поверхностям. OpenAI отчиталась по одной поверхности — коннекторам. Google перенесла эту тему из карты модели в отдельный документ по безопасности (safety framework). Meta же вообще не выпустила карту для закрытой модели. Представленная ниже сравнительная таблица раскрытия информации об инъекциях промптов от разных производителей сопоставляет то, что тестировала каждая лаборатория, что именно она измеряла, а также четыре аспекта, в которых подобное прямое сравнение рассыпается.
Инъекция промптов скрывает вредоносную инструкцию в чем-то, что читает агент: на веб-странице, в документе или в результате работы инструмента. Одна внедренная строка способна похитить записи или запустить действия, которые никто не утверждал, а подобные отчеты (system cards) — это единственное доказательство от первоисточника, доступное покупателю.
В этой сфере не существует отраслевых стандартов измерения, и в этом кроется корень проблемы. Картер Рис (Carter Rees), вице-президент по искусственному интеллекту в компании Reputation, рассказал VentureBeat, что инъекция промптов разрушает фундаментальные предположения, на которых строились все традиционные инструменты. «Фраза, столь безобидная на вид, как „игнорируй предыдущие инструкции“, может нести в себе полезную нагрузку, столь же разрушительную, как переполнение буфера, и при этом она не имеет ничего общего с известными сигнатурами вредоносного ПО». Поскольку общие сигнатуры для сканирования отсутствуют, каждая лаборатория создала собственную линейку, и результаты не сходятся.
Адам Мейерс (Adam Meyers), старший вице-президент по противодействию противникам в CrowdStrike, заявил, что теперь управление этими рисками ложится на плечи покупателя. «По мере внедрения ИИ ваша поверхность атаки увеличивается, поэтому теперь вы должны уметь защищать эти ИИ-модели от злонамеренного использования злоумышленниками, отравления данных или инъекций промптов». Собственные оперативные данные CrowdStrike показывают, что сторона угроз не стоит на месте. В своем Отчете об угрозах в сфере финансовых услуг за 2026 год, опубликованном в мае, компания сообщила, что злоумышленники используют ИИ для сокращения времени от первоначального доступа до нанесения ущерба быстрее, чем успевают реагировать традиционные средства защиты.
Anthropic измерила четыре поверхности. Цифры различаются на порядок в зависимости от того, какую из них вы изучаете.
Отчет для Opus 4.8 делает то, чего не делают другие: он делит инъекции промптов по поверхностям взаимодействия, и этот разброс как раз и представляет главную ценность.
Если поместить модель в среду разработки (coding environment), адаптивный злоумышленник с помощью инструмента Shade от Gray Swan добивался успеха в 7,03% одиночных попыток при включенном режиме размышлений (thinking on). Защитные механизмы снизили этот показатель до 2,09%.
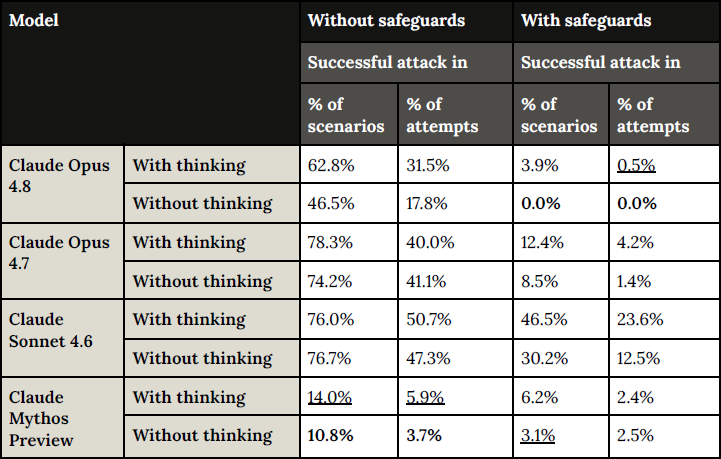
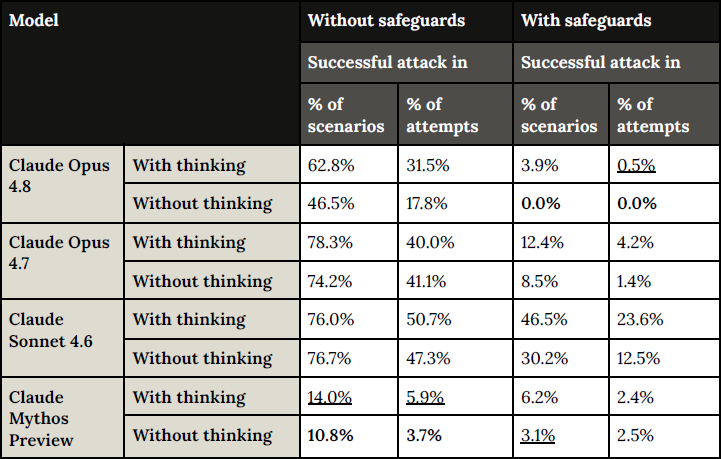
Если перенести атаку того же класса в браузер — среду, которая лежит в основе Claude в Chrome и Claude Cowork, — почва уходит из-под ног. Специалисты Anthropic по тестированию на проникновение провели испытания на 129 веб-средах, исключенных из обучающей выборки, и опубликовали все результаты в Таблице 5.2.2.4.A на странице 81 системной карты. Показатель на одну попытку (per-attempt) отражает долю всех успешных инъекций среди 129 сред по 10 попыток в каждой. Показатель на один сценарий (per-scenario) — это более жесткая метрика, показывающая долю сред, где увенчалась успехом хотя бы одна попытка.
Источник: Системная карта Anthropic Claude Opus 4.8, 28 мая 2026 г.
Если посмотреть на столбец «на одну попытку» без средств защиты (при включенном режиме размышлений), исходная доля успешных атак снижается с каждым новым поколением: от Sonnet 4.6 (50,7%) до Opus 4.8 (31,5%). Самый низкий показатель в таблице, 5,9%, принадлежит Mythos Preview, которую пока никто не может купить. При включении защитных механизмов показатель Opus 4.8 падает до 0,5%. Если же отключить режим размышлений, он падает до нуля во всех 129 средах.
OpenAI измерила только одну поверхность, используя уже известные ей атаки.
В карте модели GPT-5.5, опубликованной 23 апреля и обновленной 24 апреля, инъекциям промптов уделено место лишь в одном разделе, посвященном устойчивости к известным атакам на коннекторы. OpenAI представляет этот результат в виде оценки устойчивости (robustness score), где чем выше балл, тем лучше (это противоположность коэффициента успешности атак). Показатель GPT-5.5 составил 0,963 по сравнению с 0,998 у GPT-5.4-thinking. Эта единственная цифра и представляет собой весь объем раскрытой информации.
Anthropic протестировала четыре поверхности против адаптивного злоумышленника, который меняет свою стратегию в зависимости от поведения модели, а затем провела недельную программу bug bounty, в ходе которой специалисты по безопасности пытались взломать модель в реальном времени. И когда результаты тестирования в среде программирования оказались хуже, чем у Opus 4.7, карта прямо об этом заявила.
Если сопоставить 0,963 и 31,5%, кажется, что они принадлежат к одной системе подсчета. Это не так. Одно — оценка устойчивости к известным атакам на одну поверхность. Другое — доля успешных атак на одну попытку в 129 браузерных средах против злоумышленника, который адаптировался в реальном времени.
Google и Meta вообще не стали указывать эту цифру в своих отчетах
В материалах к релизу Gemini 3 от Google инъекции промптов отнесены к категории мер по минимизации рисков (mitigations), а сопутствующие материалы заявляют о повышенной устойчивости без каких-либо цифровых подтверждений. В отчете о структуре пограничной безопасности (Frontier Safety Framework) тестирование на проникновение действительно проводится, но по различным доменам возможностей, и инъекции промптов в их число не входят. Ни карты модели, ни страниц в документации, ни метрик для конкретных поверхностей, которые специалист по безопасности мог бы использовать при оценке рисков.
Meta выпускает модели с открытыми весами без карт закрытых моделей. Защита от инъекций промптов вынесена в отдельный стек — LlamaFirewall из экосистемы Purple Llama. Классификатор PromptGuard 2 и аудитор AlignmentCheck, запущенные на публичном бенчмарке AgentDojo (состоящем из 97 задач), снижают долю успешных атак с 17,6% (без защиты) до 1,75% в сумме. Это реальные цифры. Но они оценивают защитные барьеры на публичном бенчмарке, а не саму модель на рабочей поверхности, знакомой специалистам по безопасности.
Сравнительная таблица раскрытия информации об инъекциях промптов от разных производителей
Приведенная ниже таблица применима к любой пограничной модели, которую оценивают команды безопасности. Каждая строка отмечает аспект, по которому мнения четырех лабораторий расходятся. Каждое такое расхождение означает, что простое сравнение становится невозможным. Показатели Anthropic взяты из системной карты Opus 4.8. Все данные для остальных трех вендоров — из их официальной документации по безопасности.
|
Параметр |
Anthropic, Opus 4.8 |
OpenAI, GPT-5.5 |
Google, Gemini 3.x |
Meta, стек Llama |
|
Документ по безопасности |
Системная карта, 28 мая 2026 г., 244 страницы |
Системная карта, 23 апреля 2026 г., обновлена 24 апреля |
Карта модели плюс отдельный отчет по структуре пограничной безопасности (Frontier Safety Framework) |
Карта закрытой модели отсутствует. Открытые веса плюс стек Purple Llama |
|
Бенчмарк или датасет инъекций |
ART от Gray Swan и Британского института безопасности ИИ (UK AISI), инструмент Shade, плюс оценка внутреннего браузера, 129 сред |
Оценка внутренних коннекторов, известные атаки |
Отсутствует для инъекций |
AgentDojo, 97 задач |
|
Поверхности с оценкой инъекций |
Четыре. Использование инструментов, программирование, работа за компьютером, браузер |
Одна. Коннекторы |
Не опубликовано для инъекций |
Одна. Задачи агента AgentDojo |
|
Эскалация при множественных попытках |
Да. Бенчмарк ART при 1, 10, 100 попытках. Программирование и работа за компьютером при 1 и 200 |
Нет. Единственная оценка |
Нет |
Нет |
|
Главная метрика и единица измерения |
Коэффициент успешности атак. Браузер, с режимом размышлений: 31,5% исходно, 0,5% с защитой |
Оценка устойчивости (выше — лучше). 0,963 по сравнению с 0,998 у GPT-5.4-thinking |
Не опубликовано. Заявлено качественное повышение устойчивости |
Коэффициент успешности атак в AgentDojo. Снижение с 17,6% (базовый) до 1,75% (в совокупности) |
|
Программа bug bounty в реальном времени |
Да. Недельная публичная программа поиска инъекций с привлечением внешних «красных команд» |
Нет программы по инъекциям. Только по биологическим угрозам |
Не обнаружено |
Не обнаружено |
|
Раскрытие регресса |
Да, явно и с цифрами |
Показатель снизился с 0,998 до 0,963, но это не оформлено как регресс |
Заявлено повышение устойчивости, цифры отсутствуют |
Не применимо |
Пять факторов, которые команды безопасности должны учитывать прямо сейчас
Anthropic протестировала четыре поверхности и опубликовала каждую цифру. OpenAI протестировала одну. Google не опубликовала показатели для отдельных поверхностей. Meta оценила защитные барьеры, а не саму модель. Четыре отчета не складываются в единую картину для сравнения. Следующие пять шагов помогут ее составить.
Проверьте каждого развернутого или планируемого к внедрению агента и классифицируйте его по типу поверхности, с которой он взаимодействует: браузер, код, коннекторы или рабочий стол. Показатель Anthropic для Opus 4.8 составляет 2,09% для программирования и 0,5% для браузера. Усредненное значение не отражает ни то, ни другое. Выясните опубликованный вендором показатель для вашей конкретной поверхности. Если вендор никогда его не публиковал, считайте эту поверхность не протестированной.
Разошлите сравнительную таблицу всем оцениваемым вендорам. Оценка устойчивости коннекторов 0,963 и показатель успешности атак в браузере 31,5% никогда не измерялись по одной шкале. Потребуйте предоставить коэффициент успешности атак для каждой поверхности — как исходный, так и защищенный, с указанием методологии атак. Пустые ячейки означают поверхности, не имеющие доказательств от первоисточника.
Письменно подтвердите, какой именно показатель относится к вашей интеграции. Значение 0,5% от Anthropic получено для Claude в Chrome и Cowork со всем стеком защитных механизмов. В API модель поставляется без них. Не соглашайтесь использовать продуктовый показатель для развертывания через API.
Добавьте два пункта в запрос предложений (RFP). Вендор проводил тестирование с помощью адаптивного злоумышленника, который переписывает полезную нагрузку под конкретную модель, а попытки взлома предпринимались сторонними лицами вне компании. Anthropic запускала адаптивный инструмент Shade от Gray Swan и проводила оплачиваемую недельную программу bounty. OpenAI тестировала известные атаки на одной поверхности. Реальные злоумышленники не используют известные полезные нагрузки.
Проведите собственное тестирование на инъекции до запуска любого агента. Цифры вендоров получены в контролируемых ими средах с использованием их системных промптов. Ваш собственный стек имеет собственные промпты, права доступа и источники данных. Установите пороговое значение для прохождения тестов. Все, что выходит за его рамки, не должно запускаться в производство.
Главный вывод. Стандартов в этой области пока не существует. Цифра от вендора показывает лишь то, что он решил измерить. Ваша собственная «красная команда» показывает, к чему уязвимы именно вы.




