


Фреймворки руководят выбором инструментов искусственного интеллекта


Поскольку экосистема автономных (agentic) инструментов и фреймворков стремительно разрастается, ориентироваться в бесчисленных вариантах создания систем ИИ становится все труднее. Это приводит к тому, что разработчики чувствуют растерянность и паралич при выборе подходящих инструментов и моделей для своих приложений.
В новом исследовании ученые из нескольких институтов представляют комплексную структуру, призванную распутать этот сложный клубок. Они классифицируют агентные фреймворки на основе областей их применения и компромиссов, предоставляя разработчикам практическое руководство по выбору правильных инструментов и стратегий для своих приложений.
Для корпоративных команд это переводит агентный ИИ из плоскости выбора модели в плоскость архитектурного решения: куда направить бюджет на обучение, сколько модульности сохранить и на какие компромиссы между стоимостью, гибкостью и рисками они готовы пойти.
Адаптация агента против адаптации инструментов
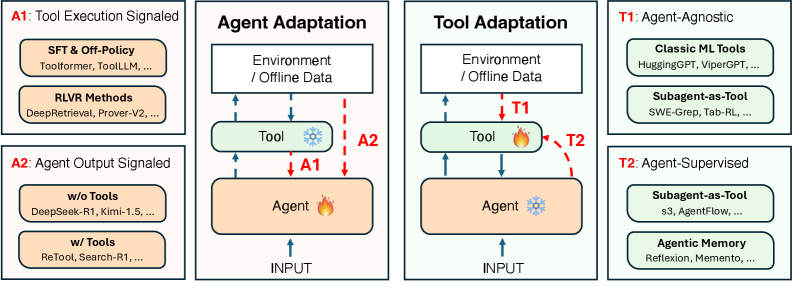
Исследователи разделяют ландшафт на два основных измерения: адаптация агента (agent adaptation) и адаптация инструментов (tool adaptation).
Адаптация агента предполагает модификацию базовой модели, лежащей в основе агентной системы. Это достигается путем обновления внутренних параметров или политик агента с помощью таких методов, как точная настройка (fine-tuning) или обучение с подкреплением, для лучшего соответствия конкретным задачам.
Адаптация инструментов, напротив, переносит фокус на окружающую среду агента. Вместо переобучения крупной и дорогой базовой модели разработчики оптимизируют внешние инструменты, такие как поисковые ретриверы, модули памяти или субагенты. При такой стратегии основной агент остается «замороженным» (неизменным). Такой подход позволяет системе развиваться без колоссальных вычислительных затрат на переобучение ядровой модели.
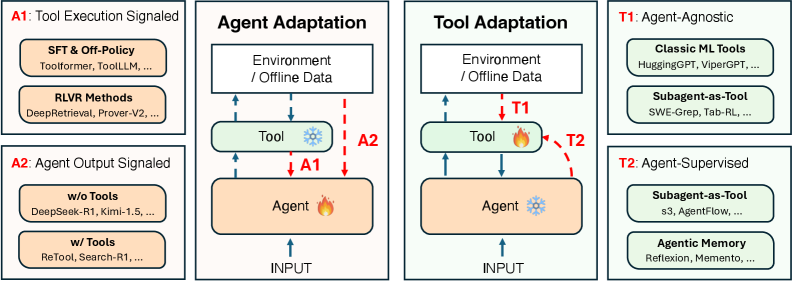
Стратегии адаптации агентов (источник: arXiv)
Исследование подразделяет их на четыре четкие стратегии:
А1: Сигнализация по выполнению инструментов (Tool execution signaled): В этой стратегии агент учится на практике. Он оптимизируется с использованием верифицируемой обратной связи напрямую от выполнения инструмента, например, когда компилятор кода взаимодействует со скриптом или база данных возвращает результаты поиска. Это обучает агента «механике» правильного использования инструмента.
Ярким примером является DeepSeek-R1, где модель обучалась посредством обучения с подкреплением с проверяемыми вознаграждениями для генерации кода, успешно выполняющегося в песочнице. Сигнал обратной связи является бинарным и объективным (код запустился или произошел сбой?). Этот метод формирует сильную низкоуровневую компетентность в стабильных, верифицируемых доменах, таких как программирование или SQL.
А2: Сигнализация по выводу агента (Agent output Signaled): Здесь агент оптимизируется на основе качества своего финального ответа, независимо от промежуточных шагов и количества вызовов инструментов, которые он делает. Это учит агента тому, как координировать различные инструменты для достижения правильного умозаключения.
Примером служит Search-R1 — агент, который выполняет многоэтапный поиск для ответов на вопросы. Модель получает вознаграждение только в том случае, если финальный ответ верен, что неявно заставляет ее изучать лучшие стратегии поиска и рассуждения для максимизации этого вознаграждения. А2 идеально подходит для системной оркестровки, позволяя агентам справляться со сложными рабочими процессами.
Т1: Агентно-независимые инструменты (Agent-agnostic): В этой категории инструменты обучаются независимо на широких данных, а затем «подключаются» к замороженному агенту. Вспомните классические плотные ретриверы, используемые в системах RAG. Стандартная модель ретривера обучается на общих поисковых данных. Мощная замороженная LLM может использовать этот ретривер для поиска информации, даже если ретривер не был разработан специально для этой LLM.
Т2: Инструменты под управлением агента (Agent-supervised): Эта стратегия предполагает обучение инструментов специально для обслуживания замороженного агента. Сигнал контроля исходит от собственного вывода агента, создавая симбиотические отношения, в которых инструмент учится предоставлять ровно то, что нужно агенту.
Например, фреймворк s3 обучает небольшую «поисковую» модель извлекать документы. Эта небольшая модель получает вознаграждение в зависимости от того, сможет ли замороженный «рассуждатель» (большая LLM) правильно ответить на вопрос, используя эти документы. Инструмент эффективно адаптируется для заполнения конкретных пробелов в знаниях основного агента.
Сложные системы ИИ могут использовать комбинацию этих парадигм адаптации. Например, система глубоких исследований может задействовать поисковые инструменты в стиле Т1 (предварительно обученные плотные ретриверы), адаптивные поисковые агенты в стиле Т2 (обученные с помощью обратной связи от замороженной LLM) и рассуждающие агенты в стиле А1 (дообученные на основе обратной связи при выполнении) в рамках более широкой оркестрированной системы.
Скрытые затраты и компромиссы
Для лиц, принимающих решения в компаниях, выбор между этими стратегиями обычно сводится к трем факторам: стоимости, обобщению и модульности.
Стоимость против гибкости: Адаптация агента (А1/А2) предлагает максимальную гибкость, поскольку вы перестраиваете «мозг» агента. Однако затраты высоки. Например, Search-R1 (система А2) потребовала обучения на 170 000 примеров для интериоризации поисковых возможностей. Это требует огромных вычислительных мощностей и специализированных наборов данных. С другой стороны, на этапе инференса такие модели могут быть гораздо эффективнее, поскольку они намного меньше моделей общего назначения.
Напротив, адаптация инструментов (Т1/Т2) гораздо эффективнее. Система s3 (Т2) обучила легковесный поисковик, используя всего 2400 примеров (примерно в 70 раз меньше данных, чем Search-R1), при этом достигнув сопоставимой производительности. Оптимизируя экосистему, а не агента, компании могут добиться высокой производительности при меньших затратах. Тем не менее, это влечет за собой дополнительные накладные расходы на этапе инференса, так как s3 требует координации с более крупной моделью.
Обобщение (Generalization): Методы А1 и А2 рискуют столкнуться с «переобучением» (overfitting), когда агент становится настолько узкоспециализированным в одной задаче, что теряет общие способности. Исследование показало, что, хотя Search-R1 преуспел в своих тренировочных задачах, он испытывал трудности со специализированными медицинскими вопросами и ответами, достигнув точности всего в 71,8%. Это не проблема, если ваш агент предназначен для выполнения очень специфического набора задач.
И наоборот, система s3 (Т2), которая использовала замороженного агента общего назначения в паре с обученным инструментом, обобщала лучше, достигнув точности 76,6% на тех же медицинских задачах. Замороженный агент сохранил свои обширные знания о мире, в то время как инструмент занимался конкретной механикой извлечения. Тем не менее, системы Т1/Т2 полагаются на знания замороженного агента, и если лежащая в основе модель не может справиться с конкретной задачей, они окажутся бесполезными.
Модульность: Стратегии Т1/Т2 обеспечивают «горячую замену» (hot-swapping). Вы можете обновить модуль памяти или поисковик, не затрагивая ядро логики рассуждений. Например, Memento оптимизирует модуль памяти для извлечения прошлых прецедентов; если требования меняются, вы обновляете модуль, а не планировщик.
Системы А1 и А2 монолитны. Обучение агента новому навыку (например, программированию) посредством точной настройки может привести к «катастрофическому забыванию», при котором ухудшаются ранее усвоенные навыки (например, математика), поскольку его внутренние веса перезаписываются.
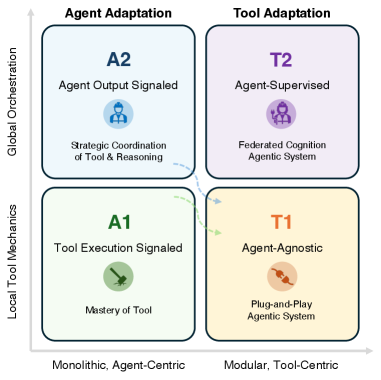
Стоимость и компромиссы различных стратегий адаптации агентов (источник: arXiv)
Стратегический фреймворк для внедрения на уровне предприятия
Основываясь на исследовании, разработчики должны рассматривать эти стратегии как ступенчатую лестницу — переход от низкорисковых модульных решений к кастомизации, требующей больших ресурсов.
Начните с Т1 (агентно-независимые инструменты): Обеспечьте мощную замороженную модель (такую как Gemini или Claude) готовыми инструментами, например, плотным ретривером или коннектором MCP. Это не требует никакого обучения и идеально подходит для прототипирования и общих приложений. Это низко висящий фрукт (самый простой путь), который может продвинуть вас очень далеко в большинстве задач.
Переходите к Т2 (инструменты под управлением агента): Если агент испытывает трудности с использованием универсальных инструментов, не переобучайте основную модель. Вместо этого обучите небольшой специализированный субагент (например, поисковик или менеджер памяти) фильтровать и форматировать данные именно так, как нравится основному агенту. Это высокоэффективно с точки зрения данных и подходит для проприетарных корпоративных данных и приложений с большим объемом и чувствительностью к затратам.
Используйте А1 (сигнализация по выполнению инструментов) для специализации: Если агент фундаментально не справляется с техническими задачами (например, пишет нерабочий код или неверные вызовы API), вам необходимо перенастроить его понимание «механики» инструмента. А1 лучше всего подходит для создания специалистов в верифицируемых областях, таких как SQL, Python, или для ваших собственных проприетарных инструментов. Например, вы можете оптимизировать небольшую модель под свой набор инструментов, а затем использовать ее в качестве плагина Т1 для универсальной модели.
Оставьте А2 (сигнализация по выводу агента) в качестве «ядерного варианта»: Обучайте монолитного агента по принципу end-to-end (от начала до конца) только в том случае, если вам нужно, чтобы он интериоризировал сложную стратегию и самокоррекцию. Это ресурсоемкий процесс, который редко требуется для стандартных корпоративных приложений. В действительности вам редко придется заниматься самостоятельным обучением собственной модели.
По мере того как ландшафт ИИ взрослеет, фокус смещается с создания одной гигантской идеальной модели на построение умной экосистемы специализированных инструментов вокруг стабильного ядра. Для большинства предприятий наиболее эффективный путь к агентному ИИ заключается не в создании более крупного мозга, а в том, чтобы дать этому мозгу лучшие инструменты.




