


ИИ-оптимизатор превосходит Claude Code и Codex в 2,5 раза
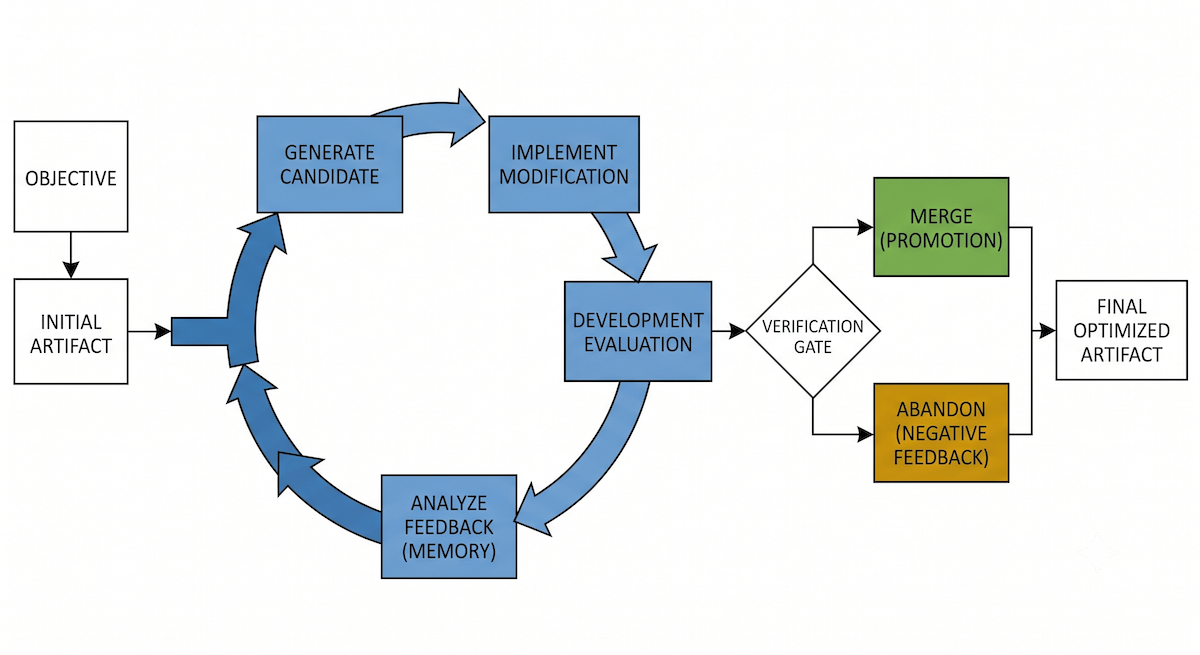


Представьте, что ваша инженерная команда только что развернула ИИ-агент для поиска по внутренним документам компании и ответа на вопросы сотрудников. На этапе разработки всё работает идеально, но в продакшене система постоянно галлюцинирует или упускает ключевые ограничения. Исправить это с помощью простого паттерна удаётся редко. Для этого требуется утомительный метод проб и ошибок, подразумевающий одновременную настройку стратегий разбиения на чанки, методов извлечения данных и системных промптов. Поскольку эти параметры взаимосвязаны, становится практически невозможно определить, какое именно изменение действительно решило проблему.
Чтобы справиться с этой задачей, исследователи из Китайского университета Жэньминь и Microsoft Research представили Arbor — фреймворк, который переводит ИИ-исследования и оптимизацию из разряда последовательных случайных попыток в процесс кумулятивного обучения. Arbor организует гипотезы, эксперименты и выводы в виде дерева, что помогает системе учиться на прошлых ошибках и со временем принимать более разумные и проверенные решения.
В ходе практических тестов Arbor продемонстрировал более чем в 2,5 раза больший верифицируемый прирост производительности по сравнению со стандартными ИИ-агентами для написания кода в реальных инженерных задачах при том же ресурсном бюджете.
Для корпоративного ИИ этот метод напрямую означает автоматизацию непрерывного совершенствования сложных реальных инженерных систем.
Понимание узкого места в автономной оптимизации
По мере того как большие языковые модели и ИИ-системы становятся всё более мощными, от них ожидают выполнения более сложных операций, таких как автономная оптимизация (АО) программных систем, например обвязок агентов (agent harnesses) или алгоритмов обучения моделей.
АО охватывает фундаментальный цикл автономных исследований. ИИ-агент начинает работу с исходным изменяемым артефактом (например, кодовой базой машинного обучения или конвейером данных) и конкретной целью. Цель агента — итеративно улучшать этот артефакт на основе обратной связи от экспериментов без пошагового контроля со стороны человека.
Главную сложность АО часто понимают неправильно. Многие инженерные команды обнаруживают, что простое выделение кодинг-агенту большего времени или вычислительных ресурсов для оптимизации кодовой базы не приводит к лучшим результатам. «Автоматизация может заставлять ИИ работать очень долго, но цикл не равен прогрессу», — рассказал в интервью VentureBeat Цзяцзе Цзи (Jiajie Jin), соавтор научной работы. — «Если цель размыта или метрику легко обмануть, долгосрочная автоматизация часто просто быстрее производит „улучшения“, которые на самом деле никому не нужны».
Цзи объясняет, что для решения сложных задач требуется множество попыток, а в архитектурах стандартных агентов отсутствует критически важная структура данных для поддержания состояния. «Как убедиться, что инсайты и опыт каждой попытки действительно накапливаются, а не теряются в буфере прокрутки?» — говорит он. Без этой структуры агенты просто повторяют одни и те же ошибки.
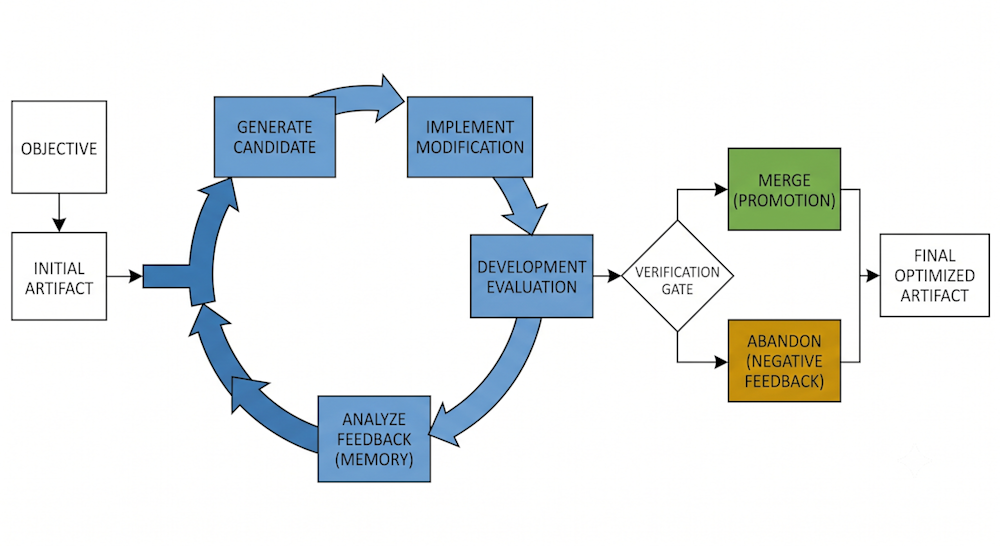
Автономная оптимизация
Существующие агентские системы могут проводить эксперименты в течение многих часов для достижения четко поставленных целей: редактировать код, вызывать инструменты, автономно запускать тесты. Однако они рассматривают каждую попытку изолированно, упуская структурные механизмы, которые позволили бы им накапливать полученный опыт и действовать на его основе.
У них отсутствует способность одновременно поддерживать и сравнивать несколько конкурирующих исследовательских направлений. Без этого они не могут интерпретировать как успехи, так и неудачи для корректировки своего дальнейшего поиска, что является ключевым механизмом, делающим человеческие исследования кумулятивными.
Обычные кодинг-агенты обычно полагаются на стенограммы диалогов в качестве своей памяти. Поскольку задачи АО охватывают сотни шагов и легко превышают лимиты контекстного окна, таким агентам сложно сохранять и повторно использовать фактические данные на длинных дистанциях. В результате они теряют общую структуру исследовательского процесса и склонны зацикливаться на ранних неудачах или гоняться за случайными колебаниями оценок. Системе необходима структурированная, долговечная память, которая фиксирует опробованные направления, полученные фактические данные и то, как каждый результат изменяет пространство будущих гипотез.
Существующие фреймворки также склонны к подгонке наград (reward hacking) и переобучению под метрики разработки. Из-за этого они создают иллюзию прогресса, не обеспечивая реальных улучшений, которые можно перенести на рабочие задачи.
Наконец, универсальные кодинг-агенты обычно связывают вызовы инструментов в цепочку на едином общем рабочем дереве. Это архитектурное ограничение мешает им тестировать параллельные гипотезы в изолированных средах без повреждения основной кодовой базы или искажения понимания того, какая именно гипотеза привела к конкретному результату.
Фреймворк Arbor
Arbor решает проблемы АО с помощью фреймворка, который автоматизирует долгосрочный цикл исследований, экспериментов и абстракции, характерный для научной работы людей. Arbor разделяет стратегическое направление исследований и рутинные задачи по написанию кода с помощью двух ключевых компонентов:
Координатор: долгоживущий ИИ-агент, который действует подобно ведущему исследователю (principal investigator). Он никогда напрямую не редактирует целевую кодовую базу. Вместо этого он управляет общим состоянием исследовательского процесса оптимизации, анализирует накопленные данные, генерирует новые гипотезы и направления для поиска, а также принимает решения о том, как поступить с результатами экспериментов.
Исполнители (Executors): недолговечные, узкоспециализированные ИИ-агенты. Когда координатор хочет протестировать идею, он запускает исполнителя в изолированной среде — по сути, в свежем дереве работы git (git worktree). Каждому исполнителю передается одна гипотеза. Он реализует поставленную задачу, запускает оценки, отлаживает ошибки и возвращает координатору отчет с результатами и созданными артефактами.
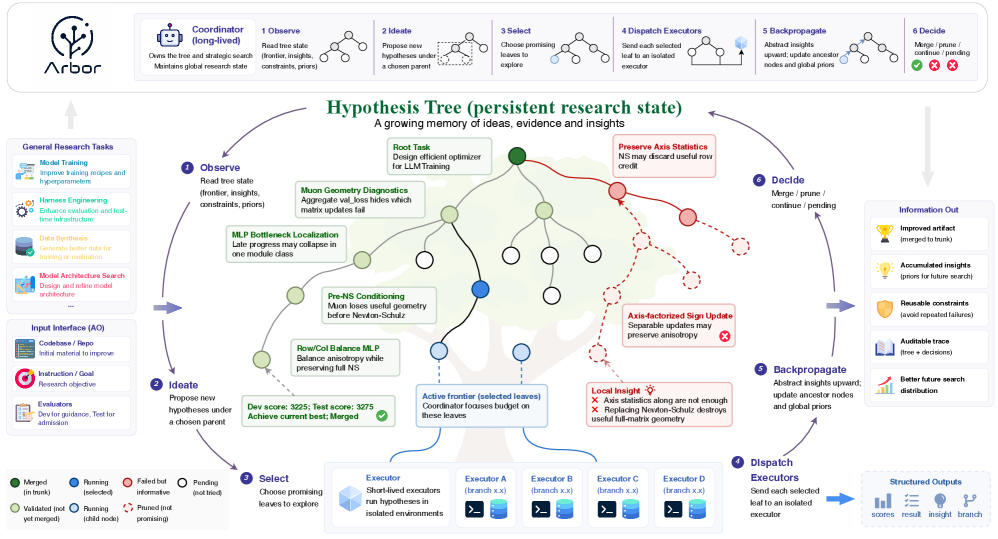
Фреймворк Arbor с уточнением дерева гипотез (HTR) (источник: arXiv)
Эти два компонента взаимодействуют посредством механизма, который исследователи называют «Уточнение дерева гипотез» (Hypothesis Tree Refinement — HTR). HTR представляет весь исследовательский процесс в виде постоянного разветвленного дерева, где каждый узел связывает воедино четыре элемента: гипотезу, исполняемый артефакт, полученные фактические данные и извлеченный инсайт. Это означает, что координатор может исследовать несколько конкурирующих направлений одновременно, не теряя контекста.
Координатор строит дерево, размещая общие идеи ближе к корню, в то время как конкретные улучшения ответвляются в виде листьев. Это позволяет Arbor безопасно исследовать несколько конкурирующих гипотез параллельно. Если эксперимент исполнителя завершается неудачей, дерево фиксирует причину неудачи в качестве негативного ограничения, гарантируя, что система не будет бесконечно повторять ту же ошибку.
Чтобы понять, почему изоляция в Arbor имеет значение, рассмотрим типичный корпоративный сценарий: оптимизацию конвейера RAG (генерации с дополненным поиском) для внутреннего ИИ-ассистента. «Когда вы просите отдельного агента, такого как Claude Code или Codex, „повысить точность“, он обычно меняет множество вещей за один проход — разбиение на чанки, промпт, метод извлечения», — говорит Цзи. Это запутывает изменения, делая невозможным определить, что именно помогло. К тому же это напрямую изменяет репозиторий без какой-либо изоляции.
Arbor решает эту проблему, рассматривая каждый рычаг как отдельную гипотезу. Разбиение на чанки становится одной веткой, поиск — другой, промпт — третьей; при этом каждая из них реализуется и оценивается в собственном изолированном дереве git. «В итоге вы получаете четкую атрибуцию: „декомпозиция ограничений со стороны поиска дала +X; поиск в ширину на самом деле навредил“», — отмечает Цзи.
Когда исполнитель возвращает отчет, координатор записывает данные в дерево и передает инсайт обратно вверх к родительским узлам. Это означает, что локальное наблюдение превращается в обобщенное ограничение, которое формирует будущую генерацию идей координатора.
Чтобы предотвратить награждение за мнимые успехи (reward hacking) или переобучение на данных разработки, HTR вводит строгий «шлюз слияния» (merge gate). Даже если исполнитель сообщает о фантастических результатах разработки, координатор развернет изолированное рабочее дерево для проверки кандидата на отложенном тестовом оценщике. Артефакт объединяется с текущей лучшей веткой (trunk) только в том случае, если он демонстрирует доказанное улучшение тестовой оценки, что подтверждает реальность прогресса.
Arbor в целом укладывается в концепцию «инженерии циклов» (loop engineering), популяризированную такими деятелями индустрии, как создатель OpenClaw Питер Штайнбергер (Peter Steinberger) и лид Claude Code Борис Черный (Boris Cherny). Идея заключается в том, чтобы выйти за рамки простых промптов и проектировать итеративные циклы (наблюдение, рассуждение, действие, проверка), которые управляют автономными агентами. Однако, как отмечает Цзи, «цикл может заполниться хаотичными, не поддающимися отслеживанию попытками, в результате чего у вас ничего не останется и вы не сможете восстановить то, что именно изменилось».
Arbor в действии
Исследователи оценили работу Arbor наборе задач по автономной оптимизации, созданном на основе реальных исследовательских сценариев и бенчмарка машинного обучения MLE-Bench Lite. Набор задач АО включал задачи из различных областей разработки ИИ, включая обучение моделей, проектирование обвязок и синтез данных.
Исследователи использовали разные базовые модели для координатора и агентов-исполнителей, включая Claude Opus 4.6, GPT-5.5 и Gemini-3-Flash. Arbor тестировался в сравнении с сильнейшими кодинг-агентами — Codex и Claude Code. Arbor и базовые модели были обеспечены одинаковыми ресурсами. Для задач из MLE-Bench Lite Arbor также сопоставлялся с передовыми агентскими исследовательскими системами, такими как AI-Scientist, ML-Master и AIDE.
Arbor стабильно превосходил базовые системы. Он показал лучший результат на отложенном тесте по всем задачам, достигнув более чем в 2,5 раза большего среднего относительного прироста по сравнению с Codex и Claude Code. В задаче BrowseComp, связанной с оптимизацией поискового агента, Arbor повысил точность системы на отложенных данных с базовых 45,33% до 67,67%. При этом Codex и Claude Code остановились на показателях в 50% и 53,33% соответственно. В MLE-Bench Lite при использовании GPT-5.5 Arbor добился сильнейшего результата среди всех тестируемых систем.
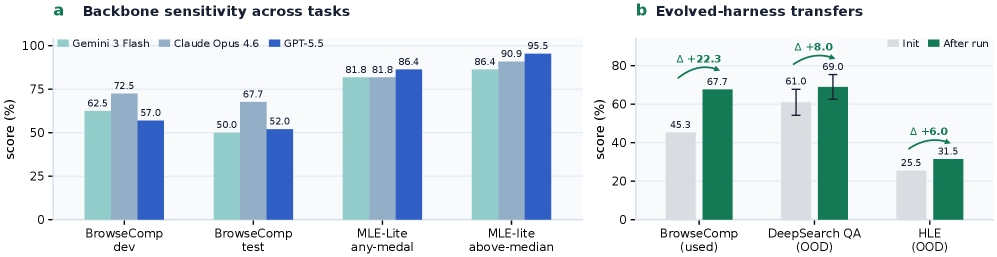
Arbor универсален для различных базовых моделей и обвязок (источник: arXiv)
Arbor продемонстрировал устойчивость к переобучению. Например, во время экспериментов с задачей Terminal-Bench 2.0 агент Claude Code показал высокий балл разработки — 75, но на отложенных данных этот показатель упал до 71. У Arbor балл разработки был ниже (72,22), зато на отложенных данных он показал наивысший результат — 77,36, что гарантирует применимость его результатов в реальных условиях.
Arbor также продемонстрировал способность к генерализации в эксперименте с межзадачным переносом (cross-task transfer). После того как Arbor завершил оптимизацию поисковой обвязки для задачи BrowseComp, исследователи взяли оптимизированную кодовую базу и протестировали ее на двух несвязанных задачах для поисковых агентов — HLE и DeepSearchQA. Оптимизированный кодом Arbor значительно улучшил производительность и в этих неизученных ранее задачах.
Развертывание Arbor: оптимальные сценарии и скрытые издержки
Инженерным лидам, планирующим внедрить Arbor в существующий технологический стек, фреймворк предлагает надстройку над стандартными рабочими процессами Git вместо их замены. «Его вывод — это обычная ветка git, которую ваши существующие инструменты код-ревью, CI и проверки человеком могут напрямую проинспектировать», — говорит Цзи. Только проверенные улучшения объединяются в ствол каждого запуска (per-run trunk), оставляя основной репозиторий нетронутым до тех пор, пока разработчик сам не решит продвинуть код.
Тем не менее, развертывание Arbor связано с определенными компромиссами. Цзи указывает, что главным подводным камнем является стоимость токенов: поддержание долгоживущего координатора, который непрерывно управляет деревом и распределяет задачи между исполнителями, составляет основную статью расходов. Одновременный запуск нескольких изолированных рабочих деревьев также требует реальных вычислительных ресурсов и дискового пространства для обработки реальных экспериментов.
Где же находится «золотая середина» для Arbor? По словам Цзи, фреймворк преуспевает в задачах с четкой, заслуживающей доверия метрикой, толерантностью к длительным временным интервалам и реальным пространством поиска с несколькими правдоподобными направлениями, такими как оптимизация конвейеров, качество синтеза данных и настройка рецептов обучения моделей.
И наоборот, команды должны явно избегать использования Arbor для задач с задержками в реальном времени, очевидных исправлений в одну строку или случаев, когда лежащая в основе метрика оценки несовершенна. Потолок качества всего запуска строго ограничен качеством оценщика. «Если метрика ненадежна, Arbor будет просто быстрее оптимизировать систему в сторону ненадежного результата», — предупреждает Цзи.
Цзи видит следующий этап эволюции в выходе за рамки единичных скалярных метрик. «Естественное развитие заключается в том, чтобы артефакт каждого узла нес в себе вектор — точность, задержка, стоимость — вместо единой оценки», — говорит он. — «Переход от одного скаляра к многоцелевому поиску по Парето — очень естественное расширение этого фреймворка».




