


Сообщество мысли Google повышает возможности искусственного интеллекта в рассуждениях
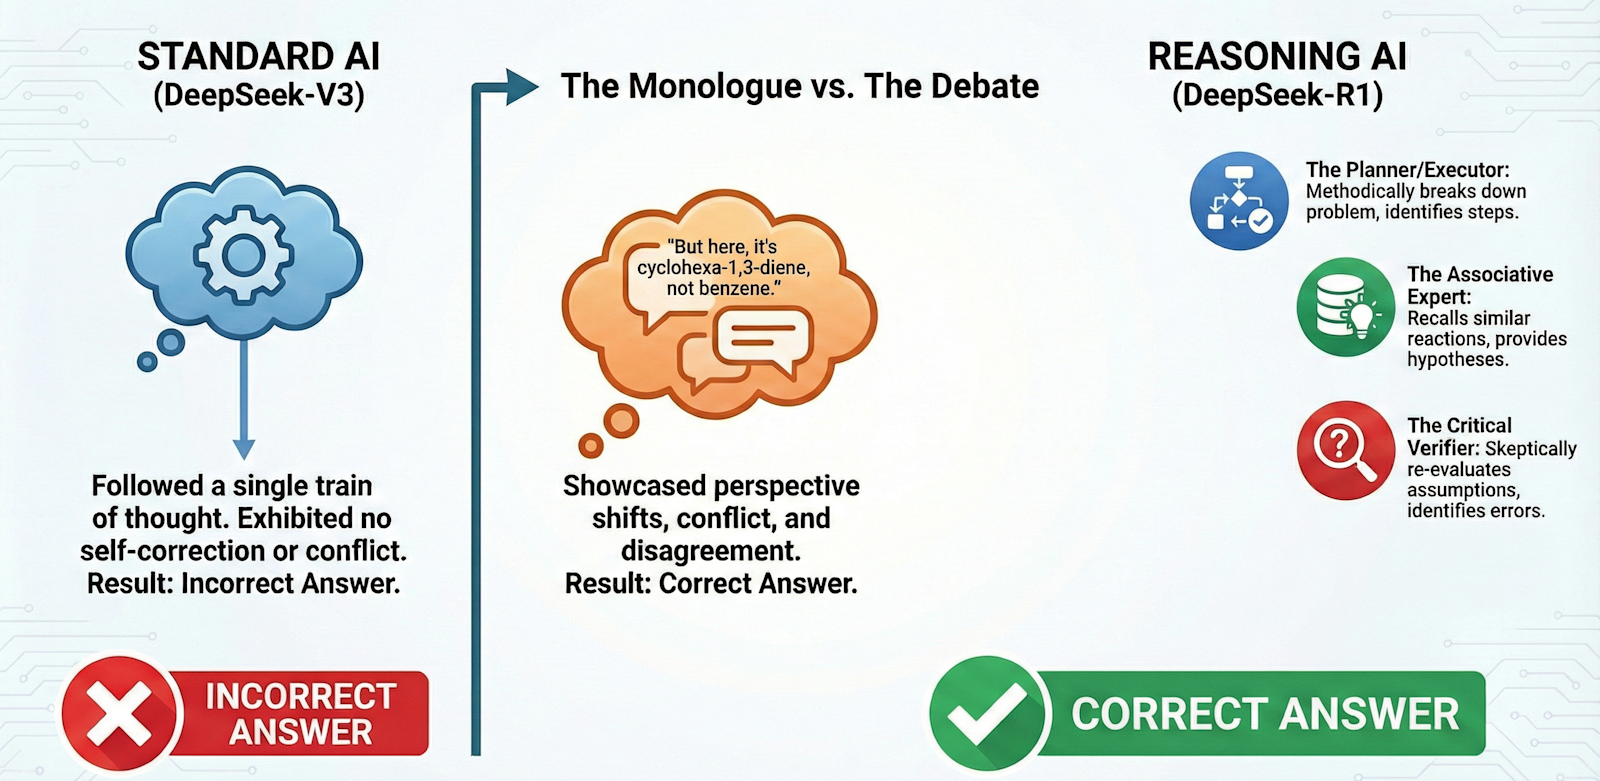


Новое исследование Google показывает, что передовые модели рассуждения достигают высокой производительности за счет симуляции дискуссий, напоминающих взаимодействие нескольких агентов, с привлечением различных точек зрения, черт характера и предметной экспертизы.
Их эксперименты демонстрируют, что этот внутренний спор, который исследователи называют «обществом мыслей» (society of thought), значительно улучшает производительность моделей в сложных задачах на рассуждение и планирование. Исследователи выяснили, что ведущие модели рассуждения, такие как DeepSeek-R1 и QwQ-32B, которые обучены с помощью обучения с подкреплением (RL), естественным образом развивают эту способность вести диалоги в формате «общества мыслей» без каких-либо явных инструкций.
Эти выводы предлагают разработчикам дорожную карту для создания более надежных приложений на базе языковых моделей (LLM), а предприятиям — для обучения превосходных моделей с использованием собственных внутренних данных.
Что такое «общество мыслей»?
Основная предпосылка концепции «общества мыслей» заключается в том, что модели рассуждения учатся имитировать социальные многоагентные диалоги для уточнения своей логики. Эта гипотеза опирается на когнитивную науку, в частности на идею о том, что человеческий разум эволюционировал прежде всего как социальный процесс для решения проблем посредством аргументации и взаимодействия с различными точками зрения.
Исследователи пишут, что «когнитивное разнообразие, проистекающее из различий в экспертизе и чертах характера, улучшает решение проблем, особенно когда оно сопровождается подлинным несогласием». Следовательно, они предполагают, что интеграция различных перспектив позволяет LLM вырабатывать надежные стратегии рассуждения. Симулируя разговоры между различными внутренними персонами, модели могут выполнять важные проверки (такие как верификация и откат назад), которые помогают избежать распространенных ловушек, вроде нежелательных предвзятостей и угодничества (sycophancy).
В таких моделях, как DeepSeek-R1, это «общество» проявляется непосредственно в цепочке рассуждений (chain of thought). Исследователи отмечают, что для принудительного вызова этого взаимодействия не требуются отдельные модели или промпты — дебаты возникают автономно в процессе рассуждения единого экземпляра модели.
Примеры «общества мыслей»
Исследование приводит наглядные примеры того, как это внутреннее трение приводит к лучшим результатам. В одном из экспериментов, связанных со сложной задачей органического синтеза, DeepSeek-R1 смоделировала дебаты между несколькими четко разграниченными внутренними точками зрения, включая «Планировщика» и «Критического верификатора».
Планировщик первоначально предложил стандартный путь реакции. Однако Критический верификатор (охарактеризованный высокой добросовестностью и низкой уступчивостью) вмешался, чтобы оспорить это предположение, и предоставил контраргумент с новыми фактами. Посредством такой состязательной проверки модель обнаружила ошибку, примирила противоречащие друг другу точки зрения и скорректировала путь синтеза.
Источник изображения: VentureBeat совместно с NotebookLM
Похожая динамика наблюдалась и в творческих задачах. Когда модель попросили перефразировать предложение «Я швырнул свою ненависть в горящий огонь», она смоделировала переговоры между «Творческим генератором идей» и «Проверяющим семантическую точность». После того как генератор идей предложил вариант со словом «укоренившийся» (deep-seated), проверяющий возразил: «Но это добавляет слово „укоренившийся“, которого не было в оригинале. Мы должны избегать добавления новых идей». В конце концов модель остановилась на компромиссе, который сохранял первоначальный смысл и улучшал стиль.
Пожалуй, самая поразительная эволюция произошла в «Игре в обратный отсчет» (Countdown Game) — математической головоломке, где модель должна использовать заданные числа для достижения целевого значения. На ранних этапах обучения модель пыталась решить задачу в режиме монолога. По мере обучения с помощью RL она спонтанно разделилась на две разные персоны: «Методичный решатель проблем», выполнявший вычисления, и «Исследовательский мыслитель», следивший за прогрессом, который прерывал зашедшие в тупик пути репликами вроде «Опять не повезло… Может, попробуем использовать отрицательные числа», побуждая Методичного решателя сменить стратегию.
Эти выводы ставят под сомнение предположение о том, что более длинные цепочки рассуждений автоматически приводят к более высокой точности. Вместо этого улучшения в рассуждениях стимулируют разнообразные модели поведения, такие как рассмотрение ответов через разные призмы, проверка ранних предположений, возврат к предыдущим шагам и поиск альтернатив. Исследователи подтвердили это, искусственно управляя пространством активаций модели для провоцирования разговорного удивления; это вмешательство активировало более широкий спектр признаков, связанных с личностью и экспертными знаниями, удвоив точность решения сложных задач.
Отсюда следует, что социальные рассуждения возникают автономно посредством RL как функция стремления модели выдавать правильные ответы, а не в результате детального контроля со стороны человека. Фактически, обучение моделей на монологах уступало по эффективности обычному RL, который естественным образом развивал многоагентные диалоги. И наоборот, проведение контролируемой донастройки (SFT) на многосторонних диалогах и дебатах значительно превосходило SFT на стандартных цепочках рассуждений.
Последствия для корпоративного ИИ
Для разработчиков и лиц, принимающих решения в бизнесе, эти идеи предлагают практические рекомендации по созданию более мощных ИИ-приложений.
Промпт-инжиниринг для «конфликта»
Разработчики могут улучшить способность к рассуждению у моделей общего назначения, явно запрашивая у них принятие структуры «общества мыслей». Однако недостаточно просто попросить модель пообщаться с самой собой.
«Недостаточно просто „устроить дебаты“, нужны разные точки зрения и предрасположенности, которые делают дебаты неизбежными и позволяют в ходе этих дебатов исследовать альтернативы и делать выбор между ними», — рассказал VentureBeat Джеймс Эванс (James Evans), соавтор научной работы.
Вместо общих ролей разработчикам следует проектировать промпты, задающие противоположные позиции (например, склонный к риску специалист по комплаенсу против сфокусированного на росте менеджера по продукту), чтобы заставить модель выбирать между альтернативами. Даже простые подсказки, направляющие модель на выражение «удивления», могут запустить эти превосходные пути рассуждения.
Проектирование с учетом социального масштабирования
Поскольку разработчики масштабируют вычислительные мощности на этапе тестирования (test-time compute), чтобы позволить моделям «думать» дольше, им следует структурировать это время как социальный процесс. Приложения должны способствовать «общественному» процессу, в рамках которого модель использует местоимения вроде «мы», задает себе вопросы и явно обсуждает альтернативы перед вынесением окончательного ответа.
Этот подход также может быть расширен на многоагентные системы, где различные личности, назначенные разным агентам, вступают в критические дебаты для достижения лучших решений.
Прекратите санировать свои обучающие данные
Пожалуй, самый важный вывод касается того, как компании обучают или донастраивают собственные модели. Традиционно дата-инженеры очищают свои датасеты для создания «эталонных ответов», которые обеспечивают идеальные линейные пути к решению. Исследование предполагает, что это может быть ошибкой.
Модели, донастроенные на разговорных данных (например, стенограммах многоагентных дебатов и поиска решений), совершенствуют свои рассуждения значительно быстрее, чем те, что обучались на чистых монологах. Определенную ценность представляют даже те дебаты, которые не привели к правильному ответу.
«Мы обучали модель на разговорных лесах (conversational scaffolding), ведущих к неправильному ответу, затем подкрепляли модель (reinforce) и обнаружили, что она работает так же хорошо, как и при подкреплении на правильном ответе. Это говорит о том, что разговорные привычки поиска решений оказались наиболее важны для новых проблем», — отметил Эванс.
Это означает, что предприятиям следует прекратить выбрасывать «грязные» инженерные логи или ветки в Slack, где проблемы решались итеративно. Именно в этой «неаккуратности» модель и учится привычке исследовать.
Раскрытие «черного ящика» для доверия и аудита
Для критически важных корпоративных сценариев применения простого получения ответа недостаточно. Эванс утверждает, что пользователям необходимо видеть внутренние разногласия, чтобы доверять результату, что предполагает сдвиг в дизайне пользовательских интерфейсов.
«Нам нужен новый интерфейс, который систематически демонстрирует нам внутренние дебаты, чтобы мы „участвовали“ в калибровке правильного ответа, — говорит Эванс. — У нас лучше получается с дебатами; у ИИ лучше получается с дебатами; и у нас лучше получается, когда мы видим дебаты ИИ».
Стратегические аргументы в пользу открытых весов
Эти выводы предоставляют новый аргумент в споре «создавать или покупать» в отношении моделей с открытыми весами (open-weight) против проприетарных API. Многие проприетарные модели рассуждений скрывают свою цепочку мыслей, рассматривая внутренние дебаты как коммерческую тайну или угрозу безопасности.
Но Эванс утверждает, что «раньше никто по-настоящему не обосновывал необходимость демонстрации этого общества мыслей», однако ценность аудита подобных внутренних конфликтов становится неоспоримой. До тех пор пока проприетарные провайдеры не обеспечат полную прозрачность, компании в секторах с высокими требованиями к комплаенсу могут обнаружить, что модели с открытыми весами предлагают явное преимущество: возможность видеть несогласие, а не только готовое решение.
«Я считаю, что крупные проприетарные модели начнут предоставлять (и лицензировать) эту информацию, как только осознают ее ценность», — уверен Эванс.
Исследование показывает, что задачи ИИ-архитектора смещаются от чистого обучения моделей к чему-то более близкому к организационной психологии.
«Я считаю, что это открывает совершенно новый рубеж проектирования малых групп и организаций внутри и между моделями, который, вероятнее всего, обеспечит новый класс производительности, — говорит Эванс. — Моя команда работает над этим, и я надеюсь, что другие тоже».




