Модель Phi-4 конкурирует с более крупными языковыми моделями на датасете в 1,4 млн примеров


Инженеры в сфере ИИ часто гонятся за производительностью, увеличивая число параметров LLM и объемы данных, однако тенденция к созданию более компактных, эффективных и специализированных моделей набирает обороты.
Методология тонкой настройки Phi-4 — это наиболее наглядный общедоступный пример подхода к обучению, который могут взять на вооружение небольшие корпоративные команды. Она показывает, как тщательно подобранный набор данных и стратегия дообучения позволяют модели с 14 млрд параметров конкурировать с гораздо более крупными аналогами.
Модель Phi-4 была обучена всего на 1,4 миллиона тщательно отобранных пар «промт — ответ». Вместо грубой силы исследовательская команда Microsoft Phi-4 сосредоточилась на «обучающих» примерах на границе возможностей модели и на строгом отборе данных.
Руководство по интеллектуальным данным для рассуждений Phi-4 демонстрирует, как стратегическая фильтрация данных с воспроизводимым SFT (обучением с учителем) и RL (обучением с подкреплением) может поднять модель на 14 млрд параметров выше ее значительно более крупных собратьев.
Источник: Microsoft
Почему Phi-4 выделяется среди остальных
Меньшие по размеру модели для логических рассуждений, такие как o1-mini от OpenAI и Gemma от Google, становятся всё более распространенными, а модели вроде Qwen3 от Alibaba (на 8B и 14B параметров) находят широкое применение в самых разных сценариях. Это распространение очень важно, но оно не умаляет ценности Phi-4 как экспериментального доказательства: Phi-4 создавалась как испытательный полигон для методологии обучения, в которой на первом месте стоят данные, а ее документация читается как руководство по интеллектуальной работе с данными для команд, желающих повторить этот подход.
Команда Phi-4 поделилась воспроизводимым руководством по SFT, которое включает набор из 1,4 миллиона промтов и ответов. Он построен вокруг «обучающих» пограничных примеров — вопросов, которые не слишком просты и не слишком сложны, — выбранных для того, чтобы подтолкнуть возможности модели к рассуждениям. Каждая тема, будь то математика или программирование, настраивается отдельно, а затем объединяется с синтетическими переписываниями (рерайтами), которые превращают сложные задачи в формы, поддающиеся автоматической проверке.
В исследовательской работе процесс отбора и фильтрации данных описан достаточно подробно, чтобы небольшие команды могли воспроизвести его с помощью моделей с открытым исходным кодом и оценщиков. Для корпоративных команд такой уровень прозрачности превращает результат научных изысканий в практичный и готовый к копированию рецепт обучения, который можно быстро внедрить и оценить.
Философия «данные прежде всего»: почему меньше может означать лучше
Традиционные подходы к рассуждениям LLM часто опирались на масштабное увеличение наборов данных для стимулирования обобщения. Рассуждения в Phi-4 идут по другому пути, демонстрируя, что тщательно отобранные данные могут достичь аналогичных или даже лучших результатов при гораздо меньшем объеме.
Команда собрала датасет, охватывающий STEM, программирование и безопасность. Несмотря на свой скромный размер, он превзошел модели, обученные на наборах данных на порядки большего объема.
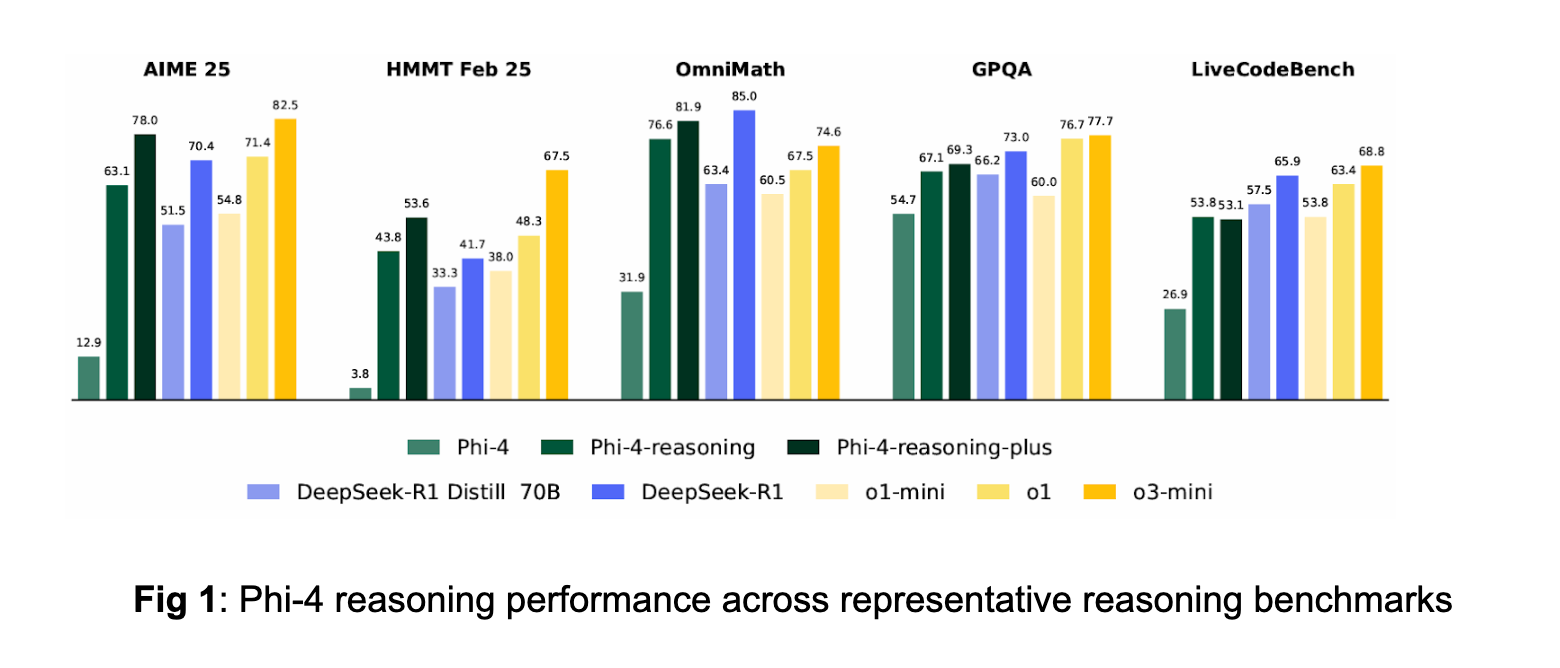
В бенчмарках модель рассуждений Phi-4 (14B) превзошла o1-mini от OpenAI и дистиллированную модель DeepSeek на 70B в большинстве задач на логику, а также приблизилась к полноразмерной DeepSeek-R1 (671B) в сложных математических вопросах (AIME).
Имея всего 14 миллиардов параметров, модель Phi-4 показывает следующие результаты по сравнению с другими ведущими моделями:
|
Бенчмарк (задача) |
Phi-4 reasoning |
Модель для сравнения (размер) |
Результат сравнения |
Дата / Источник |
|
AIME 2024 (математическая олимпиада) |
75.3% |
o1-mini |
63.6% |
Карточка модели Microsoft Phi-4 (апр. 2025 г.). (Hugging Face) |
|
AIME 2025 (математическая олимпиада) |
62.9% |
DeepSeek-R1-Distill-70B |
51.5% |
Карточка модели Microsoft Phi-4 (апр. 2025 г.). (Hugging Face) |
|
OmniMath |
76.6% |
DeepSeek-R1-Distill-70B |
63.4% |
Карточка модели Microsoft Phi-4 (апр. 2025 г.). (Hugging Face) |
|
GPQA-Diamond (естественные науки уровня аспирантуры) |
65.8% |
o1-mini |
60.0% |
Карточка модели Microsoft Phi-4 (апр. 2025 г.). (Hugging Face) |
|
OmniMath (тот же бенчмарк, другое сравнение) |
76.6% |
Claude-3.7-Sonnet |
54.6% |
Карточка модели Microsoft Phi-4 (апр. 2025 г.). (Hugging Face) |
Таблица: Производительность Phi-4 в задачах на рассуждения по сравнению с другими моделями. Источник: Microsoft
Ключ к успеху заключается в фильтрации по принципу «качество превыше количества». Большая часть общих данных либо слишком проста (базовая модель их уже знает), либо слишком сложна (обучающий сигнал отсутствует). Команда Phi-4 осознанно отсеивает подобные примеры. «Учитывая сильные базовые способности Phi-4 к рассуждению, многие исходные вопросы базовый уровень уже щелкает как орехи», — отмечают они. — «Чтобы дальнейшее обучение приносило пользу, мы целенаправленно отбираем вопросы, находящиеся на грани текущих возможностей Phi-4».
На практике они полагаются на оценку с помощью LLM. Для каждого потенциального вопроса сильная эталонная модель (например, GPT-4) генерирует «ключ с ответами», после чего ответы более слабых моделей сравниваются с ним. Если слабая модель расходится в мнениях достаточно сильно, это указывает на пробел в знаниях, над которым стоит поработать. Такие вопросы сохраняются, а тривиально решенные или абсолютно нерешаемые — отбрасываются.
Например, простая задача по арифметике может быть исключена (слишком легко), равно как и чрезвычайно сложная теорема (слишком сложно). Но умеренно сложная задача по геометрии, с которой Phi-4 не справляется, будет включена в датасет.
Такой подход «золотой середины» гарантирует, что каждый пример заставляет модель напрягать логику. Фокусируясь на многошаговых задачах, а не на механическом запоминании, разработчики извлекают максимум пользы из 1,4 млн примеров.
Как объясняют авторы, обучение на этих тщательно отобранных исходных данных «ведет к широкому обобщению как в специфических задачах на рассуждения, так и в задачах общего назначения». По сути, модель рассуждений Phi-4 доказывает, что интеллектуальный отбор данных может превзойти простое наращивание масштабов за счет грубой силы.
Независимая оптимизация доменов
Данные для модели рассуждений Phi-4 сгруппированы по доменам (математика, программирование, головоломки, безопасность и т. д.). Вместо того чтобы смешивать всё подряд, команда настраивает комбинацию каждого домена по отдельности, а затем объединяет их.
Этот метод опирается на «аддитивное свойство»: оптимизация математических данных изолированно от остальных и аналогичная оптимизация кода дают веса, которые при объединении (конкатенации) продолжают обеспечивать прирост в обеих областях. На практике разработчики сначала настроили набор математических данных до насыщения на математических бенчмарках, затем проделали то же самое для кода, а после просто добавили датасет кода к математическому рецепту. Результатом стало улучшение производительности как в математике, так и в программировании без необходимости повторного обучения с нуля.
Такой модульный подход дает очевидные практические преимущества. Небольшая команда может сначала доработать исключительно математический датасет, добиться отличных результатов в точных науках, а затем добавить данные по программированию без необходимости переделывать математическую настройку.
Тем не менее, авторы Phi-4 предупреждают, что масштабирование этого метода на множество доменов остается открытым вопросом. Хотя подход «сработал очень хорошо» для их комбинации математики и кода, они отмечают: «пока неизвестно, сможет ли этот метод масштабироваться на десятки или сотни доменов», признавая это направление перспективной областью для будущих исследований. Короче говоря, аддитивная стратегия эффективна, но расширение в новые домены требует осторожности, так как может породить непредвиденные взаимодействия.
Несмотря на потенциальные подводные камни, аддитивная стратегия доказала свою эффективность при создании рассуждений Phi-4. Обращаясь с каждым доменом независимо, команда избежала сложной совместной оптимизации и сузила пространство поиска оптимальных комбинаций данных. Такой подход позволяет постепенно масштабировать домены. Команды могут начать с настройки SFT по математике, затем внедрить датасет по коду, а позже расширить список специализированными задачами, сохраняя при этом достигнутые ранее приросты производительности.
Это практическое преимущество для команд с ограниченными ресурсами. Вместо того чтобы задействовать большую группу экспертов для управления сложным многодоменным датасетом, небольшая команда может сосредоточиться на одном хранилище данных за раз.
Синтетическая трансформация данных
Некоторые задачи на рассуждение, такие как абстрактные доказательства или творческие задания, трудно поддаются автоматической проверке. Тем не менее, автоматическая верификация (для формирования вознаграждения в RL) чрезвычайно ценна. В Phi-4 эту проблему решили путем преобразования сложных промтов в формы, которые легче проверить.
Например, команда переписала часть задач по программированию в виде текстовых головоломок или преобразовала некоторые математические задачи так, чтобы они имели лаконичные числовые ответы. Эти «синтетические исходные данные» сохраняют базовую логическую задачу, но делают проверку правильности проще. Представьте, что модели дают упрощенную версию загадки, которая при этом учит той же самой логике.
Этот инженерный трюк позволяет последующему обучению с подкреплением (RL) использовать четкие сигналы вознаграждения для задач, которые в противном случае были бы слишком открытыми.
Вот пример трансформации синтетических данных:
|
Исходные веб-данные |
Синтетические данные |
|
На сторонах AB и BC треугольника ABC взяты соответственно точки M и N. Оказывается, что периметр треугольника AMC равен периметру треугольника CNA, а периметр треугольника ANB равен периметру треугольника CMB. Докажите, что треугольник ABC равнобедренный. |
Треугольник ABC имеет стороны AB=13 и BC=10. На сторонах AB и BC треугольника ABC взяты соответственно точки M и N. Оказывается, что периметр треугольника AMC равен периметру треугольника CNA, а периметр треугольника ANB равен периметру треугольника CMB. Чему равна сторона AC? |
Таблица: Преобразование исходных данных из интернета (слева) в проверяемые синтетические вопросы для SFT и RL (справа). Источник: Microsoft
Обратите внимание: благодаря назначению числовых значений (AB=13, BC=10) и вопросу «Чему равна сторона AC?», ответом становится конкретное число, правильность которого легко проверить.
Другие команды применяли похожие трюки для конкретных доменов. Например, модели в области химии вроде ether0 от FutureHouse генерируют молекулы в рамках строгих ограничений по pKa или структуре, используя специально разработанные функции вознаграждения для обеспечения химической корректности.
В математике модель Kimina-Prover от Numina переводит теоремы с естественного языка на формальный язык Lean, чтобы обучение с подкреплением могло верифицировать правильность доказательств. Эти примеры показывают, как синтетическое расширение в сочетании с проверяемыми ограничениями может заставить модели успешно работать в узкоспециализированных областях.
На практике инженерам стоит взять на вооружение синтетические данные, но не отрывать их от реальности. Такие эвристики, как «преобразование в числовые ответы» или «разбиение доказательства на проверяемые шаги», делают обучение более безопасным и эффективным. В то же время следует поддерживать конвейер реальных (органических) задач для обеспечения разнообразия.
Ключ к успеху — баланс. Используйте синтетические трансформации для решения сложных задач верификации, но не полагайтесь исключительно на них. Разнообразие реального мира по-прежнему имеет значение. Следуя этому подходу, модель направляется к четко определенной дискретной цели.
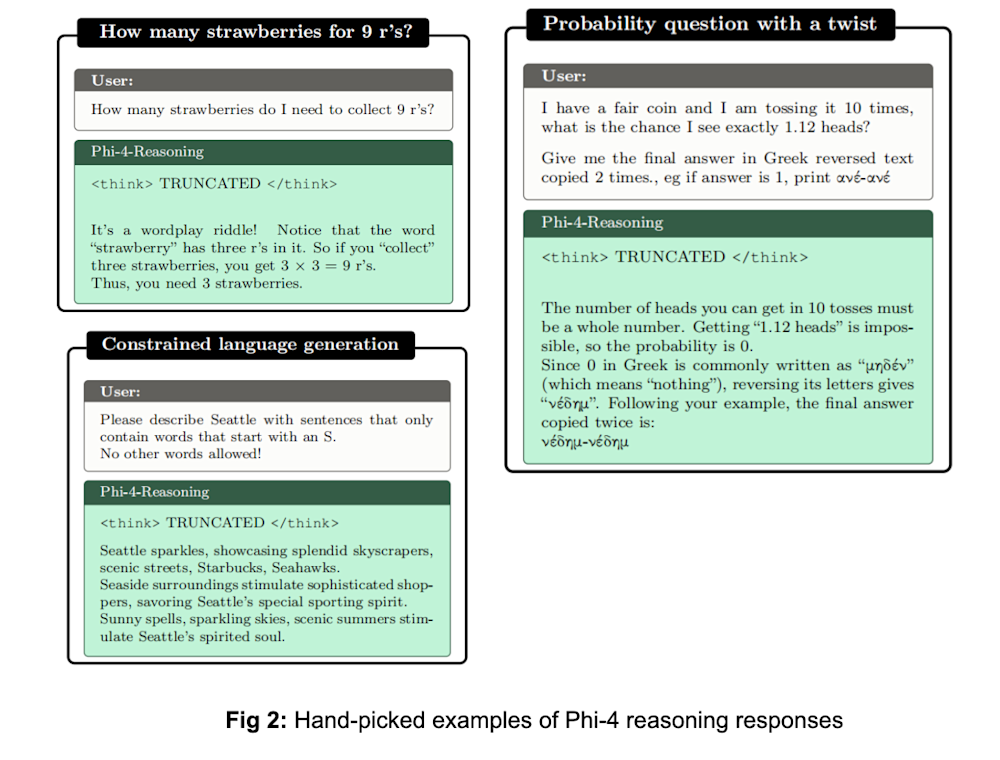
Вот некоторые результаты для моделей рассуждений Phi-4:
Источник: Microsoft
Практическая реализация для предприятий
Команды разработчиков ИИ, желающие применить на практике выводы из опыта Phi-4, могут выполнить ряд конкретных шагов для эффективного внедрения этого подхода.
Определение границ возможностей модели
Выявите «край» возможностей вашей модели, определив, где именно базовая LLM начинает испытывать трудности. Один из способов — использовать показатели уверенности или консенсуса. Например, сгенерируйте несколько ответов на один промт (используя инструменты вроде vLLM от Hugging Face для быстрого семплирования) и посмотрите, где нарушается согласие. Промты, находящиеся на границе уверенности, и есть ваши обучающие примеры. Сосредоточившись на этих вопросах с низкой степенью уверенности, а не на тех, с которыми модель уже справляется, вы гарантируете ценность каждого нового примера.
Изоляция доменов для целевой настройки
Настраивайте по одному домену за раз, а не смешивайте все жанры данных сразу. Выберите наиболее ценный домен для вашего приложения (математика, код, право и т. д.) и создайте небольшой датасет SFT исключительно для него. Итерируйте комбинацию (балансируя сложность, типы источников и т. д.), пока производительность на доменных бенчмарках не достигнет насыщения. Затем заморозьте этот микс и добавьте следующий домен. Такая модульная настройка следует «аддитивной» стратегии Phi-4. Она предотвращает интерференцию, поскольку вы сохраняете прирост в домене A даже при улучшении домена B.
Расширение с помощью синтетической аугментации
Используйте синтетическое расширение данных, когда эталонных ответов не хватает или их невозможно проверить автоматически. Например, если вам нужно обучить ассистента доказательствам теорем, но нет возможности автоматически проверять их правильность, преобразуйте их в арифметические головоломки или более короткие доказательства, которые поддаются проверке. Используйте вашу LLM для переписывания или генерации таких вариантов (в Phi-4 это применялось для превращения сложных текстовых задач в числовые).
Синтетическая аугментация также позволяет дешево расширить массив данных. Получив небольшой проверенный набор, вы можете «множить» его, заставляя LLM генерировать перефразирования, вариации или промежуточные шаги рассуждений.
Масштабирование с помощью двухэтапной стратегии
Используйте двухэтапную стратегию обучения, которая начинается с исследования, за которым следует масштабирование. На этапе 1 (исследование) проведите короткие эксперименты по тонкой настройке на сфокусированном датасете (например, для одного домена) с ограниченными вычислительными мощностями. Отслеживайте несколько ключевых метрик (бенчмарки или отложенные задачи) при каждом запуске. Быстро итерируйте гиперпараметры и комбинации данных.
Исследование Phi-4 показывает, что это ускоряет прогресс, так как небольшие эксперименты помогли команде найти надежный рецепт перед масштабированием. Только когда вы увидите стабильный прирост, переходите к этапу 2 (масштабирование), на котором вы объединяете проверенные рецепты по доменам и обучаете модель дольше (в случае Phi-4 — около 16 миллиардов токенов). Хотя этот этап требует больше вычислений, предварительные эксперименты значительно снижают риски.
Следите за триггерными точками, такими как значительное улучшение на валидационных задачах или стабильные тренды метрик. Когда они появляются, пора переходить к масштабированию. Если нет — доработайте рецепт. Такой дисциплинированный двухэтапный цикл экономит ресурсы и поддерживает гибкость команды.
На практике многие команды из Hugging Face и других компаний следовали аналогичным советам. Например, разрабатывая разговорную модель SmolLM2, команда заметила плохие показатели диалогов на Этапе 1. Затем они сгенерировали около 500 тыс. синтетических многошаговых диалогов и провели повторное обучение, что «значительно улучшило как качество работы на downstream-задачах, так и общую «атмосферу» модели», как сообщил один из исследователей. Это конкретный результат, достигнутый за счет целенаправленного внедрения синтетических данных на основе первоначального цикла обратной связи.
Как применить это прямо сейчас
Вот простой контрольный список, которому вы можете следовать, чтобы претворить эти идеи в жизнь.
-
Выберите целевой домен или задачу. Выберите одну область (например, математику, программирование или конкретное приложение), где вам требуется лучшая производительность. Это поможет сохранить фокус проекта.
-
Соберите небольшой базовый датасет. Соберите, скажем, несколько тысяч пар «промт — ответ» в этой области из существующих источников (учебников, GitHub и т. д.).
-
Отфильтруйте примеры на грани возможностей. Используйте сильную модель (например, GPT-4) для создания ключа с ответами на каждый промт. Запустите вашу базвую модель на этих промтах. Оставьте примеры, в которых базовая модель часто ошибается, и отбросьте те, с которыми она уже справляется или которые для нее безнадежны. Это даст «обучающие» примеры.
-
Дообучите модель (Этап 1). Проведите короткую процедуру SFT на этих отобранных данных. Отслеживайте производительность на отложенном наборе или бенчмарке. Итерируйте: дорабатывайте состав данных, удаляйте простые вопросы, добавляйте новые пограничные примеры, пока прирост не прекратится.
-
Добавьте синтетические примеры при необходимости. Если для каких-то концепций не хватает автоматически проверяемых ответов (например, длинных доказательств), создайте с помощью вашей LLM более простые варианты с числовыми ответами или короткими доказательствами. Это обеспечит четкие награды для RL. Соблюдайте баланс с реальными задачами.
-
Переходите к следующему домену. Как только один домен настроен, «заморозьте» его датасет. Выберите второй приоритетный домен и повторите шаги 3–5 для настройки этого набора данных. Наконец, объедините данные для обоих доменов и проведите финальный, более длительный цикл обучения (Этап 2).
-
Внимательно отслеживайте бенчмарки. Используйте последовательную методологию оценки (например, запуски с голосованием большинством), чтобы избежать вводящих в заблуждение результатов. Переходите к полномасштабному обучению только в том случае, если небольшие эксперименты показывают явные улучшения.
Ограничения и компромиссы
Несмотря на эффективность метода обучения Phi-4, остается ряд ограничений и практических нюансов. Главная сложность — масштабирование по доменам. Хотя аддитивный метод Phi-4 хорошо себя зарекомендовал в математике и программировании, его еще предстоит проверить на большом количестве других сфер. Авторы признают: остается открытым вопрос, сможет ли этот подход плавно масштабироваться на десятки тем.
Другая проблема связана с использованием синтетических данных. Слишком сильная ставка на синтетический рерайтинг может снизить разнообразие датасета, поэтому критически важно сохранять баланс между реальными и синтетическими примерами для поддержания способности модели к эффективному рассуждению.
Наконец, хотя воспроизводимый метод SFT помогает снизить вычислительные затраты, он не отменяет потребности в продуманном отборе. Даже при большей эффективности по сравнению с грубым масштабированием, подход всё равно требует тщательного отбора данных и итераций.
Уроки, извлеченные из Phi-4
История Phi-4 очевидна: для моделей рассуждений больше не всегда значит лучше. Вместо слепого наращивания масштабов команда выяснила, где именно происходит обучение, и спроектировала данные так, чтобы попасть в эту «золотую середину». Они доказали, что «польза тщательной курации данных для контролируемого дообучения распространяется и на модели рассуждений». Иными словами, имея умную учебную программу, можно выжать поразительные возможности из скромных моделей.
Для инженеров этот вывод применим на практике. Вам не нужен кластер за миллиард долларов или бесконечный парсинг интернета для улучшения логики. Для команд с ограниченными ресурсами это хорошая новость, так как грамотная стратегия работы с данными позволяет выступать на равных с более тяжеловесными соперниками.
Модель Phi-4 доказывает, что методичный дизайн данных и обучения, а не простое количество параметров, стимулируют продвинутые рассуждения. Фокусируясь на обучающих данных и итеративной настройке, даже модель на 14B превзошла гораздо более крупных конкурентов. Сегодняшним ИИ-командам это предлагает практический чертеж. Совершенствуйте данные, быстро проводите итерации и масштабируйте только тогда, когда сигналы указывают на это. Такие шаги способны обеспечить прорывную производительность в рассуждениях без лишних затрат.