FriendliAI повышает эффективность использования графических процессоров с помощью InferenceSense
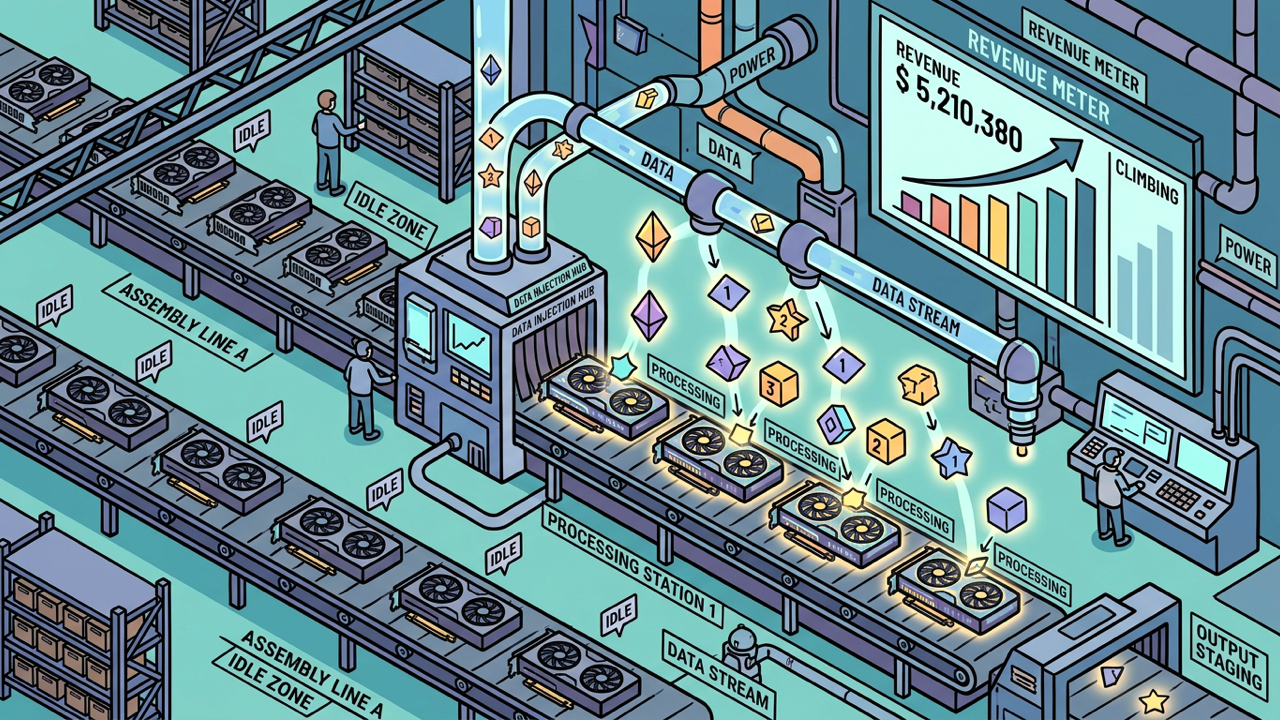


В любом кластере графических процессоров (GPU) есть периоды простоя. Задачи обучения завершаются, рабочие нагрузки смещаются, а железо простаивает без дела, в то время как затраты на электроэнергию и охлаждение продолжают капать. Для операторов неоклаудов эти пустые циклы означают упущенную маржу.
Очевидный способ обхода этой проблемы — рынки спотовых GPU, то есть сдача свободных мощностей в аренду тем, кому они нужны. Но спотовые инстансы означают, что арендодателем по-прежнему выступает сам облачный провайдер, а инженеры, покупающие эти мощности, продолжают платить за «сырые» вычисления без какого-либо инференс-стека.
Ответ от компании FriendliAI выглядит иначе: запускать инференс прямо на неиспользуемом оборудовании, оптимизировать его по пропускной способности токенов и делить выручку с оператором. Компания FriendliAI была основана Бён-Гон Чуном (Byung-Gon Chun), исследователем, чья научная работа по непрерывному батчингу (continuous batching) легла в основу vLLM — популярного открытого движка инференса, который сегодня используется в большинстве производственных развертываний.
Чун более десяти лет проработал профессором Сеульского национального университета, исследуя эффективное выполнение моделей машинного обучения в масштабе. Результатом этих исследований стала научная работа под названием Orca, в которой был представлен метод непрерывного батчинга. Этот метод обрабатывает запросы на инференс динамически, а не ожидает заполнения фиксированного батча перед запуском. Теперь это отраслевой стандарт и ключевой механизм внутри vLLM.
На этой неделе FriendliAI запускает новую платформу под названием InferenceSense. Подобно тому как издатели используют Google AdSense для монетизации непроданного рекламного инвентаря, операторы неоклаудов могут использовать InferenceSense, чтобы заполнять неиспользуемые циклы GPU платными задачами ИИ-инференса и получать долю от выручки за токены. Собственные задачи оператора всегда имеют приоритет — как только планировщик возвращает GPU в работу, InferenceSense уступает ресурс.
«Мы предоставляем возможность не позволять графическим процессорам простаивать, а монетизировать их за счет запуска инференса», — рассказал Чун изданию VentureBeat.
Как лаборатория Сеульского национального университета создала движок, лежащий в основе vLLM
Чун основал FriendliAI в 2021 году, еще до того, как большая часть индустрии переключила внимание с обучения на инференс. Основным продуктом компании является специализированный сервис эндпоинтов инференса для ИИ-стартапов и предприятий, работающих с моделями с открытыми весами. FriendliAI также представлена как опция развертывания на платформе Hugging Face наряду с Azure, AWS и GCP и в настоящее время поддерживает более 500 000 моделей с открытыми весами с этой платформы.
Теперь InferenceSense распространяет этот движок инференса на проблему дефицита ресурсов, с которой сталкиваются операторы GPU в перерывах между рабочими нагрузками.
Как это работает
InferenceSense работает поверх Kubernetes, которую большинство операторов неоклаудов уже используют для оркестрации ресурсов. Оператор выделяет пул GPU в кластер Kubernetes, управляемый FriendliAI, заявляя, какие узлы доступны и на каких условиях они могут быть востребованы обратно. Обнаружение простоя происходит средствами самой Kubernetes.
«У нас есть собственный оркестратор, который работает на графических процессорах этих неоклауд- или просто облачных провайдеров», — отметил Чун. «Мы определенно задействуем возможности Kubernetes, но ПО, запущенное поверх них, представляет собой высокооптимизированный инференс-стек».
Когда графические процессоры простаивают, InferenceSense запускает изолированные контейнеры, обслуживающие платные задачи инференса на моделях с открытыми весами, включая DeepSeek, Qwen, Kimi, GLM и MiniMax. Когда планировщику оператора требуется вернуть оборудование, задачи инференса прерываются, а GPU высвобождаются. По данным FriendliAI, передача ресурсов происходит за считанные секунды.
Спрос агрегируется через прямых клиентов FriendliAI и через такие агрегаторы инференса, как OpenRouter. Оператор предоставляет мощности; FriendliAI управляет конвейером спроса, оптимизацией моделей и стеком обслуживания. Никаких авансовых платежей и минимальных обязательств нет. Панель управления в реальном времени показывает операторам, какие модели запущены, сколько токенов обрабатывается и какая выручка получена.
Почему пропускная способность токенов лучше аренды «сырых» мощностей
Рынки спотовых GPU от таких провайдеров, как CoreWeave, Lambda Labs и RunPod, предполагают сдачу облачным вендором собственного оборудования в аренду третьим лицам. InferenceSense работает на оборудовании, которое уже принадлежит оператору неоклауда, причем оператор сам определяет, какие узлы участвуют в процессе, и заранее согласовывает с FriendliAI правила планирования. Это принципиальное различие: спотовые рынки монетизируют мощности, а InferenceSense монетизирует токены.
Пропускная способность токенов в расчете на один GPU-час определяет, сколько InferenceSense фактически может заработать в периоды простоя. В FriendliAI утверждают, что их движок обеспечивает в два-три раза большую пропускную способность по сравнению со стандартным развертыванием vLLM, хотя Чун отмечает, что этот показатель варьируется в зависимости от типа рабочей нагрузки.
Большинство конкурирующих стеков инференса созданы на базе открытых фреймворков на Python. Движок FriendliAI написан на C++ и использует кастомные ядра GPU вместо библиотеки Nvidia cuDNN. Компания создала собственный слой представления моделей для их разделения и выполнения на различном оборудовании, а также собственные реализации спекулятивного декодирования, квантования и управления KV-кешем.
Поскольку движок FriendliAI обрабатывает больше токенов за один GPU-час, чем стандартный стек vLLM, операторы должны получать больше выручки с каждого простаивающего цикла, чем могли бы при запуске собственного сервиса инференса.
На что следует обратить внимание ИИ-инженерам при оценке затрат на инференс
Для ИИ-инженеров, выбирающих место для запуска задач инференса, решение между неоклаудами и гиперскейлерами обычно сводилось к цене и доступности.
InferenceSense добавляет новый фактор: если неоклауды могут монетизировать простаивающие мощности за счет инференса, у них появляется больше экономических стимулов поддерживать конкурентные цены на токены.
Это еще не повод менять инфраструктурные решения прямо сегодня — рынок находится на ранней стадии. Однако инженерам, отслеживающим общую стоимость инференса, стоит понаблюдать за тем, приведет ли внедрение операторами неоклаудов таких платформ, как InferenceSense, к снижению цен на API для таких моделей, как DeepSeek и Qwen, в течение следующих 12 месяцев.
«Когда у нас появляется больше эффективных поставщиков, общая стоимость снижается, — резюмировал Чун. — С помощью InferenceSense мы можем внести свой вклад в удешевление этих моделей».