Сменить ИИ-модель проще сказать, чем сделать: большинству компаний на это требуются недели, выяснила VB Intelligence


Казалось бы, все должно быть просто. ИИ-модели постоянно обгоняют друг друга по уровню интеллекта, поэтому компании развернули шлюзы и маршрутизаторы, позволяющие инженерам переключаться между моделями, изменив всего одну строку кода, — и без труда переходить на ту модель, которая на сегодняшний день считается лучшей.
Оказывается, когда компании пытаются сделать это внутри приложения, от которого уже зависят клиенты или сотрудники, замена может занять недели или месяцы инженерной работы. Часто им приходится перерабатывать приложение или возвращаться к прежней модели. Новая лучшая модель появляется каждые несколько месяцев, поэтому компаниям, которые хотят не отставать, приходится снова и снова тратить на это недели.
VentureBeat задал вопросы о замене моделей в рамках октябрьского опроса специалистов, работающих с ИИ в компаниях численностью не менее 100 сотрудников. Мы спрашивали, заменяла ли компания респондента за последние 12 месяцев модель в рабочей ИИ-системе, сохранив при этом окружающее приложение. Утвердительно ответили 47% всех респондентов.
Из респондентов, чьи компании заменили модель, 70% сообщили, что замена потребовала нескольких недель или более инженерной работы помимо смены самой модели. Из тех же респондентов 36% сказали, что замена заняла больше месяца.
Лишь 13% респондентов, чьи компании заменили модель, заявили, что замена практически не потребовала усилий и была сродни изменению конфигурации.
Результаты замен оказались неоднозначными. Из респондентов, чьи компании заменили модель, 55% сказали, что новая модель работала не хуже старой или лучше. Остальные 45% дали один из двух ответов: производительность снизилась и компании пришлось перерабатывать окружающее приложение, либо компания вернулась к исходной модели. Доля в 45% статистически значимо не изменилась с сентября.
Чтобы понять, что делает замену сложной и как компании к ней готовятся, я опирался на недавние интервью VentureBeat и выступления на мероприятиях руководителей Uber, PayPal, Home Depot, T-Mobile, Box и других компаний.
Anthropic снизила цены в понедельник, а компании перенаправляют задачи на более дешевые модели
Снижение цен — одна из причин, по которым компании меняют модели, хотя в нашем опросе мы не спрашивали респондентов, почему их компании провели замену и была ли новая модель дешевле. В понедельник Anthropic выпустила Claude Fable 5.2 по цене 8 долларов за миллион входных токенов и 40 долларов за миллион выходных токенов, что на 20% ниже цены заменяемой версии, как сообщил исполнительный редактор VentureBeat Карл Франзен. Наш октябрьский опрос завершился до этого релиза.
Компании могут переносить задачи с моделей средней ценовой категории на более дешевые с помощью маршрутизаторов. Маршрутизатор — это программное обеспечение, которое направляет каждый запрос выбранной модели. Маршрутизация — одна из функций ИИ-шлюза, который располагается между приложениями компании и поставщиками моделей.
Маркетинговый агент Adobe использует более дешевую модель для выбора нужного контекста, а затем Adobe отправляет промпт более крупной модели, рассказала Анджул Бхамбхри, старший вице-президент Adobe по инженерным разработкам, на саммите VentureBeat Agentic Infrastructure Stack Summit в Сан-Франциско 28 октября.
Некоторые стартапы предлагают решения для маршрутизации моделей. У одного из них, Tetrate, есть режим Auto Mode, который выбирает модель для каждого запроса. Некоторым клиентам Tetrate уже все равно, какую модель они получают, сказал на саммите Варун Талвар, сооснователь и технический директор Tetrate. По его словам, такие клиенты говорят Tetrate «ставить любую строку, какую хотите» в настройке модели.
Но клиенту все же предстоит проделать работу, прежде чем доверять этому автоматическому выбору, отметил Талвар. По его словам, Tetrate пока «не до конца» понимает, какая модель подходит для какой задачи. Клиенты начинают с одной команды и делают Auto Mode режимом по умолчанию, только если ответы не хуже прежних, а расходы снизились, пояснил Талвар.
Итак, шлюз упрощает смену модели, но компании все равно нужно проверить, работает ли ее приложение с новой моделью так же хорошо.
Замена модели внутри приложения, от которого уже зависят клиенты или сотрудники, — это другая задача, и именно о ней мы спрашивали в опросе. Судханшу Бист, вице-президент по инженерной разработке платформенной инфраструктуры Upwork, онлайн-площадки для фрилансеров, провел на саммите ту же границу. В open-source-соревновании по программированию Бист, по его словам, лично позволил бы небольшой модели завершить задачу, начатую более крупной моделью. В рабочей системе он «скорее всего, остался бы на существующей модели». Выбор модели зависит от задачи, добавил Бист в электронном письме в среду. По его словам, Upwork направляет повторяющуюся, четко определенную работу, например подбор фрилансеров к заказам, небольшим дообученным моделям, а задачи открытого типа — более крупным моделям.
Рабочее приложение может зависеть от промптов, инструментов и тестов, которые инженеры подогнали под одну модель, и эти компоненты могут потребовать переработки при смене модели. В опросе мы не спрашивали респондентов, какие именно компоненты они переделывали и используют ли их компании шлюз.
Новая модель может вести себя иначе в программном обеспечении, созданном для старой
Некоторые компании прибегают к дообучению моделей, чтобы те лучше работали в их предметной области. Компания дополнительно обучает модель на собственных примерах, но это дообучение не переносится автоматически на модель-замену. PayPal приходилось менять модель в приложении «много раз», рассказала Жэнь Чжан, вице-президент и глобальный руководитель по ИИ-продуктам PayPal, на мероприятии VentureBeat 8 октября. Для торгового агента PayPal, который помогает покупателям изучать и приобретать товары, компания перешла на меньшую и более быструю модель и дообучила ее, что повысило точность, но недостаточно, сказала Чжан. По данным компании, PayPal проделала эту работу в ходе внутренних исследований и тестирования, еще до того, как агент стал доступен клиентам.
Позднее PayPal решила меньше заниматься дообучением, поскольку оно требует команды специалистов, и «когда выходит новая модель, приходится снова проводить дообучение уже на ней», пояснила Чжан. Теперь PayPal балансирует между дообучением, готовыми моделями и распределением вычислительных мощностей, чтобы добиться оптимального сочетания точности, скорости, стоимости и контроля, сообщила Чжан во вторник через представителя PayPal.
Новая модель может ухудшить работу приложения, потому что инженеры подгоняют свое ПО под модель, с которой начинали, объяснил Бен Кус, технический директор Box. Затем инженеры меняют модель, и «новая модель может просто вести себя иначе», сказал Кус 30 октября в интервью для подкаста VentureBeat Beyond the Pilot. Руководители часто полагают, что более новая модель означает лучшие результаты, но зачастую это не так, отметил Кус.
Компания, вероятно, увидит «наиболее резкие различия в результатах в зависимости от обвязки», сказал он. Обвязка (harness) — это код, который оборачивает модель, передает ей инструкции и определяет, какие инструменты она может вызывать. Выбор среди нынешних передовых моделей имеет меньшее значение, поскольку все они очень хороши, по его словам. Теперь Box тестирует обвязки и модели в сочетании, чтобы найти работающую пару, рассказал он.
Обвязка может влиять на стоимость задачи. Модель Kimi K3 от Moonshot AI успешно выполнила 63,3% задач как в Claude Code, так и в конфигурации DeepSeek Harness в бенчмарке FrontierHarness Eval от Runta. Но медианная стоимость одной успешно выполненной задачи составила 18,34 доллара в Claude Code и 3,28 доллара в этой конфигурации DeepSeek Harness — более чем в пять раз больше при том же результате, как показывает рейтинг бенчмарка.
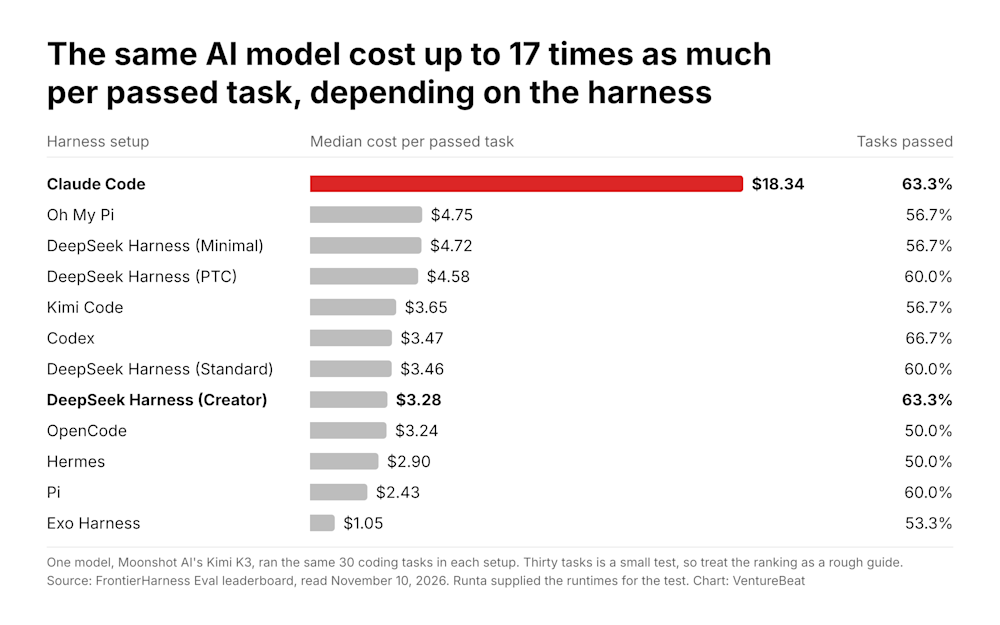
В FrontierHarness Eval модель Kimi K3 прогнали через девять обвязок для программирования в 12 конфигурациях на одних и тех же 30 задачах. Runta, компания, занимающаяся инфраструктурой для агентов и предоставившая среды выполнения для теста, объявила результаты в начале сентября. Тридцать задач — небольшой тест, поэтому рейтинг служит лишь приблизительным ориентиром, на что указывает мой соведущий подкаста Сэм Витвен в своем видеообзоре бенчмарка.
Наш совет компании, оценивающей новую модель, таков: тестируйте ее в той обвязке, в которой она действительно будет использоваться, а если результаты разочаруют, попробуйте другую обвязку, прежде чем отказываться от модели. Иначе компания может обвинить модель в проблеме, вызванной обвязкой.
Для крупнейших моделей обвязка «значила меньше, чем мы ожидали», согласно исследованиям Artificial Analysis, заявил Мика Хилл-Смит, сооснователь и генеральный директор этой компании, специализирующейся на бенчмарках, на саммите 28 октября. Небольшие же модели менее гибки, отметил Хилл-Смит. По его словам, результаты небольшой модели в тестах агентов для программирования могут «колебаться на 20, 30, 40 пунктов» в зависимости от того, обучалась ли модель на стиле конкретной обвязки.
Переход на меньшую модель — это способ радикально удешевить задачу, сказал Хилл-Смит, но за него приходится платить временем инженеров. «Мы вкладываем больше труда, чтобы иметь возможность использовать меньшую модель», — сказал он.
Если небольшие модели сильно реагируют на обвязку, то обвязка, созданная инженерами для крупной модели, может не подойти небольшой.
Модель, которая дешевле за токен, может обходиться дороже за хороший результат
Более дешевая модель после замены также может обойтись дороже, если она чаще ошибается.
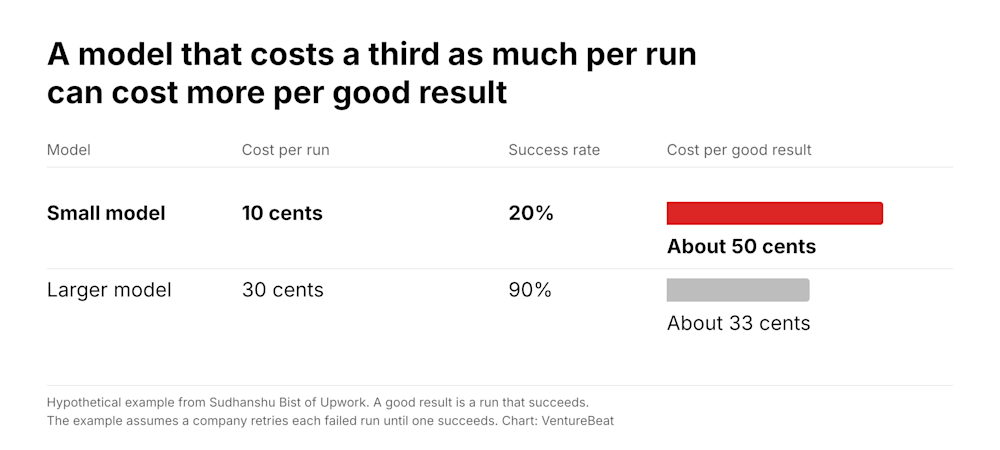
Небольшой модели, которая стоит 10 центов за запуск и справляется в 20% случаев, требуется в среднем пять запусков, поэтому хороший результат обходится примерно в 50 центов, — такой гипотетический пример привел Бист аудитории саммита. Более крупная модель, которая стоит 30 центов за запуск и справляется в 90% случаев, обходится примерно в 33 цента за хороший результат, пояснил Бист в письме в среду, уточнив свои цифры. Крупная модель стоит втрое дороже за запуск, но при этом дешевле за хороший результат. Пример предполагает, что компания повторяет каждый неудачный запуск до успешного, отметил Бист.
Шлюз моделей Upwork не учитывает полную стоимость хорошего результата, сказал Бист. Шлюз отслеживает расходы на вызовы моделей по командам. По его словам, шлюз не видит вычислений на GPU, используемых для обучения и дообучения моделей, времени, которое человек тратит на исправление результата агента, или процессорных затрат на вызовы инструментов агентом.
Некоторые компании начинают рассчитывать стоимость хорошего результата, а не сосредотачиваться только на стоимости токена, отметил Талвар из Tetrate. ИИ-индустрия «все еще застряла» на оплате за токены, хотя должна измерять стоимость результата, заявил на саммите Вэл Берковичи, директор по ИИ компании WEKA. WEKA была одним из спонсоров саммита.
Некоторые компании решают, что более дешевая модель — неверная цель для конкретной задачи. T-Mobile использует ведущие модели для своих агентов службы поддержки и платит за них премиальную цену, рассказал на саммите Джефф Саймон, директор по информационным технологиям T-Mobile. «В обслуживании клиентов мы на самом деле не стремимся оптимизировать затраты», — сказал Саймон. T-Mobile стремится давать клиентам быстрые и точные ответы.
Uber утверждает, что может сменить модель управляемого агента за пару дней
Если бы модель с открытыми весами давала наилучшую отдачу для ИИ-ревью кода в Uber, «мы переключимся за пару дней», заявил на саммите Удай Киран Медисетти, заслуженный инженер Uber. ИИ-ревью кода — один из управляемых агентов Uber, то есть агентов, которых Uber создает и централизованно эксплуатирует для одной задачи.
У Uber есть бенчмарк для ревью кода, поскольку компания может протестировать модель на любом изменении кода за прошлые годы, пояснил Медисетти. Позднее Uber создала бенчмарк для своего фонового агента-программиста на основе реальных сессий программирования — задача, по его словам, гораздо более сложная.
Uber использует данные бенчмарков для выбора модели для автоматической очистки кода, рассказал Медисетти. Эта задача удаляет устаревшие флаги функций. По его словам, благодаря бенчмаркам и выбору правильной модели Uber снизила стоимость одной очистки на 90%. Uber видит возможности сократить расходы в каждом управляемом агенте, добавил он.
Uber также отслеживает долю ИИ-запросов, которые можно перенести с одной модели на другую, сказал Медисетти. Управляемых агентов Uber может переводить с модели на модель; сессии, которые инженеры ведут вручную в таких инструментах, как Claude Code, перенести гораздо сложнее, поскольку это означает изменение того, как работают люди, пояснил он.
Что делают PayPal, клиенты Databricks, Box, T-Mobile и JPMorgan Chase перед заменой модели
PayPal хранит бизнес-знания вне модели. Внутренний ассистент PayPal по анализу данных опирается на слой знаний, содержащий бизнес-определения PayPal, утвержденные запросы и пошаговые сценарии анализа, рассказала Чжан. По данным PayPal, добавление этого слоя повысило точность ассистента при ответах на внутренние бизнес-вопросы с 43% до 95% при той же модели. PayPal создала этот слой отдельно от модели. «Он не зависит от модели, потому что я намеренно так сделала», — сказала Чжан. Когда выходит лучшая модель, «я просто подключаю ее и работаю. Я не должна менять свои знания». Компании, которая привязывает свои знания к одной модели, придется заново настраивать их под каждую новую модель, отметила она.
Клиенты Databricks превращают ответы передовой модели в тест. Клиенты Databricks следуют определенной последовательности, рассказал Брайан Кларк, директор по управлению продуктами Databricks. Сначала они создают первую версию на передовой модели с простым текстовым индексом — Кларк назвал это «умный агент, а не умный бэкенд». Ответы передовой модели клиенты сохраняют как оценочный набор. Затем переходят на более дешевую модель с открытыми весами, добавляют векторный поиск в помощь более дешевой модели и сверяют ее ответы с оценочным набором, пояснил Кларк на саммите.
Box оценивает каждое изменение по трем показателям: точности, стоимости и скорости, измеряемым на оценочном наборе, составленном из того, что клиенты просят делать агентов Box. «Неважно, как вы этого добились, важны только эти три числа», — сказал Кус. Сбор оценочных данных обычно и есть самое сложное, по его словам.
T-Mobile тестирует изменения на реальных звонках клиентов и затем отслеживает каждую сессию. Когда инженеры T-Mobile хотят изменить настройки агентов службы поддержки, компания запускает старую и новую версии одновременно и сравнивает их на реальных звонках клиентов, рассказал Саймон. T-Mobile масштабирует новую версию, только если она работает лучше. Кроме того, T-Mobile использует небольшую модель, которая отслеживает каждую сессию в чате и голосовом канале и помечает ответы, выглядящие ошибочными, сказал он. Тестирование перед запуском не может охватить все способы, которыми клиент задает вопрос, поэтому T-Mobile ищет необычные случаи, «которые вы никогда не увидите в лаборатории», пояснил Саймон.
JPMorgan Chase одобряет новые модели, прежде чем сотрудники получат к ним доступ. Еще один фактор, замедляющий смену моделей, — корпоративное управление. JPMorgan Chase, которая открывает доступ к Claude от Anthropic все большему числу сотрудников, требует, чтобы каждая новая модель Claude прошла собственную процедуру одобрения банка, прежде чем кто-либо в JPMorgan Chase сможет ее использовать, сообщила Anthropic в понедельник.
Что компании могут сделать перед следующей заменой модели
Трудоемкость замены — повод тщательно оценивать переход, а не отказываться от него вовсе. Представления об ИИ, верные три-четыре месяца назад, скорее всего, уже не соответствуют действительности, заявил Уильям Аллен, руководитель Snowflake по продуктам CoCo, ИИ-агенту для программирования, и CoWork, ИИ-ассистенту для работников интеллектуального труда, в беседе с VentureBeat 3 ноября. «Пожалуй, самое важное заблуждение, которое всем нам нужно понять и по-настоящему осознать, — это ошибка невозвратных затрат, когда ты говоришь: нет-нет-нет, я потратил столько времени на создание этой штуки, не хочу ее переделывать», — сказал Аллен.
Исходя из того, что рассказали эти спикеры, вывод таков: готовьтесь заранее, до замены.
-
Во-первых, создайте оценочный набор из реальных запросов и ответов, проверенных на точность, чтобы компания могла тестировать на нем новую модель.
-
Во-вторых, сравнивайте модели по стоимости хорошего результата с учетом неудачных попыток. Тестируйте каждую модель в той обвязке, в которой она будет работать, и, по возможности, хотя бы еще в одной.
-
В-третьих, храните бизнес-знания, такие как определения и правила, в слое, который контролирует компания, чтобы инженерам не приходилось воссоздавать его под каждую модель.
-
В-четвертых, сравнивайте старую и новую версии приложения на реальном трафике и продолжайте мониторинг после замены, поскольку тесты не охватывают всего, о чем спрашивают пользователи.
VentureBeat задаст те же вопросы о замене моделей в ноябрьском опросе и сообщит, по-прежнему ли 70% респондентов, чьи компании заменили модель, говорят, что замена заняла несколько недель или более.
О данных: VentureBeat Intelligence провела этот опрос VB Pulse об оркестрации агентов в октябре 2026 года. Респонденты отвечали применительно к организации численностью не менее 100 сотрудников, при этом 28% респондентов — консультанты, отвечавшие применительно к клиенту, у которого провели больше всего времени. На вопрос об объеме инженерной работы отвечали только респонденты, сообщившие о замене модели, и проценты по результатам замены относятся к той же группе, поэтому проценты для этой группы менее точны.
Для этого сравнения сентябрьские данные включают только респондентов, которые прошли бы октябрьский отбор. В сентябре 49% респондентов, чьи компании заменили модель, заявили, что замена заняла несколько недель или более, а 12% — что больше месяца. VentureBeat Intelligence расценивает оба октябрьских роста как ориентировочные, поскольку состав респондентов изменился. В октябре 35% респондентов сообщили, что используют ИИ-системы или отслеживают их с точки зрения бизнеса, — гораздо большая доля, чем в сентябре, и эти респонденты чаще других выбирали вариант «больше месяца». Без них 66% октябрьских респондентов, чьи компании заменили модель, заявили, что замена заняла несколько недель или более, а 29% — что больше месяца. Большинство октябрьских респондентов были привлечены через исследовательскую панель, и мы не можем сказать, в какой мере изменения по сравнению с сентябрем отражают состав отвечавших. Другие отчеты VB Pulse можно найти здесь.