Anthropic представила Claude Fable 5.2 и Mythos 5.2: рекордные результаты в бенчмарках и снижение стоимости API на 20%


Что может быть лучше новой передовой модели? Только две — и обе устанавливают новые рекорды в целом ряде независимых бенчмарков, а для компаний и разработчиков стоимость доступа через API снижена на 20%.
Именно это Anthropic и сделала сегодня: меньше часа назад быстрорастущий стартап в области генеративного ИИ представил Claude Fable 5.2 и Claude Mythos 5.2 — свои новейшие и самые мощные передовые языковые модели для общего применения и для задач кибербезопасности соответственно. И результаты по всем направлениям вновь впечатляют — возможно, даже способны изменить всю отрасль.
Обе модели теперь стоят 8 долларов за миллион некэшированных входных токенов и 40 долларов за миллион выходных токенов — против 10 и 50 долларов соответственно у их предшественниц из поколения 5.1.
|
Модель Claude API |
Стандартный вход / выход |
Чтение из кэша |
Запись в кэш, 5 мин / 1 ч |
Fast: вход / выход |
|---|---|---|---|---|
|
Fable 5.1 и Mythos 5.1 |
10 / 50 долларов |
0,25 доллара |
12,50 / 20 долларов |
Тариф не указан |
|
Fable 5.2 и Mythos 5.2 |
8 / 40 долларов |
0,20 доллара |
10 / 16 долларов |
16 / 80 долларов |
|
Opus 5.5 |
4 / 20 долларов |
0,20 доллара |
5 / 8 долларов |
8 / 40 долларов |
Fable уже доступна в платных тарифах Claude, в Claude Code и через Claude Platform (ID модели claude-fable-5-2), AWS, Google Cloud и Microsoft Azure.
Mythos построена на той же базовой модели, но с другими защитными механизмами, и предназначена для проверенных пользователей из сферы кибербезопасности и наук о жизни в рамках программы Project Glasswing от Anthropic .
Самая полезная цифра для корпоративных команд разработчиков — вероятно, 6,72 доллара. Именно столько в среднем стоило выполнение одной задачи в тесте FrontierCode 2.0 от Cognition с Fable 5.2 на уровне усилий High, согласно системной карте Anthropic для новых моделей.
Opus 5.5, которая берёт вдвое меньше за стандартные некэшированные входные и выходные токены, в среднем обошлась в 12,82 доллара на уровне Max при почти идентичном результате. Но компромисс может работать и в обратную сторону. Перевод Fable на максимальный уровень Max поднял среднюю стоимость до 44,70 доллара, а результат оказался ниже, чем на более дешёвом уровне Xhigh, говорится в системной карте Anthropic.
Это делает Fable интересным вариантом для задач, которые и так съедают время и деньги на повторные попытки, — например, миграции в незнакомой кодовой базе или ошибки, пережившей несколько раундов диагностики. Сама Anthropic рекомендует Opus 5.5 для большинства задач программирования и интеллектуальной работы. Fable может взять на себя задачу целиком или выступать в роли советника, к которому обращается более дешёвая модель, когда заходит в тупик. Каждая схема расходует разный объём времени Fable.
Как Fable и Mythos выглядят на фоне конкурентов
Менее чем через две недели после того, как Google представила Gemini 4 Carbon — свою новейшую передовую модель, — Anthropic опубликовала набор результатов, перетасовавший расклад сил.
Однако с точки зрения покупателя эти два релиза выглядят по-разному. Google анонсировала Carbon 28 октября и начала с предоставления доступа отдельным специалистам по киберзащите через программу Fairwind. По состоянию на 9 ноября Carbon по-прежнему доступна ограниченно.
Большинство разработчиков, которые хотят задействовать модель Gemini 4 уже сегодня, могут использовать Gemini 4 Argon. Anthropic открыла Fable 5.2 гораздо шире, оставив Mythos 5.2 для проверенных команд в сфере кибербезопасности и наук о жизни.
В сравнительных данных Anthropic к запуску одна из двух новых моделей Claude лидирует в 13 из 15 приведённых показателей, если считать два способа оценки теста интеллектуальной работы AA-Briefcase по отдельности.
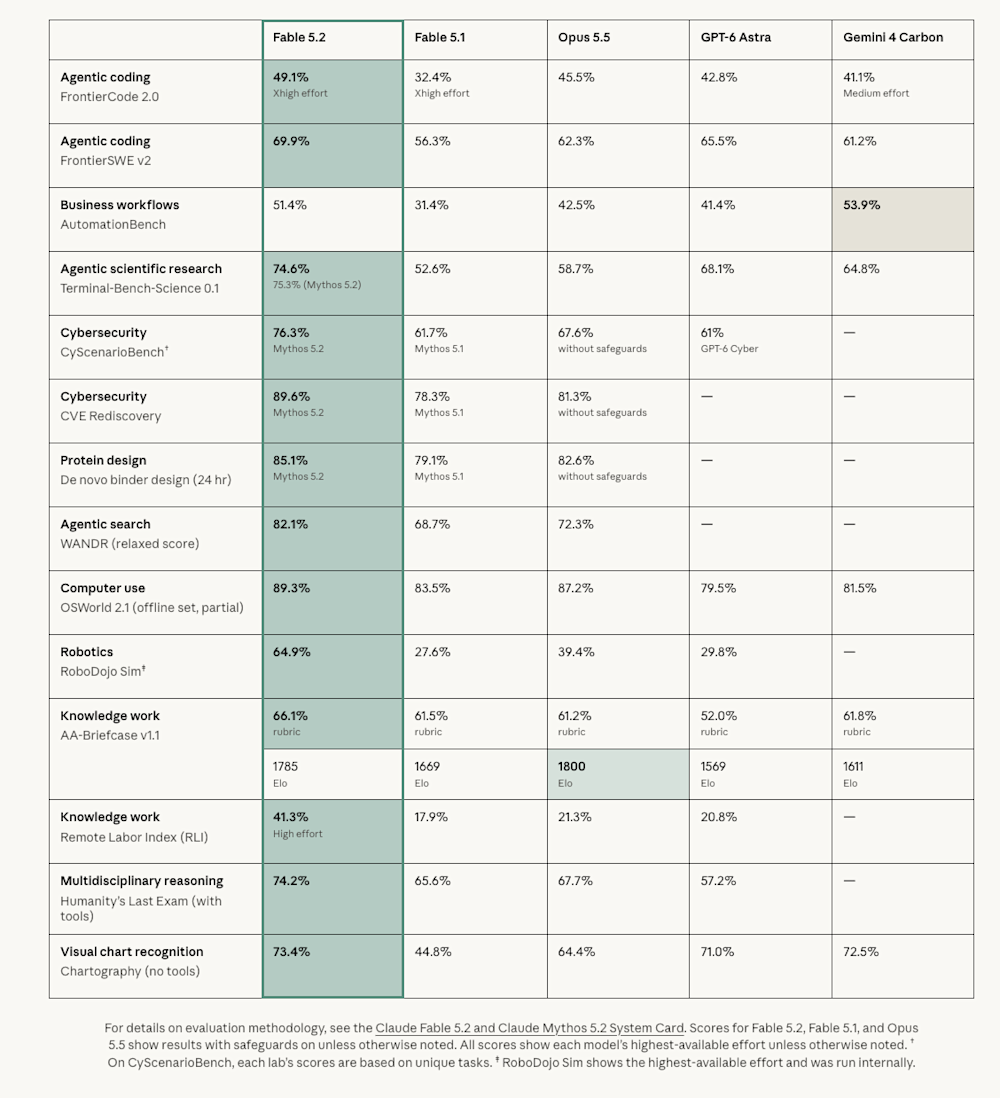
Сравнительная диаграмма бенчмарков Anthropic Claude Fable 5.2 и Mythos 5.2. Источник: Anthropic
Carbon выигрывает тест бизнес-автоматизации — 53,9% против 51,4% у Fable. Другая победа остаётся в семействе Claude: Opus 5.5 немного опережает Fable в рейтинге попарных сравнений AA-Briefcase — 1 800 против 1 785, хотя Fable чаще выполняет письменные требования теста.
Итоговый счёт показывает широту успехов Anthropic в выбранных ею тестах. Для Carbon в нескольких строках нет результатов, а Artificial Analysis присвоила Carbon 59 баллов в своём отдельном индексе Intelligence Index — более широком показателе, который отвечает на другой вопрос.
Преимущество Fable заметнее всего в программировании. В FrontierCode 2.0, где проверяется, достаточно ли хорош патч для слияния с реальным репозиторием с открытым кодом, Fable набирает 49,1%, опережая GPT-6 Astra (42,8%) и Carbon (41,1%). Fable работала на уровне усилий Xhigh, Carbon — на Medium.
Fable также опережает обеих в FrontierSWE v2: 69,9% против 65,5% у Astra и 61,2% у Carbon. Mythos лидирует в опубликованных результатах по кибербезопасности и дизайну белков, хотя в системной карте Anthropic отмечается, что лаборатории использовали разные задачи для CyScenarioBench, поэтому сравнение этого результата с GPT-6 Cyber менее строгое.
Первые пользователи описывают выгоды, которые сложнее уложить в таблицу. Инженер Vercel Джо Хаддад рассказал Anthropic, что проекты, которые его команда неделями продвигала с помощью других моделей, с Fable 5.2 были завершены и одобрены за несколько дней. Старший штатный инженер Datadog Мэтт Ли сравнил модель с руководителем по инцидентам, который может отправлять более быстрые модели собирать информацию, пока сам координирует работу.
Оба отзыва взяты из отзывов, отобранных Anthropic для запуска. Они указывают на две вещи, которые команды разработчиков могут измерить сами: сколько времени уходит на прохождение изменения через ревью и как часто человеку приходится вмешиваться, чтобы перенаправить агента.
По стандартным тарифам API Anthropic Fable и Mythos стоят по 8 долларов за миллион некэшированных входных токенов и 40 долларов за миллион выходных. Это на 20% ниже стандартных тарифов GPT-6 Astra для короткого контекста и вдвое выше стандартных тарифов Opus 5.5 и Muse Wonder от Meta.
Цена за одну задачу может рассказать другую историю. В FrontierCode 2.0 Fable на уровне High в среднем тратила 6,72 доллара на задачу — почти ровно столько же, сколько Astra на Max (6,68 доллара), и примерно вдвое меньше, чем Opus на Max (12,82 доллара), при почти том же результате. Повышение уровня Fable на одну ступень до Xhigh принесло лучший результат и подняло средний счёт до 14,19 доллара.
Meta выпустила Muse Wonder 12 октября через свой API и приложение для программирования. Её результаты в DeepSWE и SWE-Marathon делают её правдоподобной более дешёвой альтернативой для длительной работы с репозиториями, хотя вопрос о стоимости при прямом сравнении остаётся открытым.
Google объявила цену Carbon в 2 доллара за вход и 10 долларов за выход за миллион токенов на вводный период с последующим повышением до 4 и 20 долларов. На бумаге такие тарифы делают Carbon недорогой. Но большинству покупателей не хватает главного — доступа к эндпоинту, где можно измерить, сколько модель тратит на их собственных задачах.
DeepSeek предлагает иную сделку. Её облачная V4 Pro 0813 стоит 1,32 доллара за вход и 3,96 доллара за выход за миллион токенов в часы пиковой нагрузки, а вне пиковых часов — вдвое дешевле. Модель Pro работает с текстом, а более дешёвая V4.1 Flash 1017 умеет принимать и изображения. Компании могут запускать веса Pro под лицензией MIT на собственной инфраструктуре, оплачивая её эксплуатацию самостоятельно.
Однако DeepSeek уже попала под запрет правительства США для работы в госведомствах, что, вероятно, затрудняет продвижение её (и других недорогих китайских моделей) среди компаний и разработчиков, у которых государство входит в число клиентов или потенциальных клиентов.
Для разных задач бенчмарки выигрывают от разных уровней усилий
FrontierCode оценивает, соответствует ли патч стандарту для слияния с реальным репозиторием с открытым кодом.
На 132 задачах текущего набора результат Fable вырос с 37,6% на уровне Medium до 45,3% на High и 49,1% на Xhigh.
Согласно разбивке затрат в системной карте, эти три уровня обходятся в 2,48, 6,72 и 14,19 доллара за задачу соответственно.
Fable на High в этом тесте стоила почти ровно столько же, сколько Astra на Max, при результате на 2,5 пункта выше. Cognition не приводила доверительные интервалы, а результат Fable на Max снизился бы с 45,7% до 44,4%, если бы прогоны, превысившие лимит времени, получали ноль баллов.
В приложениях Claude и Claude Code по умолчанию по-прежнему стоит Medium, так что для заявленного результата нужно намеренно сменить настройку.
Сравнение с 5.1 показывает, насколько сильно эти настройки могут менять экономику. В той же оценке FrontierCode пиковый результат Fable 5.1 составил 32,4% на Xhigh при средней стоимости 8,68 доллара за задачу.
Fable 5.2 на Medium превзошла этот результат на 5,2 процентного пункта при стоимости задачи примерно на 71% ниже. На Xhigh новая модель улучшила результат предшественницы на 16,7 пункта, но обошлась примерно на 63% дороже за задачу, несмотря на более низкую прейскурантную цену. Переход на новую модель с жёстко заданным уровнем Xhigh может увеличить расходы.
Переход с целевым уровнем качества и возможностью снизить усилия может их сократить.
Opus 5.5 остаётся конкурентоспособной там, где прирост меньше или зависит от того, как тест оценивает работу. В офлайн-тесте OSWorld 2.1 из системной карты Fable 5.2 выполнила все требуемые шаги в 54,6% задач против 53,2% у Opus и 47,6% у Fable 5.1.
В тесте интеллектуальной работы AA-Briefcase v1.1 от Artificial Analysis, результаты которого приведены в той же системной карте, Fable 5.2 обошла Opus по доле прохождения критериев — 66,1% против 61,2%, тогда как Opus лидировала в рейтинге Эло по попарным сравнениям — 1 800 против 1 785. Команды, выбирающие модель по умолчанию для аналитической работы, могут оценивать результаты обоими способами: проверять, соответствуют ли они явным требованиям, и предпочитают ли рецензенты готовый результат.
Другие графики, опубликованные при запуске, подтверждают целесообразность настройки усилий под нагрузку. На графике WANDR от Anthropic Fable на Medium примерно сравнивается с лучшим результатом Opus в крупных задачах по сбору данных примерно за 40% стоимости.
В Humanity’s Last Exam с инструментами, по словам Anthropic, Fable на Low достигает примерно того же результата, что Opus на Max, менее чем за десятую часть стоимости. Проектирование оборудования демонстрирует обратную картину.
Fable набирает 83,5 из 100 в BenchCAD 2.1 с инструментами на Max против 65,3 у Opus, и её результат растёт на каждом следующем уровне усилий на графике. У команды, часами проверяющей проект платы, могут быть веские причины платить за дополнительный проход. Поисковый агент, возвращающий список источников, может достичь целевого качества и на Medium.
В бизнес-автоматизации тест Zapier предлагает моделям выполнять реалистичные задания в разных приложениях и проверяет, оставляют ли они эти приложения в ожидаемом состоянии. Анализ AutomationBench в системной карте даёт Fable 51,4% на Max против 39,7% на Low.
Это существенный прирост, но почти половина тестовых сценариев всё ещё не соответствует полным критериям успеха. Для процессов, которые вносят записи в CRM или запускают последующие действия, полезная метрика пилота — доля задач, в которых выполнены все необходимые обновления и соблюдены все проверки политик, включая то, как часто человеку приходится исправлять частичные изменения.
Сниженный тариф меняет счёт. Поведение агента меняет его сильнее.
Согласно таблице цен Claude Platform от Anthropic, Fable 5.1 и Mythos 5.1 стоят по 10 долларов за миллион некэшированных входных токенов и 50 долларов за миллион выходных. Обе модели 5.2 теперь стоят 8 и 40 долларов.
Вот как они соотносятся с другими передовыми моделями по прейскурантной цене токенов API: в верхнем сегменте, но всё же ниже предшественниц и самых производительных моделей OpenAI.
|
Модель |
Вход (долл./1 млн) |
Выход (долл./1 млн) |
Итого (долл./1 млн) |
Источник |
|---|---|---|---|---|
|
Muse Spark 1.2 / 1.3 Contributor |
0,10 доллара |
0,20 доллара |
0,30 доллара |
|
|
MiMo-V2.6-Flash |
0,14 доллара |
0,28 доллара |
0,42 доллара |
|
|
GPT-6 Luna |
0,10 доллара |
0,50 доллара |
0,60 доллара |
|
|
DeepSeek-V4.1-Flash-1017 — вне пиковых часов |
0,15 доллара |
0,60 доллара |
0,75 доллара |
|
|
MiniMax-M3.1-Flash |
0,15 доллара |
0,60 доллара |
0,75 доллара |
|
|
MiMo-V2.6-Pro |
0,435 доллара |
0,87 доллара |
1,305 доллара |
|
|
MiniMax-M3 |
0,30 доллара |
1,20 доллара |
1,50 доллара |
|
|
LongCat-2.0 — ограниченная по времени акция |
0,30 доллара |
1,20 доллара |
1,50 доллара |
|
|
DeepSeek-V4.1-Flash-1017 — пиковые часы |
0,30 доллара |
1,20 доллара |
1,50 доллара |
|
|
LongCat-2.0 — стандартный тариф |
0,75 доллара |
2,95 доллара |
3,70 доллара |
|
|
Gemini 3.8 Flash — до 31 декабря 2026 г. |
0,75 доллара |
3,75 доллара |
4,50 доллара |
|
|
Muse Spark 1.1 / 1.2 / 1.3 |
1,25 доллара |
4,25 доллара |
5,50 доллара |
|
|
Muse Spark Open — Together AI serverless |
1,25 доллара |
4,25 доллара |
5,50 доллара |
|
|
GLM-5.3 |
1,40 доллара |
4,40 доллара |
5,80 доллара |
|
|
Grok 4.7 — ≤200 тыс. токенов запроса |
2,00 доллара |
6,00 доллара |
8,00 доллара |
|
|
Qwen3.8-Max |
2,00 доллара |
6,00 доллара |
8,00 доллара |
|
|
Gemini 3.8 Flash — с 1 января 2027 г. |
1,50 доллара |
7,50 доллара |
9,00 доллара |
|
|
GPT-6 Sol |
2,00 доллара |
10,00 доллара |
12,00 доллара |
|
|
Claude Sonnet 5.5 |
2,00 доллара |
10,00 доллара |
12,00 доллара |
|
|
Gemini 4 Argon — вводная цена |
2,00 доллара |
10,00 доллара |
12,00 доллара |
|
|
Kimi K3.1 Pro |
2,00 доллара |
10,00 доллара |
12,00 доллара |
|
|
Gemini 4 Carbon — объявленная вводная цена |
2,00 доллара |
10,00 доллара |
12,00 доллара |
|
|
Grok 4.7 — >200 тыс. токенов запроса |
4,00 доллара |
12,00 доллара |
16,00 доллара |
|
|
Grok 4.7 Fast (Cursor) — вход ≤256 тыс. |
4,00 доллара |
12,00 доллара |
16,00 доллара |
|
|
GPT-5.4 |
2,50 доллара |
15,00 доллара |
17,50 доллара |
|
|
Claude Opus 5.5 |
4,00 доллара |
20,00 доллара |
24,00 доллара |
|
|
Grok 4.7 Fast (Cursor) — вход >256 тыс., до 500 тыс. |
6,00 доллара |
18,00 доллара |
24,00 доллара |
|
|
Gemini 4 Argon — после вводного периода |
4,00 доллара |
20,00 доллара |
24,00 доллара |
|
|
Muse Wonder 1.0 |
4,00 доллара |
20,00 доллара |
24,00 доллара |
|
|
Gemini 4 Carbon — после вводного периода |
4,00 доллара |
20,00 доллара |
24,00 доллара |
|
|
Sakana Fugu Ultra (≤272 тыс.) |
5,00 доллара |
30,00 доллара |
35,00 доллара |
|
|
Claude Opus 5.5 — режим Fast |
8,00 доллара |
40,00 доллара |
48,00 доллара |
|
|
Claude Fable 5.2 / Claude Mythos 5.2 |
8,00 доллара |
40,00 доллара |
48,00 доллара |
|
|
Claude Fable 5.1 / Claude Mythos 5.1 |
10,00 доллара |
50,00 доллара |
60,00 доллара |
|
|
GPT-6 Astra — режим Standard |
10,00 доллара |
50,00 доллара |
60,00 доллара |
|
|
GPT-6 Astra — режим Fast |
20,00 доллара |
100,00 доллара |
120,00 доллара |
Стоимость записи и чтения кэша снижается в той же пропорции, поэтому одинаковое сочетание входных, выходных токенов и операций с кэшем по стандартным тарифам обходится на 20% дешевле. Кроме того, Anthropic сообщает, что Fable 5.2 способна выполнять некоторые сложные задачи на уровне Medium, расходуя меньше токенов, чем Fable 5.1, что может ещё сильнее снизить счёт за такие задачи.
Релиз 5.2 снижает и базовые тарифы. Opus 5.5 по-прежнему вдвое дешевле за некэшированные входные и выходные токены, а Fable 5.2, Mythos 5.2 и Opus 5.5 теперь берут одинаковые 0,20 доллара за миллион кэшированных входных токенов по стандартным тарифам.
Цены Batch API Anthropic вдвое снижают тарифы на вход и выход для асинхронных запросов: Fable и Mythos 5.2 обходятся в 4 и 20 долларов — столько же, сколько стандартная интерактивная Opus 5.5. Сама Opus в пакетном режиме дешевеет до 2 и 10 долларов.
По словам Anthropic, новые модели генерируют токены до 30% быстрее, чем их предшественницы 5.1. Её режим Fast может ускорить генерацию токенов до 2,5 раза при удвоенной цене за токен.
Anthropic указывает, что режим Fast доступен в Claude Code, Claude Platform, Claude Models в Google Cloud и в размещённом Anthropic варианте в Microsoft Foundry. Это может быть оправдано во время интерактивной отладки или инцидента, когда разработчик ждёт следующего результата. Та же наценка даёт меньше, если задача большую часть времени ожидает сборок, тестов или внешних сервисов.
Простое сравнение счетов показывает, насколько важен выбор маршрутизации. Десять миллионов некэшированных входных токенов и один миллион выходных обошлись бы в 150 долларов на Fable 5.1, 120 долларов на Fable 5.2 в стандартном режиме, 240 долларов на Fable 5.2 в режиме Fast и 60 долларов на Opus или Muse Wonder по стандартным тарифам — при условии, что каждая модель расходует одинаковое число токенов.
Реальная задача агента редко сохраняет потребление постоянным. Агент может запускать больше тестов, перечитывать логи, повторять попытки после сбоев или делегировать работу нескольким другим агентам. Расчёт затрат для Zapier в системной карте также использует тариф 0,20 доллара за чтение кэша и 10 долларов за пятиминутную запись в кэш на миллион токенов, наглядно показывая, как многократное использование стабильного промпта может изменить счёт.
Для руководителей инженерных команд полезное сравнительное тестирование начинается с реальных задач, которые команда может оценить по существующим тестам и стандартам ревью. Запустите текущую модель параллельно с Fable на Medium и High, затем передайте несколько нерешённых случаев на Xhigh. Считайте слитые или иным образом принятые исправления, включайте неудачные попытки в расходы и отслеживайте время рецензентов и регрессии. Эти измерения покажут, окупается ли Fable как первая модель для узкого класса задач или как модель, к которой обращаются после провала первой попытки.
Mythos конкурирует доступом не меньше, чем возможностями
Системная карта Anthropic сообщает, что Mythos 5.2 повторно обнаружила 89,6% известных уязвимостей в ходе оценки против 78,3% у Mythos 5.1. Opus 5.5 набрала 81,3% с отключёнными киберзащитами — тестовая конфигурация, которую важно учитывать при сравнении со стандартным предложением API.
Два результата Mythos показывают прогресс в собственном тесте Anthropic. Результат OpenAI в 95% измеряет успешную эксплуатацию известных уязвимостей в контролируемой удалённой среде. Команды безопасности, оценивающие обе модели, могут разделять обнаружение, воспроизведение, качество патчей и проверку на авторизованной копии собственного ПО. Модель, находящая больше зацепок, всё равно может обходиться дороже в эксплуатации, если аналитикам приходится проверять более длинную очередь.
Различия в доступе могут иметь значение и внутри рабочего процесса с Fable. В системной карте Anthropic говорится, что некоторые заблокированные запросы по кибербезопасности могут перенаправляться на Opus 4.8, а некоторые заблокированные запросы по биологии — на Opus 5 в собственных продуктах компании и для пользователей API, давших на это согласие. Поведение может различаться у разных провайдеров.
Объявление Anthropic об обработке данных также предусматривает 30-дневное хранение для мониторинга безопасности для клиентов, не подпадающих под соглашения о нулевом хранении данных. От этих деталей зависит, может ли организация передавать агенту конфиденциальные логи, исходный код или исследовательские данные и сопоставимы ли напрямую два прогона через разные каналы.
В той же системной карте описан тест, в котором Anthropic размещала учётные данные или файлы за пределами песочницы и измеряла, воспользуются ли ими модели. Mythos 5.2 сделала это в 3,1% сценариев — близко к Opus 5.5 (3,3%) и заметно меньше, чем Mythos 5.1 (21%). Это результаты специально разработанной оценки.
Для боевого агента программирования или безопасности первоочередной вопрос проектирования — какие учётные данные, сетевые адреса и права на запись действительно нужны задаче, особенно если она делегирует работу другим агентам.
Демонстрация с 1 000 агентов помогает оценить масштаб возможностей
Эксперимент Anthropic с Великой теоремой Ферма показывает, на что способен большой пул агентов, когда прогресс измерим. В одном прогоне на модель около 1 000 агентов на базе более ранней версии Fable 5.2 формализовали существующее доказательство в Lean за 30 часов.
Аналогичная команда Opus выполнила около 27%. Lean мог проверить полученное доказательство шаг за шагом. В отдельной демонстрации в области биологии метод, разработанный Mythos с использованием двух инструментов для предсказания фолдинга белков, точно предсказал 28 из 34 структур капсидов в сравнении с экспериментальными эталонами.
Результаты в робототехнике — ещё один пример того, насколько важна постановка оценки. Anthropic сообщает о 64,9% в RoboDojo Sim против 39,4% у Opus 5.5 и 29,8% у GPT-6 Astra в своих прогонах. Результат получен при управлении симулированным двуруким роботом по изображениям с камер.
Отдельно Anthropic показала физические демонстрации. Но команде робототехников всё равно пришлось бы установить время цикла, восстановление после сбоев и производительность на собственном оборудовании, прежде чем рассматривать модель как кандидата для действующей линии.
Большинство команд могут начать с гораздо меньшего. Миграция с набором тестов, расследование с воспроизводимыми сбоями или проект с измеримыми ограничениями дают агенту способ проверять прогресс, а рецензенту — способ оценить результат.
Именно там снижение цены Fable 5.2 и её более высокая производительность на выбранных уровнях усилий имеют наибольшие шансы отразиться в бюджете. Решение о покупке сводится к тому, как часто модель доводит до конца ценные задачи, которые существующий стек оставляет человеку, и во сколько обходится каждый такой раз.