


ATLAS от Together AI увеличивает производительность инференса на 400%


Предприятия, расширяющие развертывание ИИ, сталкиваются с невидимым барьером производительности. В чем причина? Статические спекуляторы, которые не успевают за изменяющимися рабочими нагрузками.
Спекуляторы — это более мелкие модели ИИ, которые работают в паре с большими языковыми моделями во время инференса. Они заранее генерируют несколько токенов, которые главная модель затем проверяет параллельно. Этот метод (называемый спекулятивным декодированием) стал критически важным для предприятий, пытающихся снизить затраты на инференс и задержки. Вместо генерации токенов по одному система может принимать несколько токенов одновременно, что значительно увеличивает пропускную способность.
Together AI сегодня анонсировала результаты исследований и новую систему под названием ATLAS (AdapTive-LeArning Speculator System), призванную помочь компаниям преодолеть проблему статических спекуляторов. Этот метод обеспечивает возможность самообучающейся оптимизации инференса, что позволяет повысить производительность инференса до 400% по сравнению с базовым уровнем в существующих технологиях инференса, таких как vLLM. Система решает ключевую проблему: по мере эволюции рабочих нагрузок ИИ скорость инференса падает, даже при наличии специализированных спекуляторов.
Компания, которая начала свою деятельность в 2023 году, сосредоточилась на оптимизации инференса на своей корпоративной платформе ИИ. Ранее в этом году компания привлекла 305 млн долларов на фоне роста внедрения клиентами и увеличения спроса.
«Компании, с которыми мы работаем, по мере своего роста обычно сталкиваются с изменением рабочих нагрузок, после чего уже не наблюдают прежнего прироста скорости от спекулятивного выполнения, — рассказал Три Дао (Tri Dao), главный научный сотрудник Together AI, в эксклюзивном интервью VentureBeat. — Как правило, эти спекуляторы работают плохо, когда домен их рабочей нагрузки начинает смещаться».
Проблема дрейфа рабочей нагрузки, о которой никто не говорит
Большинство используемых сегодня в продакшене спекуляторов являются «статическими» моделями. Они обучаются один раз на фиксированном наборе данных, отражающем ожидаемые нагрузки, после чего развертываются без какой-либо возможности адаптации. Такие компании, как Meta и Mistral, поставляют предварительно обученные спекуляторы вместе со своими основными моделями. Платформы инференса, такие как vLLM, используют эти статические спекуляторы для повышения пропускной способности без изменения качества вывода.
Но здесь есть подвох. Когда характер использования ИИ на предприятии меняется, точность статического спекулятора стремительно падает.
«Если вы компания, разрабатывающая агенты для написания кода, и большинство ваших разработчиков писали на Python, а внезапно некоторые из них переключаются на Rust или С, вы заметите, что скорость начинает падать, — пояснил Дао. — Возникает несоответствие между тем, на чем обучался спекулятор, и реальной рабочей нагрузкой».
Этот дрейф рабочей нагрузки представляет собой скрытый налог на масштабирование ИИ. Предприятия либо смиряются со снижением производительности, либо инвестируют в переобучение кастомных спекуляторов. Этот процесс фиксирует лишь сиюминутный снимок и быстро устаревает.
Как работают адаптивные спекуляторы: подход с двумя моделями
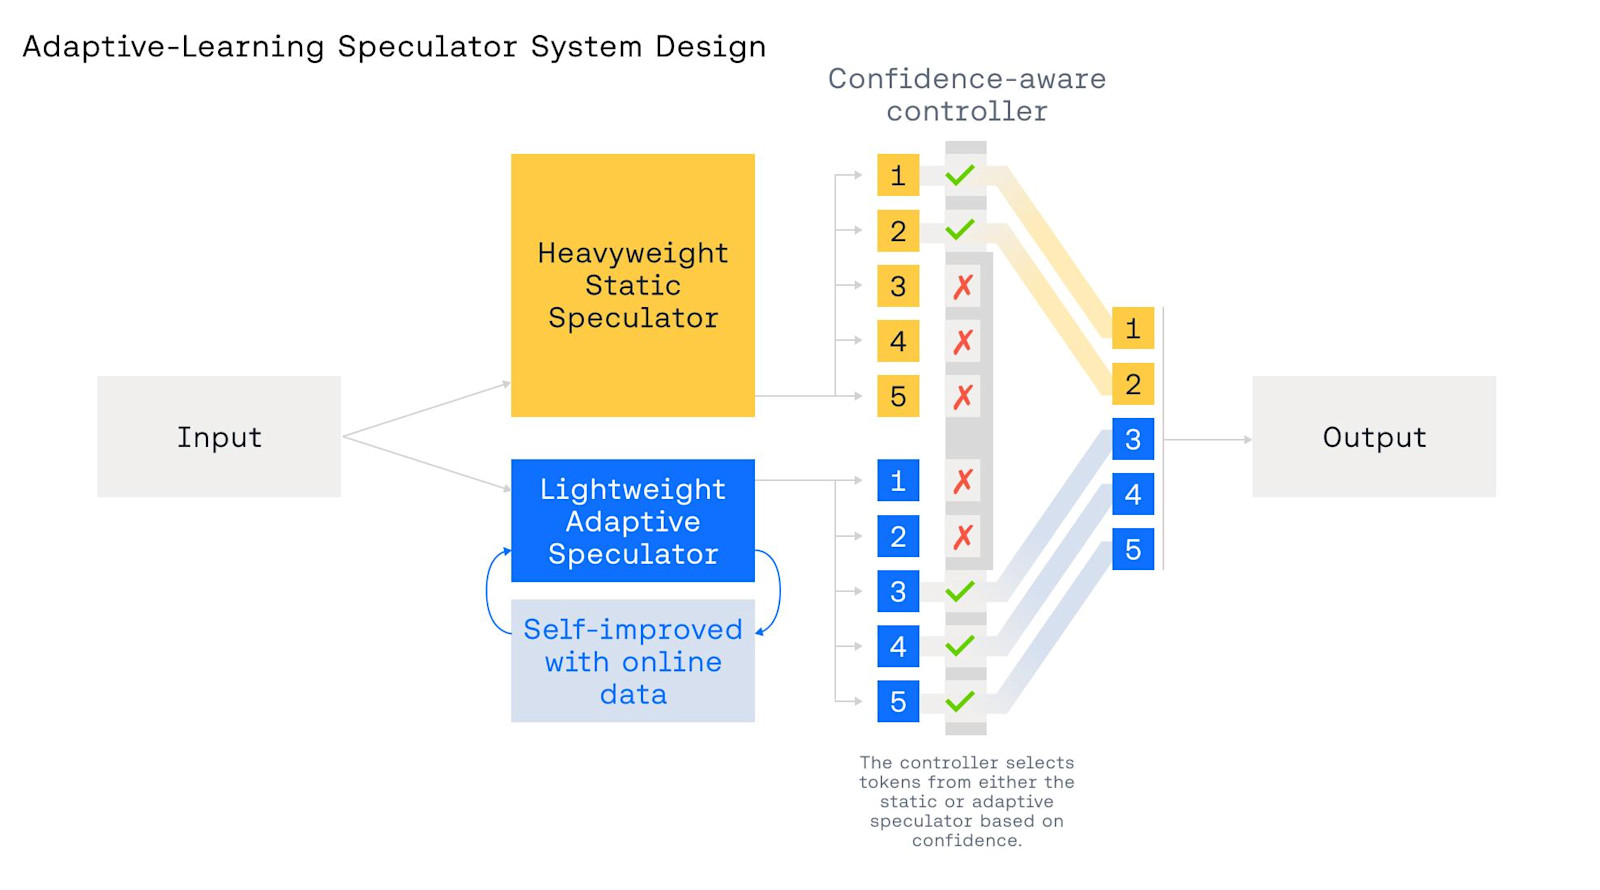
В ATLAS используется архитектура с двумя спекуляторами, которая сочетает в себе стабильность и адаптивность:
Статический спекулятор — тяжеловесная модель, обученная на широком массиве данных, обеспечивает стабильную базовую производительность. Она служит «нижним порогом скорости».
Адаптивный спекулятор — легковесная модель, которая непрерывно учится на «живом» трафике. Она «на лету» специализируется на возникающих доменах и паттернах использования.
Контроллер с учетом уровня уверенности — уровень оркестрации, который динамически выбирает, какой спекулятор использовать. Он регулирует «опережающий просмотр» (lookahead) спекулятора на основе оценок уверенности.
«Прежде чем адаптивный спекулятор чему-то научится, у нас все еще есть статический спекулятор, помогающий обеспечить прирост скорости в самом начале, — пояснил Бен Атхивараткун (Ben Athiwaratkun), старший научный сотрудник по ИИ в Together AI, в интервью VentureBeat. — Как только адаптивный спекулятор становится более уверенным, скорость со временем растет».
Техническая инновация заключается в балансировке коэффициента принятия (насколько часто целевая модель согласна с предложенными токенами) и задержки генерации черновика. По мере того как адаптивная модель обучается на паттернах трафика, контроллер все больше полагается на легковесный спекулятор и расширяет горизонт прогнозирования. Это обеспечивает кумулятивный прирост производительности.
Пользователям не нужно настраивать какие-либо параметры. «Что касается пользователей, им не нужно крутить никакие ручки, — отметил Дао. — С нашей стороны мы уже настроили эти параметры так, чтобы пользователи получали хорошую прибавку в скорости».
Спекулятор ATLAS
Производительность, соперничающая со специализированным кремнием
Тестирование Together AI показывает, что при полной адаптации ATLAS достигает 500 токенов в секунду на модели DeepSeek-V3.1. Более впечатляющим является то, что эти показатели на графических процессорах Nvidia B200 соответствуют или превосходят специализированные чипы для инференса, такие как кастомное железо от Groq.
«Программные и алгоритмические улучшения позволяют сократить отставание от действительно специализированного оборудования, — заявил Дао. — Мы наблюдали 500 токенов в секунду на этих огромных моделях, что даже быстрее, чем на некоторых специализированных чипах».
Заявленное компанией 400-процентное ускорение инференса представляет собой кумулятивный эффект оптимизационного пакета Together Turbo. Квантование FP4 обеспечивает прирост скорости на 80% по сравнению с базовым уровнем FP8. Статический спекулятор Turbo добавляет еще 80-100% прироста. Адаптивная система накладывается поверх всего этого. Каждая оптимизация усиливает преимущества остальных.
По сравнению со стандартными движками инференса, такими как vLLM или TensorRT-LLM от Nvidia, улучшение весьма существенно. Together AI проводит бенчмаркинг по сравнению с более сильной базовой линией для каждой рабочей нагрузки перед применением спекулятивных оптимизаций.
Объяснение компромисса между памятью и вычислениями
Прирост производительности проистекает из устранения фундаментальной неэффективности современного инференса: нецелевого использования вычислительных мощностей.
Дао пояснил, что обычно во время инференса значительная часть вычислительной мощности используется не полностью.
«Во время инференса, который фактически является доминирующей рабочей нагрузкой в наши дни, вы в основном задействуете подсистему памяти», — сказал он.
Спекулятивное декодирование меняет простаивающие вычисления на сокращение обращений к памяти. Когда модель генерирует по одному токену за раз, она ограничена скоростью работы памяти. Графический процессор простаивает в ожидании памяти. Но когда спекулятор предлагает пять токенов, а целевая модель проверяет их одновременно, использование вычислений резко возрастает, в то время как количество обращений к памяти остается примерно постоянным.
«Общий объем вычислений для генерации пяти токенов остается прежним, но к памяти пришлось обратиться всего один раз вместо пяти», — пояснил Дао.
Рассматривайте это как интеллектуальное кэширование для ИИ
Для инфраструктурных команд, знакомых с традиционной оптимизацией баз данных, адаптивные спекуляторы функционируют как интеллектуальный уровень кэширования, но с одним важным отличием.
Традиционные системы кэширования, такие как Redis или memcached, требуют точного совпадения. Вы сохраняете точно такой же результат запроса и извлекаете его, когда этот конкретный запрос выполняется снова. Адаптивные спекуляторы работают иначе.
«Это можно рассматривать как интеллектуальный способ кэширования: мы не сохраняем точные данные, а выявляем определенные наблюдаемые паттерны, — пояснил Дао. — В целом мы замечаем, что вы работаете с похожим кодом или управляете вычислениями схожим образом. Тогда мы можем предсказать, что скажет большая модель. Мы просто становимся все лучше и лучше в этом прогнозировании».
Вместо хранения точных ответов система изучает закономерности генерации токенов моделью. Она распознает, что если вы редактируете файлы Python в определенной кодовой базе, становятся более вероятными определенные последовательности токенов. Спекулятор адаптируется к этим паттернам, со временем улучшая свои прогнозы без необходимости предоставления идентичных входных данных.
Варианты использования: обучение на основе RL и эволюционирующие рабочие нагрузки
Два корпоративных сценария особенно выигрывают от использования адаптивных спекуляторов:
Обучение с подкреплением (Reinforcement Learning): Статические спекуляторы быстро теряют актуальность по мере изменения стратегии (политики) в процессе обучения. ATLAS непрерывно адаптируется к изменяющемуся распределению политик.
Эволюционирующие рабочие нагрузки: По мере того как предприятия открывают для себя новые сценарии использования ИИ, структура рабочей нагрузки меняется. «Возможно, они начали использовать ИИ для чат-ботов, но затем поняли: о, он может писать код, и начали переключаться на код, — говорит Дао. — Или они осознают, что эти ИИ действительно могут вызывать инструменты, управлять компьютерами, заниматься бухгалтерским учетом и тому подобными вещами».
В сеансе «вайб-кодинга» (vibe-coding) адаптивная система может специализироваться на конкретной редактируемой кодовой базе. Это файлы, которые не встречались во время обучения. Это еще больше увеличивает коэффициент принятия и скорость декодирования.
Что это значит для предприятий и экосистемы инференса
Система ATLAS теперь доступна на выделенных эндпоинтах Together AI как часть платформы без дополнительных затрат. Более чем 800 000 разработчиков компании (по сравнению с 450 000 в феврале) получили доступ к этой оптимизации.
Но более широкие последствия выходят за рамки продукта одного вендора. Переход от статической к адаптивной оптимизации представляет собой фундаментальное переосмысление того, как должны работать платформы инференса. По мере того как предприятия развертывают ИИ в различных доменах, отрасли потребуется отойти от однократно обученных моделей в сторону систем, которые учатся и совершенствуются непрерывно.
Компания Together AI исторически выпускала некоторые из своих исследовательских наработок в качестве открытого исходного кода и сотрудничала с такими проектами, как vLLM. Хотя полностью интегрированная система ATLAS является проприетарной, некоторые из лежащих в ее основе методов со временем могут повлиять на всю экосистему инференса.
Для компаний, стремящихся занять лидирующие позиции в сфере ИИ, сигнал очевиден: адаптивные алгоритмы на обычном оборудовании могут соперничать со специализированным кремнием за малую долю его стоимости. По мере того как этот подход зреет в масштабах всей отрасли, программная оптимизация все больше превосходит специализированное железо.




