


PixelRAG превосходит текстовые парсеры и снижает расходы на агентов в 10 раз
Источник: VentureBeat · Sean Michael Kerner


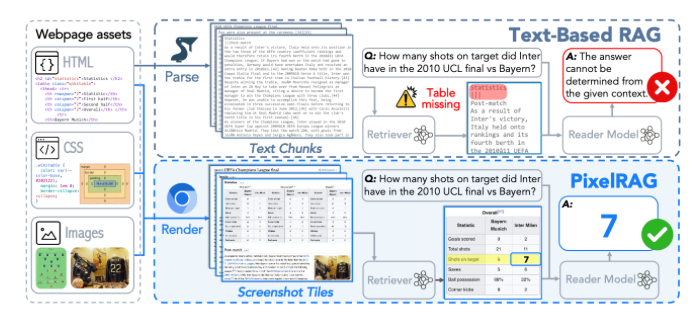
Большинство корпоративных RAG-пайплайнов устроены одинаково: текстовый парсер преобразует веб-страницы и документы в простой текст, чтобы его можно было разбить на фрагменты (чанки) и проиндексировать для последующего поиска. Этот этап конвертации уничтожает поисковые признаки, и, согласно новым исследованиям, именно он является причиной большинства неправильных ответов.
Исследовательская группа из Калифорнийского университета в Беркли, Принстонского университета, EPFL и Databricks опубликовала на этой неделе научную работу, в которой представила PixelRAG — систему, полностью исключающую этот этап конвертации. Вместо того чтобы парсить страницы в текст, PixelRAG сохраняет их в виде скриншотов, индексирует эти изображения и передает извлеченные фрагменты (тайлы) напрямую визуально-языковой модели. Система прошла тестирование на 30 миллионах тайлов скриншотов, охватывающих всю Википедию, и превзошла текстовый RAG по шести бенчмаркам, повысив точность на величину до 18,1% по сравнению с текстовыми базовыми методами.
По мнению исследовательской группы, парсеры — это не то место, где следует искать решения проблем.
«Совершенствование парсеров — это бесконечный процесс, поскольку каждый веб-сайт требует индивидуального подхода», — рассказал VentureBeat Ичуань Ван (Yichuan Wang), ведущий автор исследования и аспирант Калифорнийского университета в Беркли. — Наша цель заключалась в том, чтобы выяснить, позволяют ли последние достижения в области визуально-языковых моделей обойти эту проблему целиком и создать поисковую систему, которая работает на разных сайтах без необходимости написания специфического кода для каждого из них». Ичуань Ван
HTML-парсеры уничтожают поисковые сигналы, от которых зависит корпоративный RAG
Целью исследователей было разработать чистую сквозную архитектуру.
«Современные веб-пайплайны RAG часто включают в себя рендеринг, парсинг, очистку, чанкинг и множество других этапов, выполняемых вручную, — отметил Ван. — Каждый этап привносит потенциальные каскадные ошибки и абстракции, которые все сильнее отдаляют нас от оригинальной веб-страницы. Нам было интересно, сможем ли мы устранить большую часть этой сложности и работать напрямую с отрендеренной страницей».
Ван также подчеркнул, что парсинг неизбежно ведет к потере информации. Изображения, визуальная иерархия, типографика, выделения (например, жирный шрифт), таблицы и верстка либо отбрасываются, либо преобразуются в несовершенные текстовые приближения.
«Каким бы совершенным ни становился парсер, часть информации неизбежно и безвозвратно теряется в процессе конвертации», — добавил он.
В исследовании выделены три основные причины, по которым текстовый RAG теряет ответ до того, как тот дойдет до читателя. Все они измерялись на SimpleQA — стандартном бенчмарке, состоящем из 1 000 фактических вопросов по Википедии:
-
Потери на этапе парсинга (36,6% сбоев). Преобразование из HTML в текст настолько полно уничтожает структурированный контент, что ни один текстовый чанк в корпусе данных не содержит ответа.
-
Потери ранжирования (55,2% сбоев). Ответ присутствует в корпусе, но вытесняется плотными по ключевым словам инфобоксами, которые занимают 1-е место в 75,9% запросов, сдвигая содержащие ответ абзацы на 20-е место и ниже.
-
Потери на стороне читателя (8,2% сбоев). Правильный контент доходит до читателя, но сглаженная структура приводит к неверной атрибуции.
Как работает PixelRAG
В отличие от стандартной языковой модели, которая работает исключительно с текстом, визуально-языковая модель принимает на вход изображения наравне с текстом. Это означает, что она может читать отрендеренную веб-страницу так же, как это делает человек, сохраняя верстку и структуру. «Мы считаем, что для многих задач извлечения структурированной информации современные ВЯМ имеют врожденное преимущество, поскольку они способны осуществлять логический вывод одновременно по содержимому и по макету, а не опираться на плоское текстовое представление», — сказал Ван.
PixelRAG построен на этом принципе: он заменяет конвейер текстового парсинга четырехуровневой системой, которая работает исключительно с отрендеренными скриншотами.
-
Рендеринг. Страницы рендерятся с помощью Playwright (библиотеки для автоматизации браузера) в фиксированном разрешении с шириной области просмотра 875 пикселей и нарезаются на тайлы высотой 1024 пикселя. Из 7 миллионов статей Википедии получается примерно 30 миллионов тайлов. Ресурсы кэшируются локально и рендерятся полностью в автономном режиме.
-
Индексация. Каждый тайл кодируется как единый 2048-мерный вектор с помощью Qwen3-VL-Embedding-2B и сохраняется в индекс приблизительного поиска ближайших соседей FAISS. Полный индекс занимает около 120 ГБ в формате fp16 и поддерживает инкрементальные обновления без необходимости полной переиндексации.
-
Обучение. Модель поиска дообучается на синтетических контрастивных данных, сгенерированных из хранилища данных, с использованием динамического майнинга сложных негативов для фильтрации ложных срабатываний. Метод LoRA (легковесная доводка, обновляющая лишь малую долю весов модели) применяется как к основе языковой модели, так и к визуальному энкодеру. Обучение примерно на 40 000 парах завершается менее чем за три часа на одном графическом ускорителе H100.
-
Хранение. Исходные тайлы скриншотов для Википедии требуют 5,6 ТБ дискового пространства, однако подход с рендерингом по запросу позволяет исключить постоянное хранение: можно проиндексировать все тайлы, удалить скриншоты и заново отрендерить страницы по запросу в момент отправки поискового запроса. Векторный индекс занимает около 120 ГБ.
Источник: https://github.com/StarTrail-org/PixelRAG/blob/main/assets/pixelrag-paper.pdf
Шесть бенчмарков, 10-кратная экономия токенов для агентов и одна нерешенная проблема
Исследователи протестировали PixelRAG по шести бенчмаркам, охватывающим фактические ответы на вопросы по Википедии, табличные запросы, мультимодальные задачи QA и поиск по свежим новостям. По их словам, система превзошла текстовый RAG по всем шести направлениям, в том числе в задачах, где ответы можно было найти и в обычном тексте. На наборе SimpleQA точность достигает 78,8% против 71,6% у сильнейшего текстового парсера, а на структурированных запросах по таблицам разрыв увеличивается до 48,8% против 42,5%. Чтобы ощутить преимущества, командам требуются модели класса Qwen3-VL-4B и выше. Модели меньшего размера отстают от текстового поиска более чем на 12,5 процентных пункта.
Преимущество в стоимости токенов для агентов — самый весомый аргумент в пользу PixelRAG в ближайшей перспективе. В ходе бенчмарк-тестирования ИИ-агент, использующий PixelRAG в качестве поискового бэкенда, задействовал 3,6 миллиона токенов промпта против 37,5 миллиона у текстового поиска, продемонстрировав в 2–4 раза более низкую стоимость по сравнению с альтернативами (включая Google) при более высокой точности. Сжатие изображений способно сократить этот бюджет токенов еще на треть.
Визуальный чанкинг остается главной нерешенной проблемой. Системы текстового RAG годами совершенствовали методы разделения документов на осмысленные поисковые блоки в зависимости от темы, раздела или семантического содержания. У PixelRAG пока нет аналога: система делит страницы по фиксированной высоте в пикселях, а это означает, что таблица или абзац могут быть разрезаны пополам прямо посреди тайла без учета границ контента.
«Сообщество разработчиков текстового поиска годами изучало стратегии чанкинга, в то время как визуальному поиску уделялось гораздо меньше внимания, — отметил Ван. — Мы считаем это важным направлением для будущих исследований».
Что это значит для бизнеса
Проблема качества поиска, которую решает PixelRAG, отражает более широкий рыночный сдвиг, происходящий уже сейчас. Данные отчета VB Pulse за первый квартал 2026 года, полученные от квалифицированных респондентов из корпоративного сектора, показали, что намерение внедрить гибридный поиск выросло втрое — с 10,3% в январе до 33,3% в марте, что делает его самым быстрорастущим стратегическим направлением в исследовании. Сами авторы PixelRAG называют гибридное развертывание наиболее практичным путем в ближайшей перспективе: надстройку визуального поиска поверх существующих текстовых систем вместо их полной замены.
Для команд, которые уже эксплуатируют RAG-пайплайны, путь к такой экономии гораздо проще, чем капитальная перестройка с нуля.
«Практичный подход заключается в том, чтобы использовать PixelRAG в качестве слоя оптимизации поверх существующих систем текстового поиска, — резюмировал Ван. — Гибридный поиск, объединяющий текстовый и визуальный подходы, прост в реализации, и именно по этому пути, скорее всего, пойдет развитие многих производственных развертываний».




