


Google представляет Gemini Embedding 2 с нативной поддержкой мультимодальности для снижения затрат и ускорения работы корпоративных стеков данных
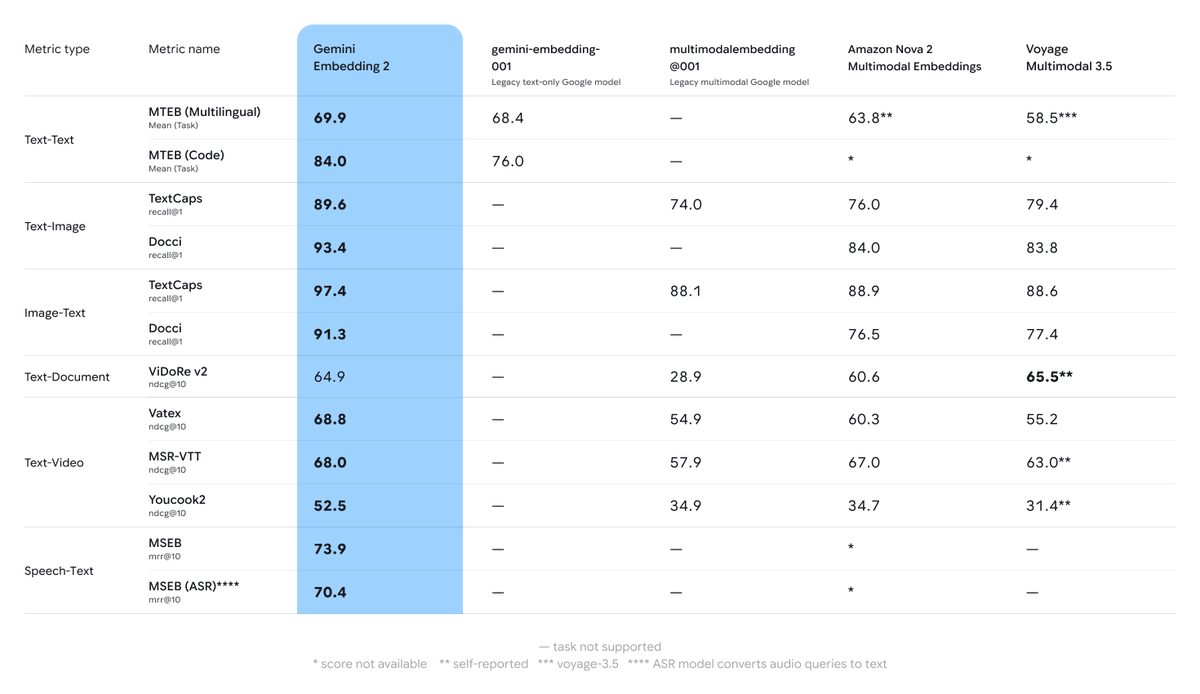


Вчера на фоне множества обновлений корпоративных ИИ-продуктов компания Google анонсировала, пожалуй, самое значимое из них для корпоративных клиентов: выход в публичное превью модели Gemini Embedding 2 — своей новой модели эмбеддингов, которая представляет собой важный шаг в развитии методов представления и извлечения информации машинами для различных типов медиаданных.
Если предыдущие модели эмбеддингов в основном ограничивались текстом, то эта новая модель изначально объединяет текст, изображения, видео, аудио и документы в единое цифровое пространство. Это позволяет снизить задержку до 70% для некоторых клиентов и сократить общие расходы для компаний, использующих ИИ-модели, работающие на основе их собственных данных для решения бизнес-задач.
Сэм Виттэвен (Sam Witteveen), соучредитель компании по обучению в сфере ИИ и машинному обучению Red Dragon AI и соавтор VentureBeat, получил ранний доступ к Gemini Embedding 2 и опубликовал на YouTube видео со своими впечатлениями. Посмотрите его ниже:
Кому и зачем нужна модель эмбеддингов?
Тем, кто сталкивался с термином «эмбеддинги» (embeddings) в дискуссиях об ИИ, но считает его слишком абстрактным, поможет аналогия с универсальной библиотекой.
В традиционной библиотеке книги упорядочены по метаданным: автору, названию или жанру. В «пространстве эмбеддингов» ИИ информация упорядочивается по идеям.
Представьте себе библиотеку, где книги расставлены не по десятичной классификации Дьюи, а по их «вайбу» или «сути». В такой библиотеке биография Стива Джобса физически перелетела бы через комнату, чтобы оказаться рядом с техническим руководством по компьютеру Macintosh. Поэма о закате устремилась бы к фотоальбому о тихоокеанском побережье, а весь тематически схожий контент сформировал бы красивые парящие «облака» из книг. По сути, именно это и делает модель эмбеддингов.
Модель эмбеддингов преобразует сложные данные — будь то предложение, фотография заката или фрагмент подкаста — в длинный список чисел, называемый вектором.
Эти числа представляют собой координаты на карте высокой размерности. Если два объекта «семантически» близки (например, фотография золотистого ретривера и текст «лучший друг человека»), модель размещает их координаты очень близко друг к другу на этой карте. Сегодня эти модели являются невидимым «движком» для:
-
Поисковых систем: поиска результатов на основе того, что вы имели в виду, а не только по конкретным введенным словам.
-
Рекомендательных систем: рекомендаций от Netflix или Spotify, потому что их «координаты» близки к тому, что вам уже нравится.
-
Корпоративного ИИ: крупные компании используют их для поисково-дополненной генерации (RAG), при которой ИИ-ассистент «просматривает» внутренние PDF-файлы компании, чтобы точно ответить на вопрос сотрудника.
Концепция сопоставления слов с векторами восходит к 1950-м годам благодаря таким лингвистам, как Джон Руперт Фирт, но современная «векторная революция» началась в начале 2000-х годов, когда команда Йошуа Бенжио впервые использовала термин «эмбеддинги слов» (word embeddings). Настоящим прорывом для индустрии стал Word2Vec, выпущенный в 2013 году командой Google под руководством Томаса Миколова. Сегодня на рынке лидирует горстка основных игроков:
-
OpenAI: известна своей популярной серией text-embedding-3.
-
Google: с новой моделью Gemini и предыдущими моделями Gecko.
-
Anthropic и Cohere: предоставляют специализированные модели для корпоративного поиска и рабочих процессов разработчиков.
Выходя за рамки текста в сторону изначально мультимодальной архитектуры, Google пытается создать единую карту для всей суммы человеческого цифрового выражения — текста, изображений, видео, аудио и документов, — разместив всё это в одном математическом пространстве.
Почему Gemini Embedding 2 — это так важно
Большинство ведущих моделей по-прежнему остаются «текстовыми». Если вам нужно выполнить поиск по видеоархиву, ИИ обычно должен сначала расшифровать видео в текст и только потом встроить этот текст в векторное пространство.
Модель Gemini Embedding 2 от Google является изначально мультимодальной.
Как написал в X Логан Килпатрик (Logan Kilpatrick) из Google DeepMind, модель позволяет разработчикам «объединить текст, изображения, видео, аудио и документы в едином пространстве эмбеддингов».
Она воспринимает аудио как звуковые волны, а видео — как движение напрямую, без необходимости предварительного перевода в текст. Это снижает количество ошибок «перевода» и позволяет улавливать нюансы, которые один лишь текст может упустить.
Для разработчиков и предприятий «изначально мультимодальная» природа Gemini Embedding 2 знаменует собой сдвиг в сторону более эффективных ИИ-пайплайнов.
Благодаря проецированию всех медиаданных в единое 3072-мерное пространство разработчикам больше не нужны раздельные системы для поиска по изображениям и тексту; они могут выполнять «межмодальный» (cross-modal) поиск — используя текстовый запрос для поиска определенного момента в видео или изображения, соответствующего определенному звуку.
В отличие от предшественников, Gemini Embedding 2 может обрабатывать запросы, объединяющие разные модальности. Разработчик может отправить запрос, содержащий одновременно изображение ретро-автомобиля и текст «Какой здесь тип двигателя?». Модель не обрабатывает их по отдельности; она воспринимает их как единую комплексную концепцию. Это обеспечивает гораздо более глубокое понимание реальных данных, где «смысл» часто кроется на пересечении того, что мы видим, и того, что мы говорим.
Одной из наиболее технических особенностей модели является матрешечное представление (Matryoshka Representation Learning). Названная в честь русских матрешек, эта техника позволяет модели «вкладывать» наиболее важную информацию в первые несколько чисел вектора.
Компания может использовать все 3072 измерения для максимальной точности или «обрезать» их до 768 или 1536 измерений, чтобы сэкономить на хранении данных в базе с минимальной потерь точности.
Бенчмарки прироста производительности при переходе к мультимодальности
Gemini Embedding 2 устанавливает новую планку производительности для мультимодальной глубины, в частности превосходя предыдущих лидеров отрасли в задачах оценки текста, изображений и видео.
Бенчмарки Google Gemini Embedding 2. Источник: Google
Наиболее существенное превосходство модели наблюдается в поиске по видео и аудио, где ее нативная архитектура позволяет обойти деградацию производительности, обычно присущую конвейерам текстовой транскрипции.
В частности, в задачах поиска «видео по тексту» и «текста по видео» модель демонстрирует измеримый разрыв в производительности по сравнению с существующими лидерами отрасли, точно сопоставляя движение и временные данные в едином семантическом пространстве.
Технические результаты показывают явное преимущество в следующих стандартизированных категориях:
-
Мультимодальный поиск: Gemini Embedding 2 стабильно превосходит ведущие текстовые и визуальные модели в сложных поисковых задачах, требующих понимания взаимосвязи между визуальными элементами и текстовыми запросами.
-
Глубина речи и аудио: Модель задает новый стандарт для нативных аудиоэмбеддингов, достигая более высокой точности в улавливании фонетического и тонального подтекста по сравнению с моделями, опирающимися на промежуточную текстовую расшифровку.
-
Контекстное масштабирование: В текстовых бенчмарках модель сохраняет высокую точность при использовании расширенного контекстного окна на 8192 токена, гарантируя, что длинные документы встраиваются с той же семантической плотностью, что и короткие отрывки.
-
Гибкость размерности: Тестирование по слоям матрешечного представления (MRL) показывает, что даже при усечении до 768 измерений модель сохраняет подавляющее большинство своей производительности в 3072 измерениях, превосходя модели с фиксированной размерностью аналогичного размера.
Что это значит для корпоративных баз данных
Для современного предприятия информация зачастую представляет собой фрагментированный хаос. Одна проблема клиента может включать записанный звонок техподдержки (аудио), скриншот ошибки (изображение), PDF-файл договора (документ) и цепочку писем (текст).
В прошлые годы поиск по этим форматам требовал четырех разных пайплайнов. С Gemini Embedding 2 компания может создать единую базу знаний (Unified Knowledge Base). Это делает возможным более продвинутую форму RAG, при которой внутренний ИИ компании не просто ищет факты, но понимает взаимосвязь между ними независимо от формата.
Ранние партнеры уже сообщают о резком росте эффективности:
-
Sparkonomy, платформа для экономики создателей контента, сообщила, что нативная мультимодальность модели сократила их задержки (лаг) на величину до 70%. Устранив необходимость в промежуточном «инференсе» LLM (этапе, на котором одна модель объясняет видео другой), они почти удвоили показатели семантического сходства при подборе брендов для авторов.
-
Everlaw, фирма в сфере юридических технологий, использует модель для навигации в «высокорисковой среде» судебного процесса. В судебных делах, где необходимо проанализировать миллионы записей, способность Gemini индексировать изображения и видео наряду с текстом позволяет юристам находить улики, которые традиционный текстовый поиск упустил бы.
Понимание ограничений
В своем анонсе Google открыто заявила о некоторых текущих ограничениях Gemini Embedding 2. Новая модель поддерживает векторизацию отдельных файлов, содержащих до 8192 текстовых токенов, 6 изображений (в одном пакете), 128 секунд видео (2 минуты 8 секунд), 80 секунд нативного аудио (1,34 минуты) и 6-страничный PDF-файл.
Важно уточнить, что это ограничения на ввод для одного запроса, а не предел того, что система может запомнить или сохранить.
Думайте об этом как о сканере. Если у сканера есть ограничение «одна страница за раз», это не значит, что вы можете отсканировать всего одну страницу за всю жизнь; это значит, что вам нужно подавать страницы по одной.
-
Размер отдельного файла: Вы не можете «встроить» 100-страничный PDF-файл за один вызов. Вы должны «разбить» документ на фрагменты по 6 страниц или менее и отправлять каждый фрагмент модели индивидуально.
-
Совокупные знания: Как только эти фрагменты конвертируются в векторы, они все могут сосуществовать в вашей базе данных. У вас может быть база данных, содержащая десять миллионов 6-страничных PDF-файлов, и модель сможет выполнять поиск по всем ним одновременно.
-
Видео и аудио: Аналогично, если у вас есть 10-минутное видео, вы разбиваете его на 128-секундные сегменты, чтобы создать доступную для поиска «временную шкалу» эмбеддингов.
Лицензирование, цены и доступность
По состоянию на 10 марта 2026 года Gemini Embedding 2 официально находится в публичном превью (Public Preview).
Для разработчиков и корпоративных лидеров это означает, что модель доступна для немедленного тестирования и внедрения в продакшн, хотя она все еще подлежит итеративным доработкам, типичным для программного обеспечения на стадии «превью», до того как она достигнет общей доступности (GA).
Модель развернута на двух основных шлюзах ИИ от Google, каждый из которых ориентирован на свой масштаб операций:
-
Gemini API: Нацелен на быстрое прототипирование и индивидуальных разработчиков, этот путь предлагает упрощенную структуру ценообразования.
-
Vertex AI (Google Cloud): Корпоративная среда, разработанная для масштабных задач, предлагающая продвинутые средства контроля безопасности и интеграцию с более широкой экосистемой Google Cloud.
Она также уже интегрирована с тяжеловесами ИИ-инфраструктуры: LangChain, LlamaIndex, Haystack, Weaviate, Qdrant и ChromaDB.
В Gemini API компания Google внедрила многоуровневую модель ценообразования, которая разделяет «стандартные» данные (текст, изображения и видео) и «нативное» аудио.
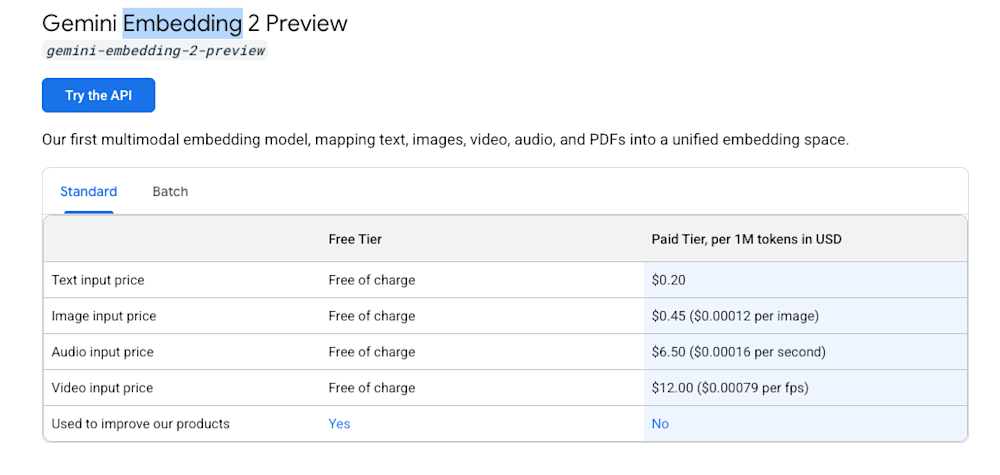
Цены на Gemini 2 Embedding в Google Gemini API. Источник: Google
-
Бесплатный тариф (Free Tier): Разработчики могут экспериментировать с моделью бесплатно, хотя этот тариф имеет ограничения по количеству запросов (обычно 60 запросов в минуту) и использует данные для улучшения продуктов Google.
-
Платный тариф (Paid Tier): Для объемов производственного уровня стоимость рассчитывается за миллион токенов. Для текстовых, графических и видеовходов тариф составляет $0,25 за 1 миллион токенов.
-
«Аудиопремиум» (Audio Premium): Поскольку модель изначально принимает аудиоданные без промежуточной транскрипции — что является более ресурсоемкой задачей, — тариф для аудиовходов удваивается и составляет $0,50 за 1 миллион токенов.
Для крупномасштабных развертываний на Vertex AI ценообразование следует корпоративной модели «оплаты по мере использования» (Pay-as-you-go, PayGo). Это позволяет организациям платить ровно за то, что они используют в различных режимах обработки:
-
Flex PayGo: Идеально подходит для непредсказуемых пиковых нагрузок.
-
Provisioned Throughput (Выделенная пропускная способность): Разработано для предприятий, которым требуются гарантированная емкость и стабильная задержка для приложений с высоким трафиком.
-
Batch Prediction (Пакетное прогнозирование): Идеально подходит для повторной индексации массивных исторических архивов, где требования к скорости ниже, но объемы чрезвычайно высоки.
Сделав модель доступной через эти разнообразные каналы и интегрировав ее с такими библиотеками, как LangChain, LlamaIndex и Weaviate, Google гарантировала, что «цена переключения» для бизнеса заключается не только в деньгах, но и в операционной легкости. Строит ли стартап свой первый ассистент на базе RAG или мультинациональная корпорация объединяет десятилетия разнородных медиаархивов — инфраструктура уже запущена и доступна по всему миру.
Кроме того, официальные блокноты Gemini API и Vertex AI Colab, содержащие код на Python, необходимый для реализации этих функций, лицензированы под лицензией Apache License, Version 2.0.
Лицензия Apache 2.0 высоко ценится в технологическом сообществе, поскольку она является «либеральной» (permissive). Она позволяет разработчикам брать код реализации Google, модифицировать его и использовать в собственных коммерческих продуктах без необходимости платить роялти или делать собственный проприетарный код «открытым» в ответ.
Как следует поступить предприятиям: мигрировать на Gemini 2 Embedding или нет?
Для директоров по данным (CDO) и технических руководителей решение о миграции на Gemini Embedding 2 сводится к переходу от стратегии «текст плюс» к «изначально мультимодальной» стратегии.
Если ваша организация в настоящее время полагается на фрагментированные пайплайны, где изображения и видео сначала расшифровываются или тегируются отдельными моделями перед индексацией, обновление, вероятнее всего, является стратегической необходимостью.
Эта модель устраняет «налог на перевод», возникающий при использовании промежуточных LLM для описания визуальных или звуковых данных. Партнеры вроде Sparkonomy обнаружили, что это сократило задержку до 70% при одновременном удвоении показателей семантического сходства. Для бизнеса, управляющего массивными и разнообразными наборами данных, это не просто прирост производительности; это структурное упрощение, сокращающее количество точек, где «смысл» может быть потерян или искажен.
Усилия по отказу от чисто текстовой основы оказываются ниже ожидаемых благодаря тому, что ранние пользователи называют отличной «непрерывностью API» (API continuity).
Поскольку модель интегрируется со стандартными для индустрии фреймворками, такими как LangChain, LlamaIndex и Vector Search, ее часто можно «встроить» в существующие рабочие процессы с минимальными изменениями кода. Однако реальные затраты времени и энергии заключаются в переиндексации. Переход на эту модель требует повторного создания эмбеддингов для существующего корпуса данных, чтобы гарантировать, что все точки данных находятся в одном 3072-мерном пространстве.
Хотя это разовое вычислительное препятствие, оно является обязательным условием для разблокировки межмодального поиска, при котором простой текстовый запрос может внезапно «заглянуть» в ваши видеоархивы или «услышать» конкретные настроения клиентов в записях звонков.
Главный компромисс, который предстоит взвесить руководителям по работе с данными — это баланс между высокоточным поиском и экономикой долгосрочного хранения. Gemini Embedding 2 решает эту проблему напрямую с помощью матрешечного представления (MRL), которое позволяет усекать векторы с 3072 измерений до 768 без линейного падения качества.
Это дает CDO тактический рычаг: вы можете выбрать максимальную точность для высокорисковых судебных или медицинских расследований (как в случае с 20-процентным ростом полноты поиска у Everlaw), используя при этом более мелкие и эффективные векторы для менее приоритетных рекомендательных движков, чтобы держать расходы на облачное хранилище под контролем.
В конечном счете, окупаемость (ROI) заключается в «приросте» точности. В условиях, когда ценность ИИ определяется его контекстом, возможность изначально индексировать 6-страничный PDF-файл или 128 секунд видео непосредственно в базе знаний обеспечивает такую глубину аналитики, которую чисто текстовые модели просто не могут воспроизвести.




