


ИИ-агенты, обученные на Databricks, не уступают по качеству ответов Claude и GPT-5.6 Luna, справляясь с задачами вдвое быстрее
Источник: VentureBeat · Sean Michael Kerner


Каждому агенту, выполняющему поиск по массиву документов, приходится решать, сколько поисковых запросов нужно сделать, прежде чем давать ответ.
Большинство инструментов агентного поиска заставляют делать выбор между двумя типами сбоев. Поиск, который останавливается слишком рано, пропускает вопросы, требующие многоэтапного логического анализа по разным документам. Поиск, который никогда не останавливается преждевременно, выполняет одинаковое количество шагов для каждого запроса, включая те простые, которым не требовалось больше одного.
В январе компания Databricks представила Instructed Retriever — архитектуру, которая, по заявлению Databricks, превосходит традиционный RAG (поиск с дополненной генерацией) до 70% на сложных корпоративных вопросах, требующих учета множества инструкций, благодаря использованию метаданных для логического вывода. Эта система создавалась для курируемого рабочего пространства, где команды определяли конкретный, более узкий набор документов и таблиц для поискового модуля. Такой масштаб сохранялся до тех пор, пока Databricks не подключила те же самые большие языковые модели к целому корпоративному рабочему пространству вместо специализированного.
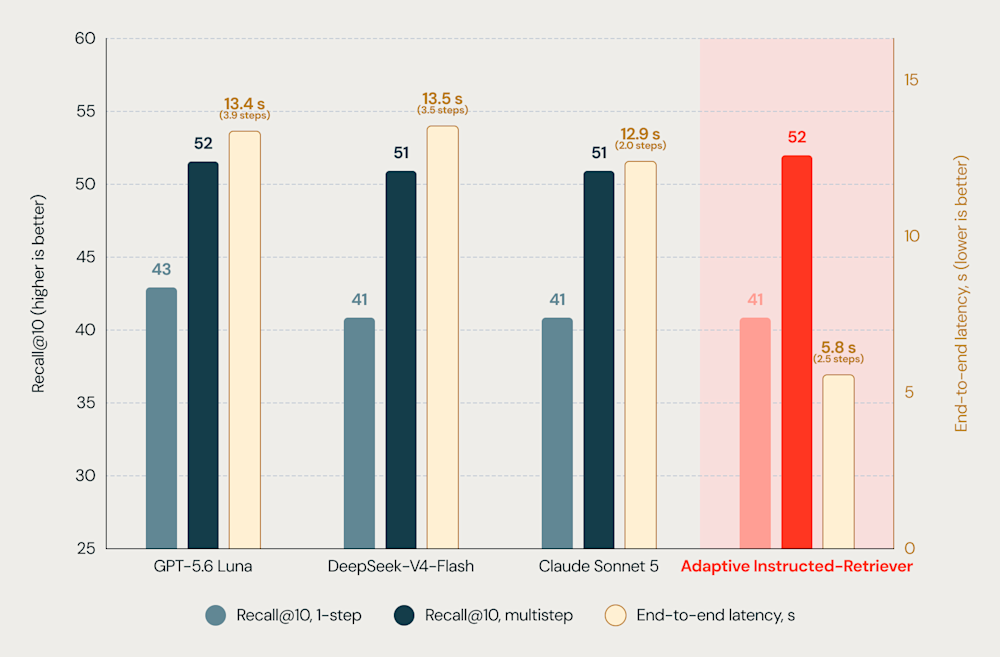
В опубликованном на этой неделе исследовании Databricks представила Adaptive Instructed-Retriever — модель извлечения данных, созданную для того, чтобы самостоятельно определять необходимое количество поисковых шагов перед запуском. Разница сводится к тому, в какой момент модель принимает решение об остановке. По данным Databricks, модель соответствует по качеству таким решениям, как Claude Sonnet 5, GPT-5.6 Luna и DeepSeek-V4-Flash, но при этом отвечает более чем в два раза быстрее — в среднем за 5,8 секунды. В одном из тестовых примеров из исследования она повторила двухэтапный поиск модели Sonnet по вопросу о клиентском аккаунте, обеспечив при этом на 50% более высокую полноту выдачи (recall). Эти показатели получены в ходе собственных тестов Databricks и не были независимо верифицированы.
«Первоначальная работа над Instructed Retriever, где рабочий процесс был довольно фиксированным, больше напоминала план запроса, поскольку мы фиксировали структуру того, как агент обращается к поисковой системе, — рассказал VentureBeat Майкл Бендерский (Michael Bendersky), директор по исследованиям в Databricks. — В данной конкретной работе мы отходим от этого подхода к более адаптивному, когда агент подстраивается под вопрос и меняет план в зависимости от него».
План запроса против адаптивного поиска
Традиционный план запроса к базе данных — это фиксированный набор шагов, которые база данных выполняет для обработки запроса, например, какой индекс сканировать или в каком порядке объединять таблицы. Один и тот же запрос каждый раз приводит к созданию одинакового плана. Бендерский напрямую использовал это сравнение.
«Настройка плана запроса была детерминированной и базировалась на правилах», — отметил он.
Adaptive Instructed-Retriever разделяет одну цель с планом запроса и расходится с ним в другой. «Он похож на план запроса в том смысле, что мы стараемся сделать агента как можно быстрее», — пояснил Бендерский. Разница заключается в том, как определяется эта скорость. «Он отличается тем, что процесс здесь на самом деле недетерминированный, то есть агент может пойти по одному пути для одного запроса и по совершенно другому пути для другого», — сказал он.
Самый наглядный пример того, почему эта гибкость имеет значение, — это то, что Бендерский называет многошаговыми (multi-hop) вопросами, для ответа на которые требуется несколько циклов поиска для сбора информации. В качестве примера можно привести вопрос о показателях выручки, которые распределены по двум разным документам. Ответ на него означает поиск первого документа, извлечение из него ссылки, а затем отправку второго поискового запроса на основе содержимого этого документа. Один поисковый проход не сможет найти нужную информацию, а фиксированный план находит ее только путем прогона каждого запроса через одинаковое количество шагов, независимо от того, были ли они нужны.
Два режима поиска и штраф за лишние шаги
В исследовании описаны два режима извлечения информации и метод обучения, который определяет, когда какой из них использовать.
Параллельное мышление. Система выдает несколько переписанных версий запроса одновременно, каждая из которых отправляется отдельным потоком, а результаты объединяются на уровне агента.
Последовательное мышление. Когда начальный набор извлеченных документов содержит подсказку, но не сам ответ, модель использует эту информацию для запуска второго раунда запросов, повторяя этот процесс до достижения заданного лимита шагов.
Штраф за шаги. Databricks обучила модель с помощью обучения с подкреплением в режиме реального времени, используя метод, который она называет CISPO (Clipped Importance Sampling Policy Optimization — оптимизация политики с усеченной оценкой важности методом выборки по значимости). «Мы обучаем агента искать больше, но только тогда, когда это необходимо, — сказал Бендерский. — Мы используем штраф, который балансирует время, затрачиваемое на поиск, с вознаграждением за нахождение правильных документов».
Меньше шагов, чем у Claude, GPT-5.6 Luna и DeepSeek — и дело не только в скорости
Сравнение в исследовании проводится не с другими продуктами для поиска. Оно ведется с передовыми моделями (frontier models), выполняющими ту же поисковую задачу. Регулируя силу штрафа за шаги во время обучения, исследователи получили не одну фиксированную модель, а целое семейство контрольных точек (checkpoints), каждая из которых занимает определенную позицию на кривой «качество — задержка». Согласно исследованию, каждая контрольная точка на этой кривой превосходит Claude Sonnet 5, GPT-5.6 Luna и DeepSeek-V4-Flash во всем диапазоне протестированных бюджетов на поиск.
В исследовании приводится еще один пример прямого сравнения. На вопрос о том, отразила ли компания расходы на реструктуризацию в конкретной строке отчета о прибылях и убытках, все три модели достигли идеального показателя полноты (recall). Adaptive Instructed-Retriever справилась с этим за два поисковых шага — на один меньше, чем Claude Sonnet 5, и на два меньше, чем GPT-5.6 Luna, которая перед подтверждением отсутствия таких расходов искала спекулятивные фразы вроде «подобных расходов не было».
Databricks представляет эти результаты как доказательство того, что небольшая специализированная модель может соответствовать точности передовых моделей в узкой поисковой задаче, не прибегая к помощи более крупной модели общего назначения.
Источник: Databricks
Более быстрый поиск не исправляет плохой контекст
Тайминг совпадает с более серьезной проблемой, над решением которой все еще работают компании. Проведенный VB Pulse в июле 2026 года опрос 101 квалифицированного предприятия показал, что 68% респондентов за последние шесть месяцев сталкивались с тем, что уверенный, но неверный ответ ИИ-агента был вызван отсутствием или несогласованностью бизнес-контекста (в июне этот показатель составлял 57%). Поиск по документам остается наиболее распространенным способом предоставления такого контекста для предприятий — он является основным источником для 31% респондентов.
Более быстрый поиск сам по себе не устраняет этот разрыв. Правильность ответов по-прежнему остается главным критерием, по которому компании оценивают агентов, даже несмотря на то, что критерии выбора смещаются в сторону контроля доступа и простоты загрузки данных, а не точности поиска. Количество шагов, которые система делает для получения ответа, — это один вопрос. А то, опирается ли этот ответ на последовательно определенный бизнес-контекст, — совершенно другой.




