


Cohere Parse 5 оптимизирует расходы на синтаксический анализ документов
Источник: VentureBeat · Sean Michael Kerner


Предприятия, пытающиеся загрузить PDF-файлы, презентации и отсканированные документы в конвейеры искусственного интеллекта, постоянно сталкиваются с одной и той же проблемой: инструменты либо не распознают структуру — таблицы, графики, макет, — либо обходятся слишком дорого при масштабировании.
В четверг компания Cohere выпустила Parse 5, сделав ставку на соотношение цены и производительности, а не на абсолютную точность — это оптимальный баланс стоимости и возможностей для масштабирования на уровне предприятий. Parse 5 представляет собой визуально-языковую модель с 2,3 миллиарда параметров, созданную для преобразования PDF-файлов, презентаций и изображений в структурированный Markdown в масштабах предприятий.
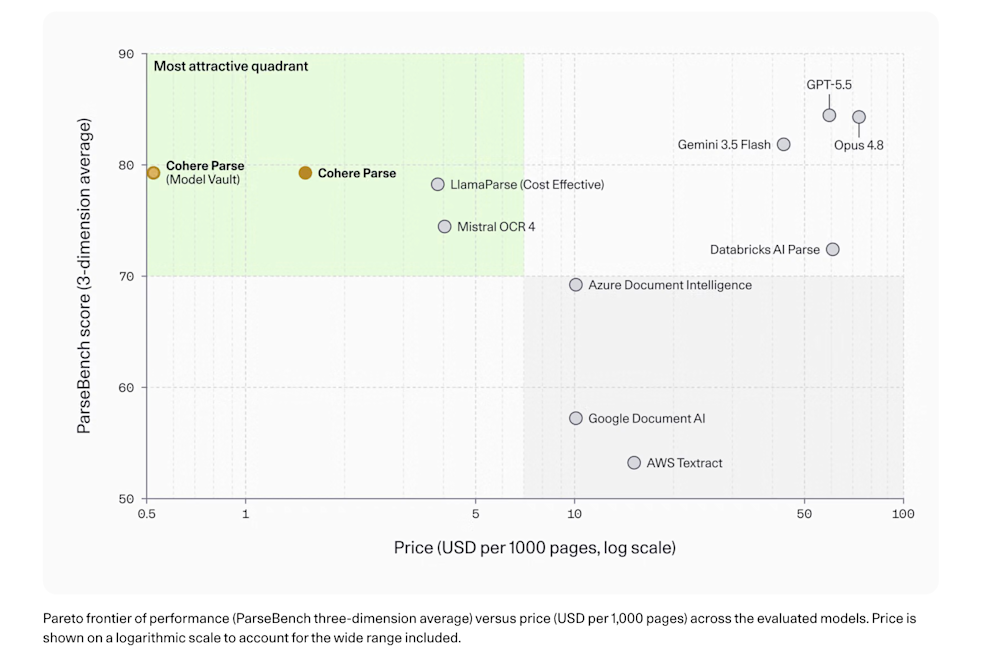
Опубликованный самой Cohere бенчмарк показывает, что по точности Parse 5 уступает трем более крупным универсальным передовым моделям. GPT-5.5, Opus 4.8 и Gemini 3.5 Flash набирают больше баллов, чем Parse, по всем трем параметрам ParseBench, представленным в отчете Cohere. Cohere не претендует на первое место по баллам. Она заявляет о лучшей цене за результат, близкий к максимальному. Компания оценила модель в 1,50 доллара за 1000 страниц при использовании через API, а для развертывания с большими объемами доступна Model Vault — защищенная платформа Cohere с единой арендной платой для управляемого инференса.
«Парсинг документов все еще нельзя назвать решенной задачей, потому что сложнее всего не прочитать текст, а сохранить структуру и смысл», — рассказал VentureBeat Нильс Реймерс (Nils Reimers), вице-президент по направлению AI Search в Cohere. «В корпоративных документах смешиваются таблицы, схемы, диаграммы и форматирование, которые меняют интерпретацию данных. Большинство инструментов по-прежнему разрушают структуру или галлюцинируют контент, и даже передовые модели дают сбой на страницах со сложным макетом».
Особенности однопроходной архитектуры
Parse 5 обрабатывает страницу как изображение, пропускает ее через один этап работы визуально-языковой модели и возвращает структурированный Markdown, объединяя в один шаг конвейер из OCR и отдельной модели, который большинство инструментов выполняют по отдельности.
Архитектура. Это визуально-языковая модель с 2,3 миллиарда параметров, созданная на базе архитектуры North-Micro-Vision-Instruct от Cohere Labs, с контекстным окном на 8192 токена и размером примерно 4,6 гигабайта. Она принимает страницу PDF, PowerPoint или JPEG в виде изображения, закодированного в base64, и возвращает Markdown в порядке чтения, причем таблицы выводятся в формате HTML, а также предоставляются описания изображений и координаты ограничивающих рамк (bounding boxes) для таблиц и картинок.
Поддерживаемые языки. Стабильная точность обеспечивается для арабского, английского, французского, немецкого, итальянского, японского, корейского, португальского и испанского языков, в то время как для других языков поддерживается режим zero-shot с более низкой точностью.
Режимы вывода. По умолчанию выводится одна строка Markdown на страницу. Режим блоков (blocks) возвращает типизированные элементы, где каждая таблица содержит собственный HTML-код, ограничивающую рамку и описание. Именно этот формат, по мнению Cohere, обеспечивает возможность отслеживания на уровне цитирования для агентов.
Доступность. Parse 5 теперь доступна повсеместно через Cohere API, Model Vault, Microsoft Foundry и AWS SageMaker.
Бенчмарк демонстрирует компромисс, а не победу
ParseBench — это бенчмарк, который оценивает инструменты парсинга документов на основе проверенных людьми корпоративных страниц. Cohere сообщает, что Parse 5 набирает 79,2 балла по трем измерениям: таблицы, достоверность контента и семантическое форматирование. Это ставит Parse 5 позади GPT-5.5 (84,4), Opus 4.8 (84,3) и Gemini 3.5 Flash (81,8), но впереди экономичного уровня LlamaParse (78,3), Mistral OCR 4 (74.5), Databricks AI Parse (72,4) и Azure Document Intelligence (69,3).
Источник: Cohere
В примечаниях к таблице Cohere указывает два исключенных измерения — «Макет» (Layout) и «График» (Chart), объясняя это рамками продукта, а не пробелами в производительности. Parse 5 возвращает Markdown в порядке чтения вместо ограничивающих рамок для каждого отдельного текстового элемента и описывает графики, а не извлекает их исходные данные (извлечение данных из графиков запланировано в будущей версии).
Реймерс отметил, что такое проектное решение отражает реальные точки сбоя в агентских рабочих процессах.
«Что касается графиков, например, мы предоставляем общее описание графика вместе с указателем, чтобы агентский ИИ мог визуально изучить график», — пояснил Реймерс. «Другие решения пытаются извлечь данные из графика, но при этом упускают критически важную информацию (например, цвет или рисунок линии), что приводит к галлюцинациям в чате и приложениях агентского ИИ».
Стоимость — это то, в чем Cohere видит свое главное преимущество. Реймерс сослался на рабочий процесс, который компания смоделировала для крупной фирмы финансовых услуг.
«Мы произвели расчеты для крупного рабочего процесса в финансовой сфере, который обрабатывает 750 миллионов документов в год, и показали, что выбор Parse 5 вместо крупной универсальной модели, такой как GPT-5.5, позволил бы сократить расходы более чем на 98 процентов».
Эта цифра является собственной оценкой Cohere для одного смоделированного рабочего процесса, а не результатом независимого аудита развертывания.
Какое место занимает Parse 5 среди конкурентов
Предприятия, ищущие решения для парсинга, имеют огромный выбор.
Универсальные передовые модели — GPT-5.5, Opus 4.8 и Gemini 3.5 Flash — лидируют по точности, но требуют затрат и задержек, характерных для крупных моделей, на каждой странице.
Существуют и специализированные парсеры, включая Mistral OCR 4, LlamaParse, а также решения с открытыми весами, такие как Chandra OCR 2 и dots.mocr от RedNote.
Сервисы интеллектуальной обработки документов от крупных облачных провайдеров (гиперскейлеров) — AWS Textract, Google Document AI, Azure Document Intelligence и Databricks AI Parse — конкурируют скорее за счет удобства экосистемы, чем за счет качества чистого парсинга, и набирают наименьшее количество баллов в собственном сравнении Cohere.
Кевин Петри (Kevin Petrie), вице-президент по исследованиям в BARC US, отметил, что парсинг документов находится в самом центре внедрения корпоративного искусственного интеллекта.
«Мы сейчас завершаем исследование, которое показывает, что анализ документов является главным вариантом использования ИИ с огромным отрывом: уровень внедрения составляет 62% среди опрошенных нами организаций», — рассказал Петри изданию VentureBeat. «Документы и другие неструктурированные объекты, включая изображения и т.д., содержат проприетарный контекст, необходимый организациям для дифференциации их инициатив в области агентского ИИ».
Петри добавил, что только время покажет, как соотношение цены и производительности Cohere проявит себя по сравнению с передовыми моделями, однако со стратегической точки зрения он считает подход Cohere верным.
Стефани Вальтер (Stephanie Walter), руководитель направления AI Stack в HyperFRAME Research, считает, что Cohere Parse 5 занимает удачную нишу между устаревшими системами OCR и использованием дорогостоящих передовых моделей для каждой страницы.
«Его потенциальное преимущество заключается в обеспечении структуры, пространственного происхождения и возможности развертывания в закрытом контуре по цене, подходящей для высоконагруженного приема данных», — сказала Вальтер изданию VentureBeat. «Ему не обязательно побеждать в каждом бенчмарке. Ему нужно сделать надежный парсинг корпоративного уровня экономичным».
Главная проверка происходит на последующих этапах, а не в бенчмарках
«Парсинг — это первый качественный барьер в стеке корпоративного ИИ», — говорит Вальтер. «Если таблицы, заголовки, изображения или порядок чтения теряются при загрузке, более качественные эмбеддинги и более крупные модели не смогут восстановить эту утраченную структуру».
Оценка в бенчмарке — не единственный важный фактор в данном случае. «Предприятиям следует тестировать парсеры на своих самых сложных документах и измерять точность последующего поиска и выполнения задач, а не то, насколько чисто выглядит извлеченный текст», — считает Вальтер. «Правильный вопрос звучит не так: „Прочитал ли он PDF?“, а так: „Может ли агент теперь правильно использовать эту информацию?“»




