


85% компаний, обошедшихся на ошибках ИИ, спешат сократить людей, которые могли бы предотвратить следующую
Источник: VentureBeat · Carl Franzen


Предприятия, которые уже обожглись на том, что ИИ-агент успешно прошел внутреннее тестирование, но затем дал сбой в продакшене, еще быстрее стремятся исключить человека из процессов принятия решений о развертывании, а не замедляют этот процесс — несмотря на то, что доверие к автоматической оценке в целом растет, показывает новое исследование VB Pulse.
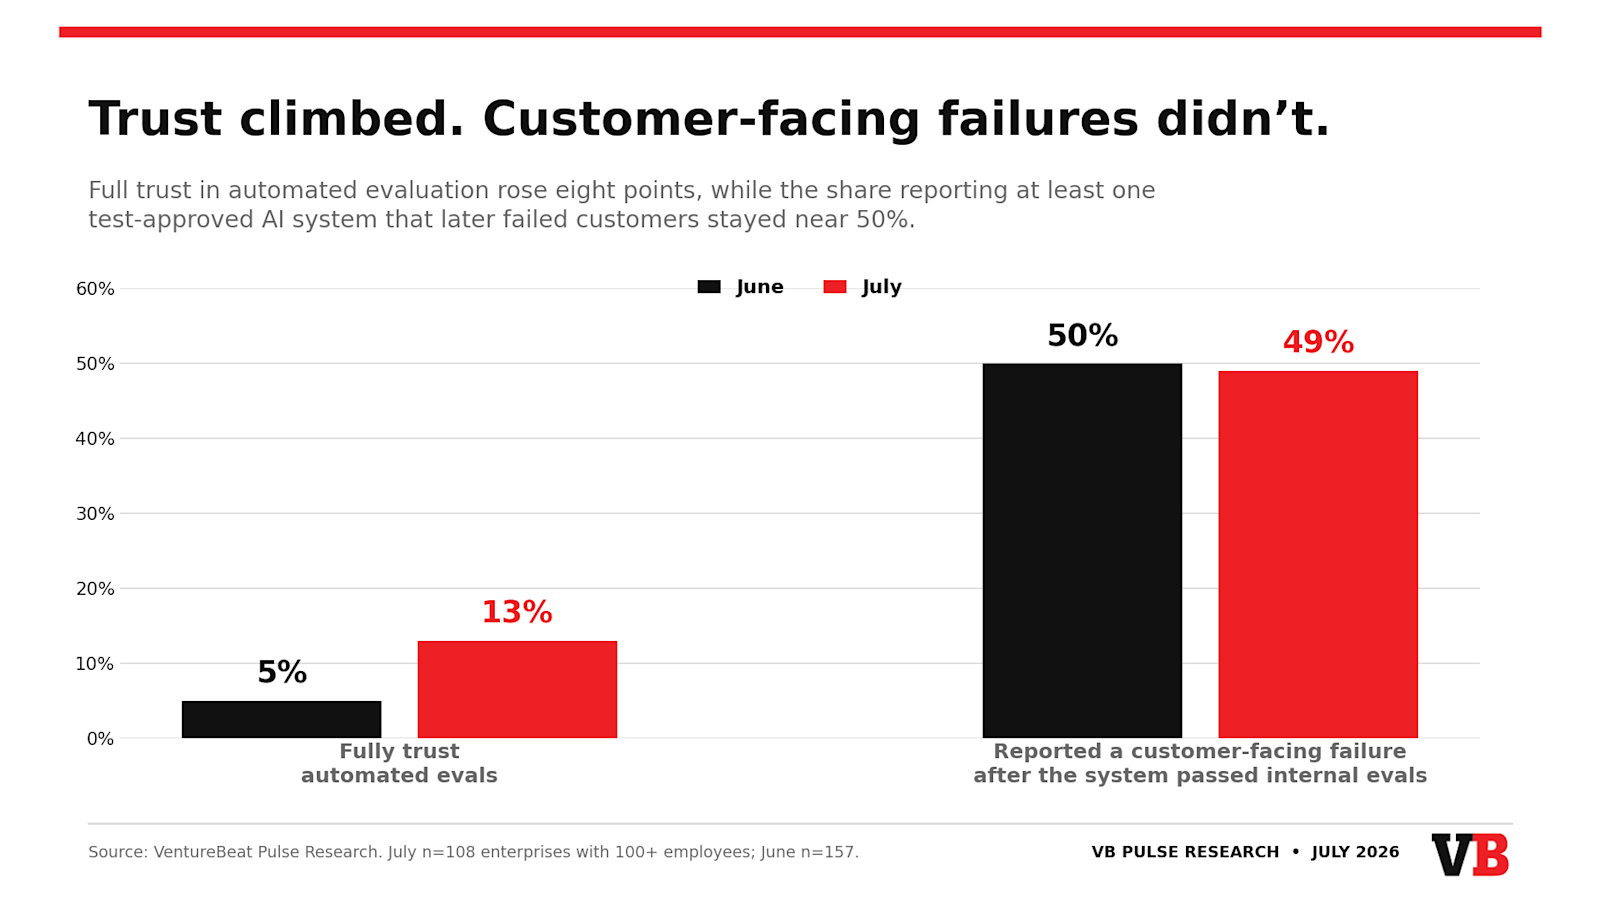
В июле 13% из 108 опрошенных предприятий заявили, что доверяют автоматической оценке, по сравнению с всего лишь 5% в предыдущем месяце. Между тем, доля респондентов, которые считают плохую согласованность между тестами и реальными результатами своей главной проблемой, снизилась на 10 пунктов — с 29% до 19% за месяц.
Тем не менее, 49% респондентов сообщили, что ИИ-агент или функция на базе LLM, успешно прошедшие внутреннее тестирование компании, впоследствии создали проблему, заметную для клиентов. Этот показатель практически не изменился по сравнению с июнем (50%). А почти четверть респондентов (24%) заявили, что подобные неприятные инциденты происходили более одного раза.
Последние результаты исследования VentureBeat Intelligence выявили более тревожную фазу внедрения корпоративных агентов: разрыв больше не ограничивается лишь соотношением между уровнем автономии, которую компании предоставляют агентам, и их способностью проверять результаты. Все чаще это разрыв между уверенностью в уровне оценки и свидетельствами того, что этот уровень действительно лучше справляется с предотвращением сбоев.
Самое показательное разделение обнаруживается при анализе июльских данных.
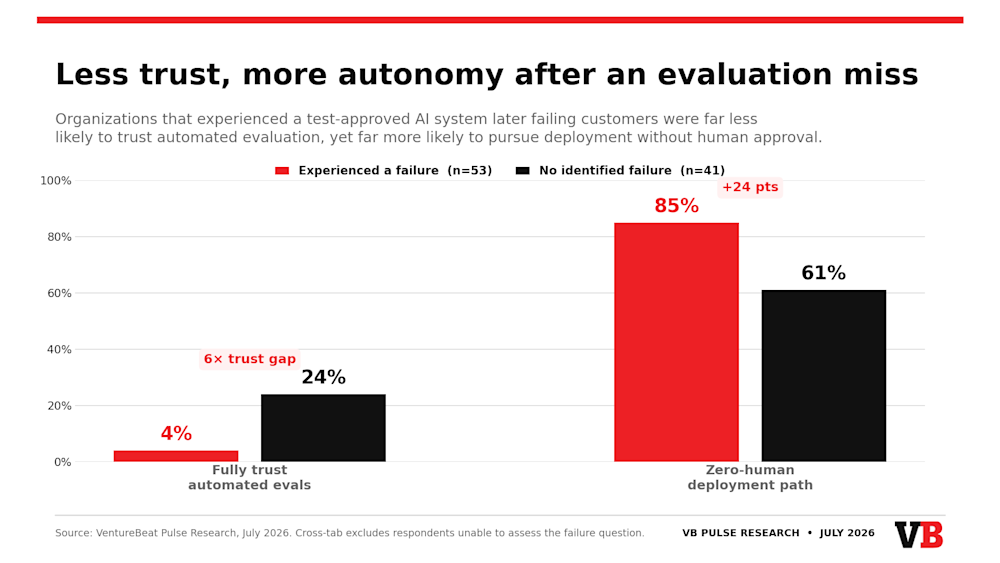
Среди предприятий, столкнувшихся с тем, что ИИ-функция прошла тестирование, но в итоге разочаровала клиента, лишь 4% полностью доверяют автоматическим проверкам. Среди тех, у подобных инцидентов не было, полную уверенность выразили 24% — шестикратная разница.
Это логично: те, кто столкнулся с прохождением тестов агентами, которые затем дали сбой в «живом» продакшене, вполне ожидаемо с большей долей скептицизма относятся к процессу автоматической проверки.
Возможно, вполне закономерно и то, что компании, нацеленные на решение этой проблемы — например, платформа мониторинга и устранения ошибок автоматических агентов Raindrop.ai — видят, как рынок стремительно меняется всего за несколько месяцев.
«Мы наблюдаем закат традиционных методов оценки (evals) в их привычном понимании», — рассказал технический директор Raindrop Бен Халак в личном сообщении VentureBeat. «Компании из списка Fortune 100 все чаще сокращают наборы тестов и снижают приоритет их обслуживания. По мере того как системы становятся все сложнее (MCP, субагенты и т.д.), полностью перечислить все возможные сценарии сбоев становится невозможно. Вместо этого они полагаются на решения для обнаружения аномалий и проблем как до, так и после этапа продакшена».
Направленный срез, а не полная перепись рынка
VentureBeat провела июльский опрос среди 108 человек, представляющих компании с численностью штата не менее 100 сотрудников. Это меньше по сравнению со 157 респондентами в июне.
Из 108 участников 69% охарактеризовали себя как лиц, принимающих окончательные решения о покупке ИИ, либо как специалистов, которые рекомендуют такие покупки и влияют на них. Выборка смещена в сторону средних предприятий: 63% работали в компаниях с численностью от 100 до 2499 сотрудников.
Полученные результаты следует воспринимать как показатель общих тенденций. Опрос формировался на основе самоотбора участников, а не вероятностной выборки, кроме того, группы респондентов, разделившиеся на «обжегшихся» и «необжегшихся» (упоминаемые по ходу статьи), насчитывают от 41 до 53 человек, в то время как другие перекрестные срезы в отчете охватывают от 40 до 68 человек.
Состав отраслей также изменился: доля представителей технологического сектора и сферы программного обеспечения снизилась на девять пунктов и составила 14%, в то время как доля ритейла и сферы потребительских товаров увеличилась на четыре пункта и достигла 19%.
Тем не менее, в отчете выделяются четыре изменения от месяца к месяцу, на которые стоит обратить внимание: больше респондентов заявляют о полной уверенности, меньше — называют проблему несоответствия реальным условиям, больше участников выбирают простоту интеграции в качестве решающего фактора при покупке, а Braintrust укрепляет свои позиции в качестве основной платформы.
Уверенность в автоматических оценках выросла, но результаты остались прежними
В июньском исследовании VentureBeat был выявлен разрыв в корпоративной оценке: компании наделяли агентов большей автономностью быстрее, чем разрабатывали надежные способы их тестирования.
В июле ключевой показатель первой волны сохранился. По результатам 265 корпоративных ответов за два месяца, доля сообщивших хотя бы об одной системе, которая успешно прошла тесты, но разочаровала клиентов, осталась в пределах одного процентного пункта: 50% в июне и 49% в июле.
Источник: VentureBeat Intelligence Agentic Reliability & Evaluations Pulse Tracker, июль 2026 г.
Этот показатель не означает, что 49% всех запусков агентов завершаются неудачей или что какой-то конкретный продукт для оценки имеет показатель отказов в 49%. Опрос задает вопрос о том, сталкивалась ли организация хотя бы с одним инцидентом, с которым столкнулись пользователи за последний год, после того как ИИ-функция прошла внутренние тесты. Компании, развертывающие гораздо больше агентов, имеют больше возможностей столкнуться с подобным инцидентом.
Но это ограничение не умаляет важности результата. Внутренняя оценка служит контрольным этапом перед релизом. Если примерно половина опрошенных организаций сталкивалась с тем, что этот этап одобрял систему, которая впоследствии давала сбой на глазах у клиентов, проходной балл нельзя рассматривать как доказательство надежности в продакшене.
Перекрестный анализ подтверждает этот вывод. Десять из 41 предприятия, у которых не было зафиксировано пропущенных тестированием сбоев, полностью доверились автоматизации.
Лишь два из 53 предприятий, ранее имевших негативный опыт, заявили о том же. Уверенность сильнее всего среди респондентов, у которых меньше всего свидетельств того, что релизный контроль может давать сбои.
Предприятия, которые уже обожглись, быстрее движутся к полностью автономному развертыванию
Контр интуитивный вывод заключается в том, как компании поступают после сбоя оценки.
В целом, 67% либо позволяют агенту выкатывать код или изменять систему без одобрения человека в определенных сценариях с низким уровнем риска, либо модифицируют свои рабочие процессы (пайплайны), чтобы внедрить эту практику в течение предстоящего года. Этот показатель не изменился по сравнению с июнем. В июле 37% уже разрешали это в ограниченных случаях, а еще 30% находились на этапе внедрения такого подхода.
Однако среди предприятий, где система, прошедшая тестирование, разочаровала клиента, 85% придерживались модели работы без необходимости утверждения, по сравнению с 61% в группе, не сообщавшей о подобных инцидентах. Лишь 11% респондентов из числа «обжегшихся» отвергли сквозную автоматизацию развертывания на ближайшие годы, в то время как среди не столкнувшихся с проблемами этот показатель составил 24%.
Источник: VentureBeat Intelligence Agentic Reliability & Evaluations Pulse Tracker, июль 2026 г.
Было бы просто счесть это безрассудством, но данные подтверждают и другое правдоподобное объяснение: зрелость развертывания. Организации, запускающие больше агентов в больших объемах и для более критически важных рабочих процессов, с большей вероятностью и сталкиваются со сбоями, и обладают инженерной инфраструктурой, необходимой для автоматизированного развертывания.
Данные опроса не позволяют однозначно определить, какое именно объяснение является преобладающим. Однако они доказывают, что инцидент, видимый клиентам, похоже, не останавливает движение к автономности. Респонденты, имеющие наглядные доказательства того, что тестирование может пропускать дефекты, также активнее всего стремятся позволить этим тестам санкционировать изменения в продакшене.
Если частота сбоев при развертывании остается прежней, в то время как объем развертываний растет, общее количество инцидентов может увеличиться даже без роста процента затронутых компаний. Июльские данные не измеряют объем инцидентов, поэтому это остается риском, вытекающим из закономерности, а не измеренным результатом.
Шлюз релизов автоматизирован, но мониторинг качества в продакшене все еще отстает
Оценка перед развертыванием и мониторинг продакшена отвечают на разные вопросы. Оценка спрашивает, готов ли агент к выпуску. Мониторинг продакшена спрашивает, что агент делает после релиза и остаются ли его результаты в реальном времени корректными.
Большинство компаний в июльской выборке по-прежнему делают акцент на том, функционирует ли система, а не на том, правилен ли ответ.
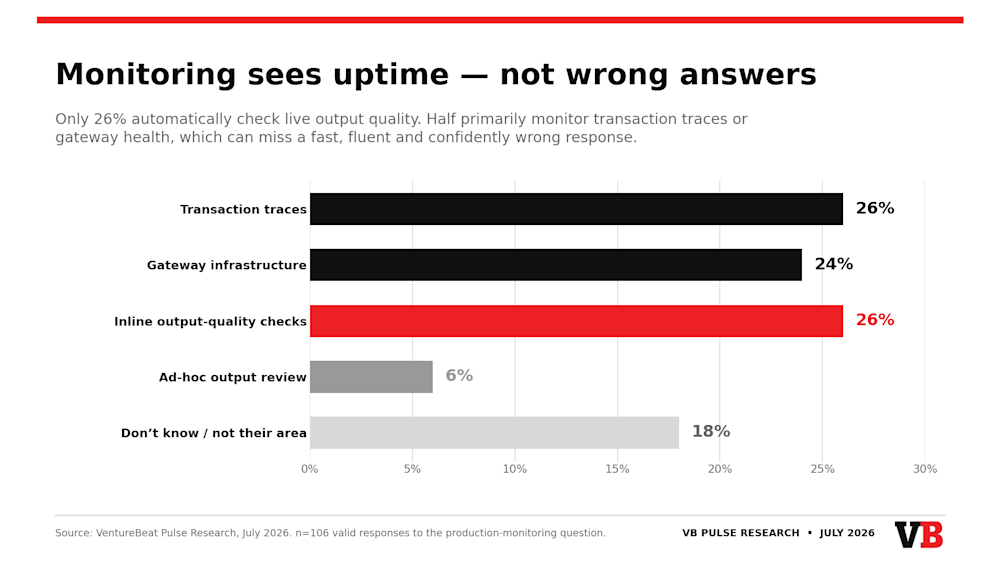
Среди 106 действительных ответов на этот вопрос 26% использовали встроенные проверки качества — автоматизированные валидаторы или защитные барьеры, проверяющие реальный трафик на предмет проблем с качеством ответов. Еще 26% сосредоточились на трассировках транзакций, таких как инфраструктурные спаны, использование токенов и необработанные входные и выходные данные, в то время как 24% в основном отслеживали метрики шлюзов, такие как задержка, ошибки и стоимость.
Источник: VentureBeat Intelligence Agentic Reliability & Evaluations Report Pulse Tracker July 2026
Данные трассировок и шлюзов могут выявить сбои, замедления и прерванные запросы. Они могут не зафиксировать беглый, быстрый и уверенно неверный ответ. Если сгруппировать данные в отчете по тому, за чем фактически следит каждая архитектура, половина респондентов отслеживала работоспособность агента, в то время как чуть более четверти автоматически отслеживали корректность его работы в продакшене.
Этот разрыв наиболее очевиден среди 40 респондентов, которые уже разрешают развертывание без одобрения в ограниченных случаях. Лишь 28% этой группы автоматически проверяли смысл и корректность ответов в реальном времени. Другими словами, большинство предприятий, исключивших человека по крайней мере из некоторых решений о релизах, не установили автоматизированный мониторинг семантического качества в качестве защитного барьера в продакшене.
Это самый наглядный операционный урок, извлеченный из данных. Набор тестов перед развертыванием и наблюдаемость инфраструктуры необходимы, но они не покрывают тот же тип сбоев. Предприятиям нужен способ обнаружения некорректных ответов после того, как агент начинает взаимодействовать с реальными пользователями, данными и инструментами, особенно когда никто предварительно не проверяет решение о развертывании.
Начинает формироваться независимый рынок оценки агентов
Данные о вендорах дают более обнадеживающий сигнал: предприятия добавляют специализированные инструменты оценки, и профильные платформы набирают обороты.
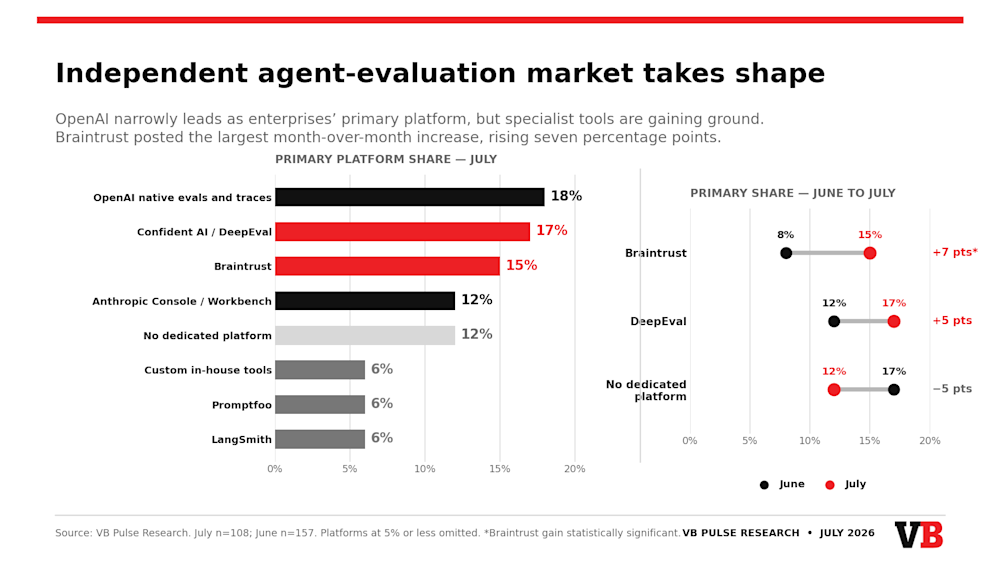
Собственные средства оценки и трассировки от OpenAI выбились в лидеры в качестве основной платформы с 18%, за ними следуют DeepEval от Confident AI (17%) и Braintrust (15%).
Claude Console и Workbench от Anthropic заняли 12%, разделив позицию с организациями, сообщившими об отсутствии выделенной платформы оценки. По 6% набрали три варианта: инструменты собственной разработки, Promptfoo и LangSmith.
Источник: VentureBeat Intelligence Agentic Reliability & Evaluations Pulse Tracker July 2026
Доля Braintrust в качестве основного инструмента выросла с 8% в июне до 15% в июле — это самый большой прирост среди отдельных вендоров, который отчет отмечает как статистически значимый. Доля DeepEval выросла с 12% до 17%. Использование платформ общего назначения сократилось на пять пунктов до 12%, хотя само по себе это меньшее изменение не подтверждает тенденцию.
Поскольку многие компании используют более одного инструмента, общие показатели шире. Собственная оценка OpenAI присутствовала в 31% стеков, DeepEval — в 27%, Braintrust — в 22%, а собственные инструменты Anthropic — в 20%. Кастомные внутренние инструменты достигли 14%, в то время как Weights & Biases Weave и открытая система Langfuse набрали по 11%.
Это показатели внедрения, а не оценки производительности продуктов. Опрос не доказывает, что один вендор производит более надежных агентов, чем другой. Тем не менее, результаты указывают на то, что оценка становится отдельным уровнем корпоративного программного обеспечения, а не набором разрозненных внутренних скриптов или функцией, используемой только внутри платформы провайдера моделей.
Вместе с этим рынком меняются и приоритеты закупок. Доля тех, кто выбрал простоту интеграции в качестве решающего фактора, выросла на 12 пунктов и составила 39%, вытеснив стоимость, которая снизилась с 28% до 23%. Точность оценки заняла второе место с 28%. Совокупный средний показатель удовлетворенности, простоты внедрения и экономической ценности составил 3,9 из пяти.
Переход от цены к интеграции говорит о том, что предприятия все чаще хотят получить инструмент, который они могут установить в существующие конвейеры разработки и мониторинга прямо сейчас. Тем не менее, их главным критерием успеха остается стабильность оценки (38%), за которой следуют меньшее количество сбоев и регрессий (20%). Покупатели выбирают инструмент по степени соответствия, оценивая результаты по их воспроизводимости.
Намерение сменить платформу также осхло: 56% по-прежнему рассчитывают добавить или заменить платформу в течение следующего года по сравнению с 64% в июне.
Доля тех, кто остался при своем мнении, увеличилась на восемь пунктов, достигнув 44%. В сочетании с внедрением специализированных решений это говорит о том, что некоторые покупатели переходят от этапа оценки к этапу реализации.
Проверка человеком становится страховкой от автоматических промахов
Данные о бюджетах показывают, как предприятия справляются с противоречием между большей автономией и ненадежной оценкой.
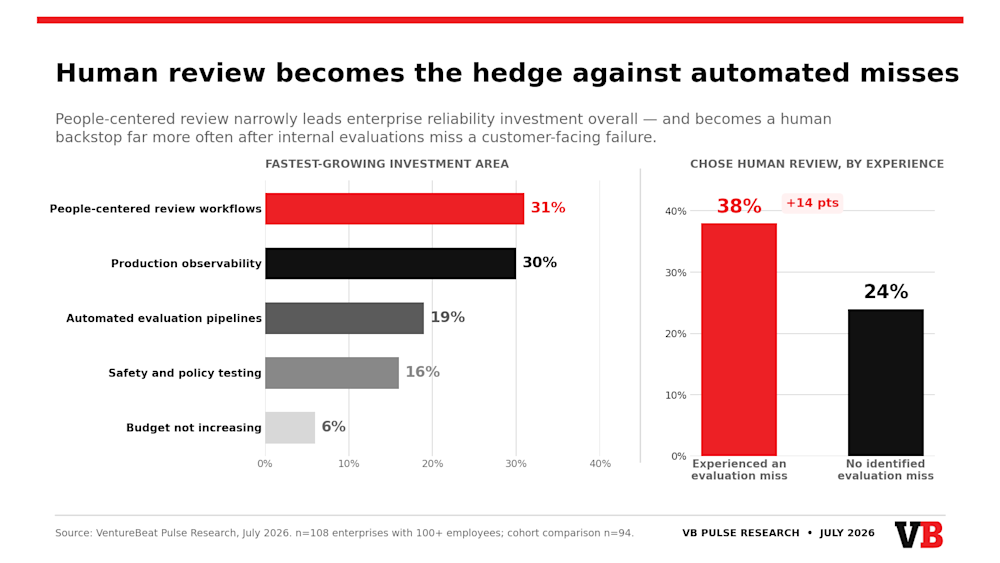
Рабочие процессы проверки с участием человека едва опередили наблюдаемость продакшена в качестве наиболее часто упоминаемой области для увеличения инвестиций (31% против 30%).
Источник: VentureBeat Intelligence Agentic Reliability & Evaluations Pulse Tracker July 2026
Конвейеры автоматизированной оценки заняли третье место с 19%, за ними следует тестирование на безопасность и соответствие политикам (16%). Лишь 6% заявили, что их бюджет на надежность и оценку не увеличивается.
Среди предприятий, столкнувшихся со сбоями при тестировании, 38% заявили, что проверка с участием человека получит наиболее быстрый рост инвестиций, по сравнению с 24% организаций, которые с этим не сталкивались.
Это порождает кажущийся парадокс: пострадавшая группа с наибольшей вероятностью исключает людей из контрольных точек релиза и с наибольшей вероятностью увеличивает расходы на людей на других этапах процесса. Стратегия, судя по всему, заключается в автоматизации с «человеческой страховкой» — позволить агентам двигаться быстрее, а затем использовать рецензентов для выявления того, что пропустила автоматизированная оценка.
Открытым остается вопрос о масштабируемости этой модели. Развертывание агентов и автоматические проверки могут расти вместе с объемом программного обеспечения. Часы работы рецензентов не сокращаются с той же скоростью. Таким образом, предприятия могут заменять этап утверждения человеком на более масштабную функцию последующей проверки, а не устранять человеческий контроль.
Краткий, но важный вывод
Июльские данные не показывают, что оценка корпоративных агентов повсеместно терпит неудачу, и не доказывают, что автоматизированные валидаторы становятся хуже. Они показывают кое-что более точное: уверенность выросла до того, как улучшились показатели частоты сбоев.
В то же время инфраструктура вокруг оценки зреет. Все больше предприятий внедряют специализированные инструменты, интеграция стала главным критерием покупки, а компании, уже столкнувшиеся со сбоями, увеличивают инвестиции в проверки с участием людей. Рынок осознает проблему и направляет на ее решение средства.
Но главный результат в отношении надежности остается неутешительным. Почти половина опрошенных предприятий по-прежнему сообщают, что та или иная функция ИИ проходила внутренние проверки, прежде чем разочаровать клиента. Респонденты с таким опытом меньше доверяют автоматизации и быстрее переходят к развертыванию систем без участия человека.
В отчете это преподносится как неполная модель верификации: успешный результат перед развертыванием знаменует собой начало мониторинга, а не его завершение. На большинстве предприятий проверки качества в рабочей среде и оценочное тестирование, которые могли бы устранить этот разрыв, до сих пор не внедрены.




