


Детерминированные процессоры бросают вызов спекулятивному выполнению команд
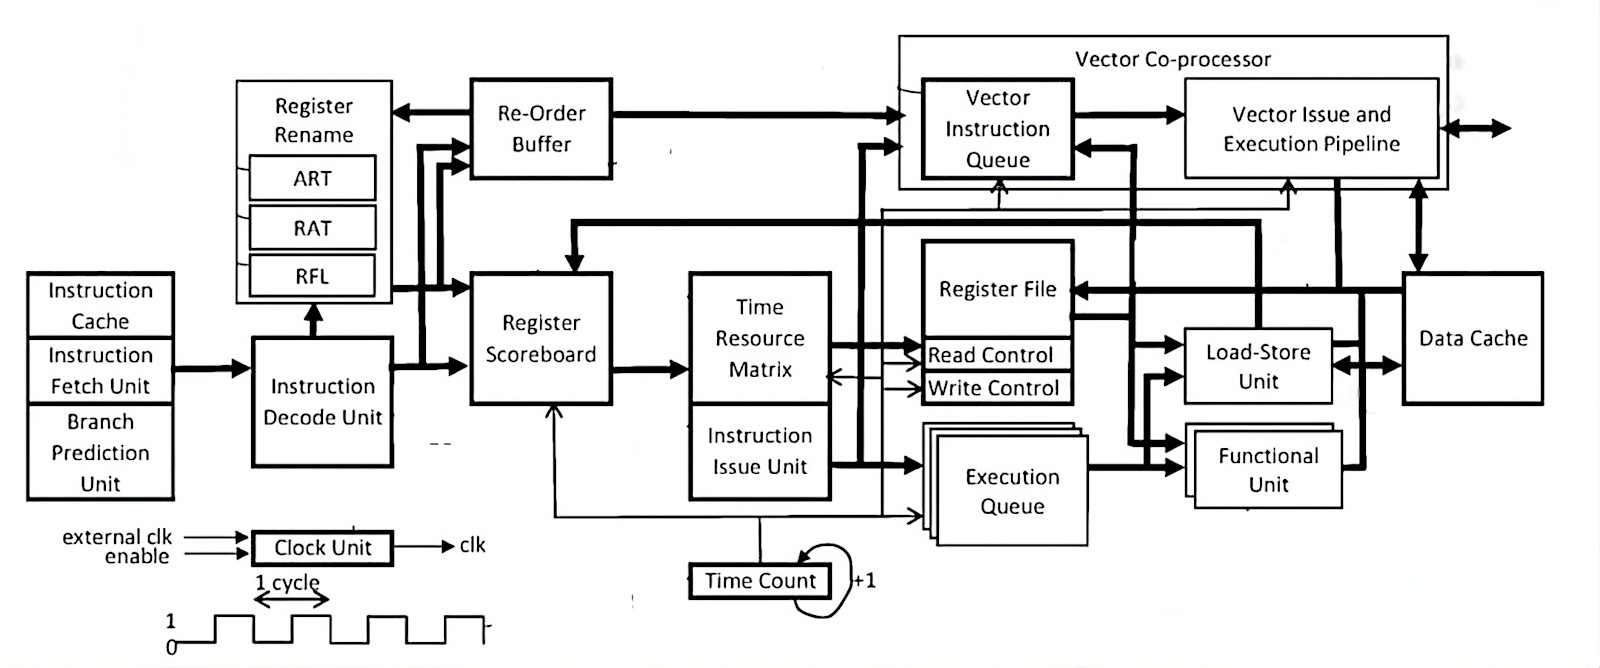


Более трех десятилетий современные процессоры полагались на спекулятивное выполнение, чтобы конвейеры не простаивали. Когда оно появилось в 1990-х годах, спекулятивные вычисления приветствовались как прорыв — точно так же, как конвейеризация и суперскалярное исполнение в предыдущие десятилетия. Каждое из этих решений знаменовало собой поколенческий скачок в микроархитектуре. Предсказывая результаты ветвлений и обращений к памяти, процессоры могли избегать простоев и обеспечивать постоянную загрузку вычислительных блоков.
Но за этот архитектурный сдвиг пришлось заплатить: энергия растрачивалась впустую при неверных предсказаниях, выросла сложность, появились такие уязвимости, как Spectre и Meltdown. Эти проблемы подготовили почву для альтернативы: детерминированной модели выполнения на основе времени. Как отмечал Дэвид Паттерсон в 1980 году, «RISC потенциально выигрывает в скорости просто за счет более простой конструкции». Принцип простоты Паттерсона лежит в основе новой альтернативы спекулятивным вычислениям: детерминированной модели выполнения, основанной на времени».
Впервые с тех пор, как спекулятивное выполнение стало доминирующей парадигмой, был изобретен принципиально новый подход. Этот прорыв воплощен в серии из шести недавно выданных патентов США, которые с легкостью прошли экспертизу в Ведомстве по патентам и товарным знакам США (USPTO). В совокупности они представляют радикально иную модель выполнения инструкций. Резко отличаясь от традиционных спекулятивных методов, эта новая детерминированная структура заменяет догадки механизмом, основанным на времени и устойчивым к задержкам. Каждой инструкции назначается точный слот выполнения в конвейере, что приводит к строго упорядоченному и предсказуемому потоку выполнения. Эта переосмысленная модель по-новому определяет, как современные процессоры могут справляться с задержками и параллелизмом с большей эффективностью и надежностью.
Простой счетчик времени используется для детерминированного определения точного времени выполнения инструкций в будущем. Каждая инструкция направляется в очередь выполнения с заранее заданным временем выполнения, которое рассчитывается на основе разрешения ее зависимостей по данным и доступности ресурсов — шин чтения, исполнительных блоков и шины записи в файл регистров. Каждая инструкция остается в очереди до тех пор, пока не наступит запланированный для нее слот выполнения. Этот новый детерминированный подход может стать первым серьезным архитектурным вызовом спекулятивным вычислениям с момента, когда они стали стандартом.
Архитектура естественным образом распространяется на матричные вычисления, при этом предложение по набору инструкций RISC-V в настоящее время обсуждается сообществом. Настраиваемые модули матричного умножения общего вида (GEMM), размером от 8×8 до 64×64, могут работать с операндами на основе регистров или с прямым доступом к памяти (DMA). Эта гибкость поддерживает широкий спектр рабочих нагрузок искусственного интеллекта и высокопроизводительных вычислений (HPC). Предварительный анализ показывает масштабируемость, которая не уступает ядрам TPU от Google, при значительно меньших затратах и требованиях к энергопотреблению.
Вместо прямого сравнения с процессорами общего назначения более точным ориентиром являются векторные и матричные движки: традиционные процессоры по-прежнему зависят от спекуляций и предсказания ветвлений, тогда как эта разработка применяет детерминированное планирование непосредственно к GEMM и векторным модулям. Такая эффективность проистекает не только из настраиваемых блоков GEMM, но и из модели выполнения на основе времени, где инструкции декодируются и им назначаются точные слоты выполнения на основе готовности операндов и доступности ресурсов.
Выполнение никогда не является случайным или эвристическим выбором среди множества кандидатов, а представляет собой предсказуемый, заранее спланированный поток, который поддерживает непрерывную загрузку вычислительных ресурсов. Запланированные матричные тесты обеспечат прямое сравнение с реализациями TPU GEMM, подчеркивая способность обеспечивать производительность дата-центр-класса без накладных расходов дата-центр-класса.
Критики могут утверждать, что статическое планирование вносит задержку в выполнение инструкций. На самом деле эта задержка уже существует — в виде ожидания зависимостей по данным или выборки из памяти. Обычные процессоры пытаются скрыть ее с помощью спекуляций, но когда предсказания не оправдываются, возникающий сброс конвейера приводит к задержкам и пустой трате энергии.
Подход со счетчиком времени учитывает эту задержку и детерминированно заполняет ее полезной работой, избегая откатов. Как отмечается в первом патенте, инструкции сохраняют эффективность внеочередного выполнения: «Микропроцессор со счетчиком времени для статической диспетчеризации инструкций обеспечивает выполнение на основе прогнозируемого времени, а не спекулятивного выпуска и восстановления», с заданным временем выполнения, но без накладных расходов на переименование регистров или спекулятивные компараторы.
Почему спекулятивные вычисления зашли в тупик
Спекулятивное выполнение повышает производительность за счет прогнозирования результатов до того, как они станут известны — выполнения инструкций заранее и их отбрасывания, если предположение оказалось неверным. Хотя этот подход может ускорить рабочие нагрузки, он также привносит непредсказуемость и неэффективность энергопотребления. Неправильные предсказания внедряют «No-Op» (пустые операции) в конвейер, останавливая прогресс и тратя энергию на работу, которая так и не завершается.
Эти проблемы усугубляются в современных рабочих нагрузках искусственного интеллекта и машинного обучения (ИИ/МО), где доминируют векторные и матричные операции, а шаблоны доступа к памяти носят нерегулярный характер. Длинные выборки, некэшируемые загрузки и несогласованные векторы часто вызывают сбросы конвейера в спекулятивных архитектурах.
Результатом являются провалы производительности, которые сильно варьируются в зависимости от наборов данных и размеров задач, что делает последовательную оптимизацию практически невозможной. Хуже того, побочные эффекты спекулятивных вычислений обнажили уязвимости, которые привели к громким эксплойтам безопасности. По мере роста интенсивности данных и перегрузки систем памяти спекулятивные вычисления с трудом поспевают за ними, подрывая свое первоначальное обещание бесшовного ускорения.
Временное исполнение и детерминированное планирование
В основе этого изобретения лежит векторный сопроцессор со счетчиком времени для статической диспетчеризации инструкций. Вместо того чтобы полагаться на спекуляции, инструкции выдаются только тогда, когда зависимости по данным и окна задержек полностью известны. Это устраняет догадки и дорогостоящие сбросы конвейера, сохраняя при этом преимущества пропускной способности внеочередного выполнения. Архитектуры, построенные на этой запатентованной основе, имеют глубокие конвейеры — обычно охватывающие 12 этажей — в сочетании с широкими интерфейсами предварительной выборки, поддерживающими до 8 путей декодирования, и большими буферами переупорядочивания, превышающими 250 элементов.
Как показано на рисунке 1, архитектура на верхнем уровне повторяет традиционный процессор RISC-V, где этапы выборки и декодирования инструкций передают данные в исполнительные блоки. Инновация заключается в интеграции счетчика времени и таблицы регистров (скорборда), стратегически расположенных между модулями выборки/декодирования и векторными исполнительными блоками. Вместо того чтобы полагаться на спекулятивные компараторы или переименование регистров, они используют таблицу регистров и матрицу временных ресурсов (TRM) для детерминированного планирования инструкций на основе готовности операндов и доступности ресурсов.
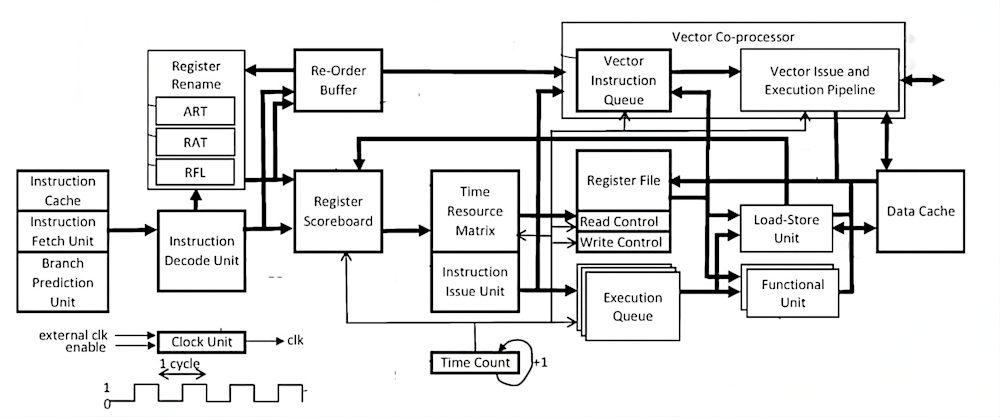
Рисунок 1: Упрощенная блок-схема детерминированного процессора. Счетчик времени и таблица регистров находятся между блоками выборки/декодирования и векторными исполнительными блоками, гарантируя выдачу инструкций только тогда, когда операнды готовы.
Типичная программа, выполняемая на детерминированном процессоре, начинается так же, как и на любой обычной системе RISC-V: инструкции выбираются из памяти и декодируются для определения того, являются ли они скалярными, векторными, матричными или пользовательскими расширениями. Разница проявляется в момент диспетчеризации. Вместо того чтобы выдавать инструкции спекулятивно, процессор использует цикло-точный счетчик времени, работающий совместно с таблицей регистров, чтобы точно определить, когда может быть выполнена каждая инструкция. Этот механизм обеспечивает детерминированный контракт выполнения, гарантируя завершение инструкций в предсказуемые циклы и сокращая количество пустых слотов выдачи.
В сочетании с таблицей регистров матрица «время-ресурсы» связывает инструкции с циклами выполнения, позволяя процессору детерминированно планировать диспетчеризацию по доступным ресурсам. Таблица отслеживает готовность операндов и информацию о конфликтах, позволяя планировать работу без переименования регистров или спекулятивных компараторов. Отслеживая такие зависимости, как чтение после записи (RAW) и запись после чтения, она гарантирует разрешение конфликтов без дорогостоящих сбросов конвейера. Как отмечается в патенте, «в многопоточном микропроцессоре счетчик времени и таблица регистров позволяют осуществлять перепланирование в обход промахов кэша, сбросов ветвления и конфликтов RAW без спекулятивного отката».
Как только операнды готовы, инструкция направляется в соответствующий исполнительный блок. Скалярные операции используют стандартные арифметико-логические устройства (АЛУ), в то время как векторные и матричные инструкции выполняются в широких исполнительных блоках, подключенных к большому векторному файлу регистров. Поскольку инструкции запускаются только тогда, когда условия безопасны, эти блоки остаются высокозагруженными без пустой работы или циклов восстановления, вызванных ошибочно предсказанными спекуляциями.
Ключевым фактором этого подхода является простой счетчик времени, который координирует выполнение в соответствии с готовностью данных и доступностью ресурсов, гарантируя, что инструкции продвигаются вперед только тогда, когда операнды готовы и ресурсы доступны. Тот же принцип применим к операциям с памятью: интерфейс прогнозирует окна задержек для операций чтения и записи, позволяя процессору заполнять эти слоты независимыми инструкциями и поддерживать непрерывный поток выполнения.
Различия в модели программирования
С точки зрения программиста, рабочий процесс остается привычным — код RISC-V компилируется и выполняется обычным образом. Ключевое отличие заключается в контракте выполнения: вместо того чтобы полагаться на динамические спекуляции для сокрытия задержки, процессор гарантирует предсказуемое время диспетчеризации и завершения. Это устраняет провалы производительности и пустую трату энергии на спекуляции, обеспечивая при этом преимущества пропускной способности внеочередного выполнения.
Эта перспектива подчеркивает, как детерминированное выполнение сохраняет привычную модель программирования RISC-V, одновременно устраняя непредсказуемость и ненужные усилия при спекуляциях. Как выразился Джон Хеннесси: «Глупо выполнять во время выполнения работу, которую можно сделать во время компиляции» — высказывание, отражающее основы RISC и его дальновидную философию проектирования.
Набор инструкций (ISA) RISC-V предоставляет опкоды для пользовательских инструкций и расширений, включая операции с плавающей запятой, DSP и векторные операции. В результате получается процессор, который выполняет инструкции детерминированно, сохраняя при этом преимущества внеочередной производительности. Устраняя спекуляции, конструкция упрощает аппаратное обеспечение, снижает энергопотребление и позволяет избежать сбросов конвейера.
Этот прирост эффективности становится еще более значительным при выполнении векторных и матричных операций, где широкие исполнительные модули требуют стабильной загрузки для достижения пиковой производительности. Векторные расширения требуют широких файлов регистров и крупных исполнительных модулей, что в спекулятивных процессорах влечет за собой дорогостоящее переименование регистров для восстановления после неверных предсказаний ветвлений. В детерминированной конструкции векторные инструкции выполняются только после фиксации (commit), что устраняет необходимость в переименовании.
Каждая инструкция планируется относительно цикло-точного счетчика времени: «Счетчик времени обеспечивает детерминированный контракт выполнения, гарантируя завершение инструкций в предсказуемые циклы и сокращая количество пустых слотов выдачи». Таблица векторных регистров разрешает зависимости по данным до выдачи инструкций в конвейер выполнения. Инструкции диспетчеризуются в известном порядке в правильном цикле, что делает выполнение одновременно предсказуемым и эффективным.
Векторные исполнительные блоки (целочисленные и с плавающей запятой) подключаются напрямую к большому векторному файлу регистров. Поскольку инструкции никогда не сбрасываются, накладные расходы на переименование отсутствуют. Таблица регистров обеспечивает безопасный доступ, а счетчик времени синхронизирует выполнение с готовностью памяти. Специальный блок памяти прогнозирует цикл возврата загружаемых данных. Вместо того чтобы простаивать или строить предположения, процессор планирует независимые инструкции в слоты задержки, поддерживая загрузку исполнительных блоков. «Векторный сопроцессор со счетчиком времени для статической диспетчеризации инструкций обеспечивает высокую загрузку широких исполнительных блоков, избегая при этом штрафов за ошибочные предсказания».
В современных процессорах компиляторы и программисты пишут код, предполагая, что аппаратное обеспечение будет динамически переупорядочивать инструкции и спекулятивно выполнять ветвления. Аппаратное обеспечение справляется с конфликтами с помощью переименования регистров, предсказания ветвлений и механизмов восстановления. Программисты получают прирост производительности, но ценой непредсказуемости и повышенного энергопотребления.
В детерминированной архитектуре, основанной на времени, инструкции выдаются только тогда, когда счетчик времени указывает на готовность их операндов. Это означает, что компилятору (или среде выполнения) не нужно вставлять защитный код для восстановления после неверных предсказаний. Вместо этого планирование компилятора становится проще, поскольку гарантируется выдача инструкций в правильном цикле без откатов. Для программистов ISA остается совместимой с RISC-V, но детерминированные расширения снижают зависимость от спекулятивных страховочных механизмов.
Применение в ИИ и МО
В ядрах ИИ/МО векторные загрузки и матричные операции часто доминируют во время выполнения. На спекулятивном процессоре несогласованные или некэшируемые загрузки могут вызывать простои или сбросы, лишая питания широкие векторные и матричные блоки и тратя энергию на отброшенную работу. Детерминированная конструкция вместо этого выполняет эти операции с цикло-точной точностью, обеспечивая высокую загрузку и стабильную пропускную способность. Для программистов это означает меньше провалов производительности и более предсказуемое масштабирование при изменении размеров задач. А поскольку патенты расширяют набор инструкций RISC-V, а не заменяют его, детерминированные процессоры остаются полностью совместимыми с профилем RVA23 и основными цепочками инструментов, такими как GCC, LLVM, FreeRTOS и Zephyr.
На практике детерминированная модель не меняет того, как пишется код — это по-прежнему ассемблер RISC-V или языки высокого уровня, скомпилированные в инструкции RISC-V. Меняется контракт выполнения: вместо того чтобы полагаться на спекулятивные догадки, программисты могут ожидать предсказуемого поведения задержек и более высокой эффективности без необходимости настройки кода под микроархитектурные особенности.
Индустрия находится в поворотной точке. Рабочие нагрузки ИИ/МО доминируют в векторной и матричной математике, где преуспевают графические и тензорные процессоры (GPU и TPU), но лишь за счет потребления огромной мощности и добавления архитектурной сложности. Напротив, процессоры общего назначения, все еще привязанные к моделям спекулятивного выполнения, отстают.
Детерминированный процессор обеспечивает предсказуемую производительность в широком спектре рабочих нагрузок, гарантируя стабильное поведение независимо от сложности задачи. Устранение спекулятивного выполнения повышает энергоэффективность и позволяет избежать ненужных вычислительных накладных расходов. Кроме того, детерминированная архитектура естественным образом масштабируется до векторных и матричных операций, что делает ее особенно хорошо подходящей для рабочих нагрузок искусственного интеллекта, которые опираются на высокопроизводительный параллелизм. Этот новый детерминированный подход может стать следующим подобным скачком: первым серьезным архитектурным вызовом спекуляциям с тех пор, как сами спекулятивные вычисления стали стандартом.
Заменят ли детерминированные процессоры спекулятивные вычисления в основных вычислениях? Это еще предстоит выяснить. Но с учетом выданных патентов, доказанной новизны и растущего давления со стороны рабочих нагрузок ИИ, наступил подходящий момент для смены парадигмы. В совокупности эти достижения сигнализируют о том, что детерминированное выполнение станет следующим архитектурным скачком, переосмысливающим производительность и эффективность точно так же, как когда-то это сделали спекулятивные вычисления.
Спекулятивные вычисления ознаменовали собой последнюю революцию в проектировании процессоров; детерминизм вполне может стать следующей.
Тханг Чан — основатель и технический директор Simplex Micro.
Читайте другие материалы наших приглашенных авторов. Или подумайте о том, чтобы отправить свою собственную статью! Ознакомьтесь с нашими рекомендациями здесь.
Добро пожаловать в сообщество VentureBeat!
Наша программа гостевых публикаций — это площадка, где технические эксперты делятся идеями и предоставляют нейтральные, независимые глубокие обзоры по вопросам ИИ, инфраструктуры данных, кибербезопасности и других передовых технологий, формирующих будущее бизнеса.
Читайте далее в рамках нашей программы гостевых публикаций и ознакомьтесь с нашим руководством, если вы заинтересованы в написании собственной статьи!




