


EmbeddingGemma от Google расширяет возможности ИИ наустройстве


Google открывает исходный код Gemma — эта компактная модель изначально создана для работы на таких устройствах, как смартфоны. Тем не менее, Google продолжает расширять семейство моделей Gemma и оптимизировать их для локального использования на телефонах и ноутбуках.
Новейшая модель компании, EmbeddingGemma, бросает вызов существующим корпоративным моделям встраивания (embedding models), выделяясь среди большинства большим количеством параметров и высокими результатами в бенчмарках. EmbeddingGemma — это модель с открытым исходным кодом на 300 миллионов токенов-параметров, которая оптимизирована для таких устройств, как ноутбуки, настольные ПК и мобильные гаджеты.
EmbeddingGemma, созданная на базе архитектуры Gemma 3, обучена более чем на 100 языках.
Мин Чой (Min Choi), продакт-менеджер, и Сахил Дуа (Sahil Dua), ведущий научный сотрудник-разработчик в Google DeepMind, написали в блоге, что EmbeddingGemma «предлагает настраиваемые размерности вывода» и будет работать с их открытой моделью Gemma 3n. Она интегрируется с такими инструментами, как Ollama, llama.cpp, MLX, LiteRT, LMStudio, LangChain, LlamaIndex и Cloudflare.
«Разработанная специально для локального ИИ (on-device AI), ее высокоэффективная архитектура с 308 миллионами параметров позволяет создавать приложения с использованием таких методов, как генерация с дополненным поиском (RAG) и семантический поиск, которые работают прямо на вашем оборудовании», — отметили Чой и Дуа. — «Она обеспечивает конфиденциальные высококачественные векторные представления (эмбеддинги), которые функционируют где угодно, даже без подключения к интернету».
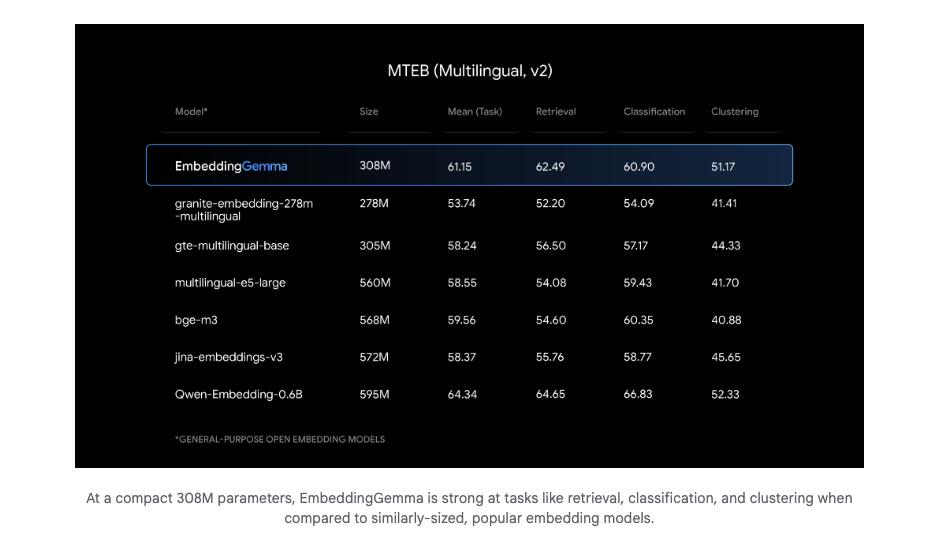
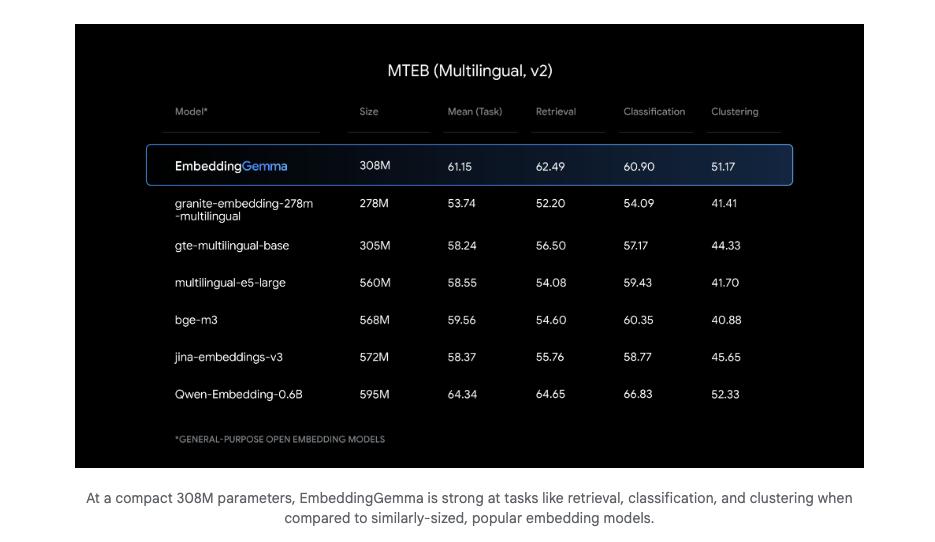
Модель показала отличные результаты в мультиязычном бенчмарке Massive Text Embedding Benchmark (MTEB) v2, который оценивает возможности моделей встраивания. Это модель с самым высоким рейтингом среди решений с числом параметров менее 500 млн.
Мобильный RAG
Важным сценарием использования EmbeddingGemma является разработка мобильных пайплайнов RAG и внедрение семантического поиска. RAG опирается на модели встраивания, которые создают числовые представления данных, к которым могут обращаться модели или агенты для ответа на запросы.
Большинство пайплайнов RAG выполняются не на ноутбуках или телефонах, а в облачных или локальных инфраструктурах. Создание мобильного RAG-пайплайна позволяет собирать информацию и отвечать на запросы непосредственно на локальных устройствах. Сотрудники могут задавать вопросы или управлять агентами со своих телефонов и других устройств, чтобы находить нужные сведения.
Интерес к запуску ИИ-приложений непосредственно на устройствах растет: появляются инструменты для создания мобильных ИИ-приложений и модели, работающие «на железе», такие как новая разработка Liquid AI — LFM2-VL. Такие компании, как Apple, Samsung и Qualcomm, борются за интеграцию аппаратного и программного обеспечения, способного запускать ИИ-модели на портативных устройствах без ущерба для времени автономной работы.
Чой и Дуа рассказали, что EmbeddingGemma эффективно создает качественные эмбеддинги. Они пояснили, что RAG-пайплайны состоят из двух ключевых этапов: извлечение релевантного контекста и генерация ответов на его основе.
«Чтобы этот RAG-пайплайн был эффективным, качество начального этапа извлечения критически важно. Некачественные эмбеддинги приведут к выбору нерелевантных документов, что выльется в неточные или бессмысленные ответы. Именно здесь раскрывается производительность EmbeddingGemma: она обеспечивает высококачественные представления, необходимые для работы точных и надежных локальных приложений», — подчеркнули Чой и Дуа.
Для этого в EmbeddingGemma применен метод под названием Matryoshka Representation Learning (обучение матрёшечных представлений). Это придает модели гибкость, поскольку она способна обеспечивать несколько размеров эмбеддингов в рамках одной модели. Например, разработчики могут использовать полный 768-мерный вектор, на который способна EmbeddingGemma, или уменьшить его до меньших размеров для ускорения работы.
Растущий рынок моделей встраивания
Растущее распространение RAG в корпоративной среде также привело к повышенному интересу к моделям встраивания. На самом деле EmbeddingGemma — не единственная модель такого типа от Google. В июле компания выпустила Embedding Gemini.
Cohere уже выпустила четвертую итерацию своей модели встраивания — Cohere Embed 4. У французской компании Mistral есть Codestral Embed, у OpenAI — Text Embedding 3 Large, а компания Qodo представила Qodo-Embed-1-1.5B.
Перспектива внедрения RAG и встраивания ИИ непосредственно на устройства вдохновляет многих разработчиков.




