


Jamba 3B от AI21 расширяет возможности искусственного интеллекта на периферийных устройствах


Компания AI21 Labs пополнила ряды разработчиков компактных корпоративных моделей, сделав ставку на то, что запуск искусственного интеллекта на клиентских устройствах поможет разгрузить трафик в центрах обработки данных.
Jamba Reasoning 3B от AI21 — это «крошечная» модель с открытым исходным кодом, способная выполнять расширенные логические рассуждения, генерировать код и отвечать на основе достоверных данных. Jamba Reasoning 3B поддерживает контекст более чем в 250 000 токенов и может выполнять инференс на периферийных устройствах.
В компании сообщили, что Jamba Reasoning 3B работает на таких устройствах, как ноутбуки и мобильные телефоны.
Ори Гошен (Ori Goshen), сооснователь и генеральный директор AI21, рассказал изданию VentureBeat, что компания видит все больше сценариев применения небольших моделей в корпоративном секторе, главным образом потому, что перенос большей части инференса на устройства разгружает дата-центры.
«То, что мы сейчас наблюдаем в индустрии — это экономическая проблема: строительство дата-центров обходится очень дорого, а доходы, которые они приносят, по сравнению со скоростью амортизации всех этих чипов показывают, что дебет с кредитом не сходится», — отметил Гошен.
Он добавил, что в будущем «индустрия в целом станет гибридной в том смысле, что часть вычислений будет производиться локально на устройствах, а другой инференс перенесется на графические процессоры (GPU)».
Протестировано на MacBook
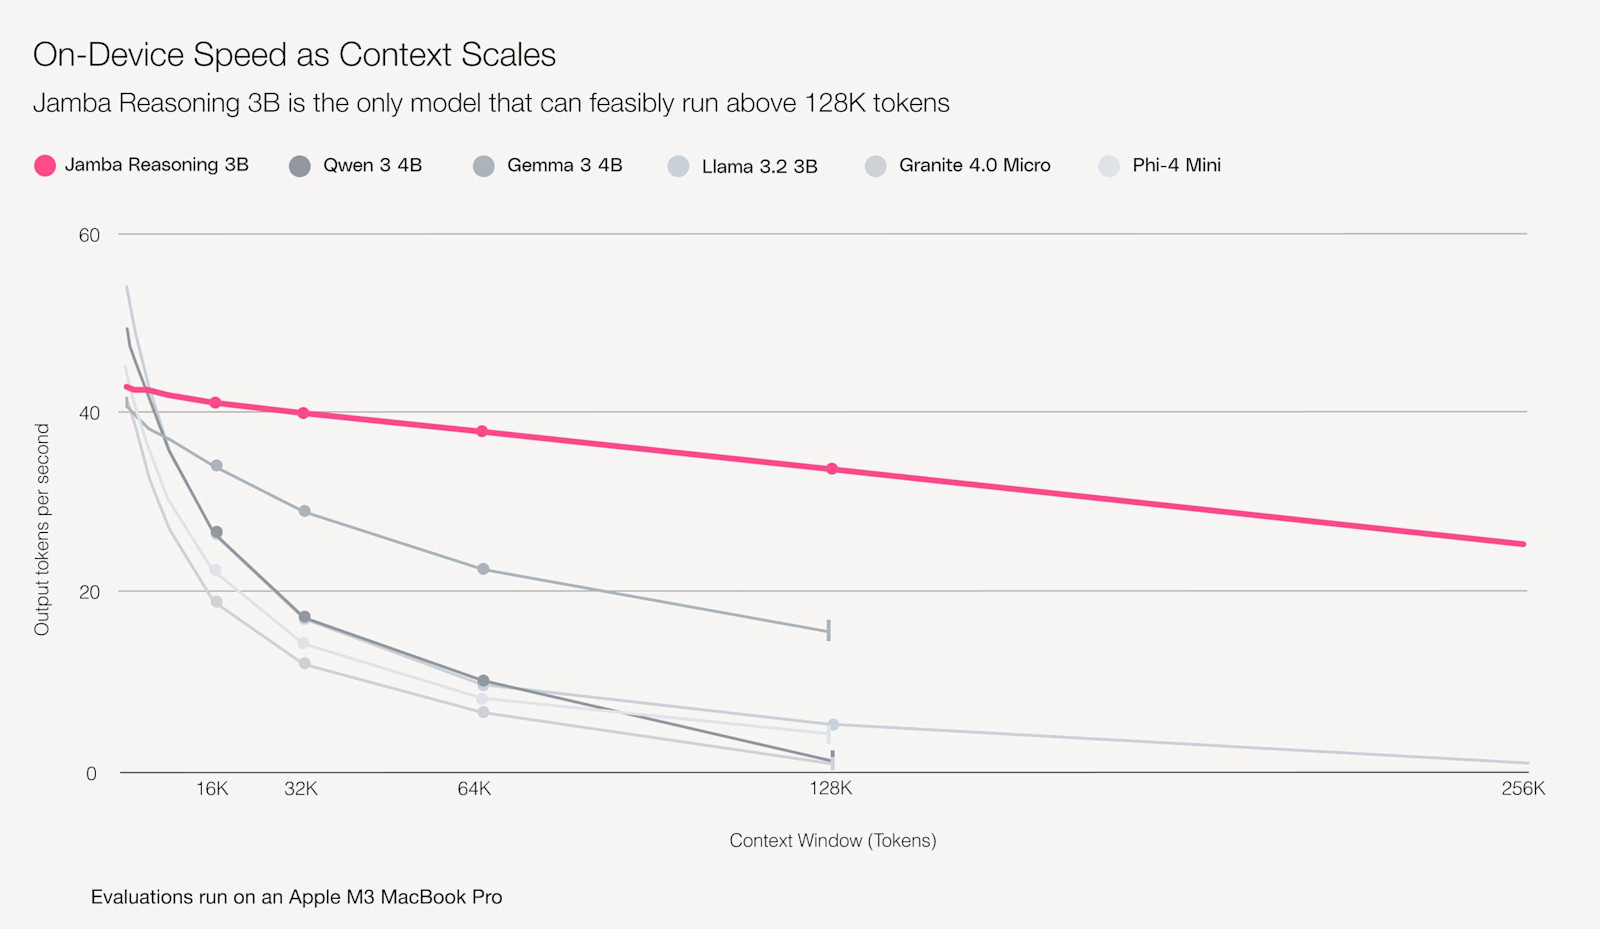
Jamba Reasoning 3B сочетает в себе архитектуру Mamba и трансформеры, что позволяет ей обрабатывать окно в 250 тыс. токенов непосредственно на устройствах. По заявлению AI21, модель обеспечивает в 2–4 раза более высокую скорость инференса. Гошен отметил, что именно архитектура Mamba внесла значительный вклад в скорость работы модели.
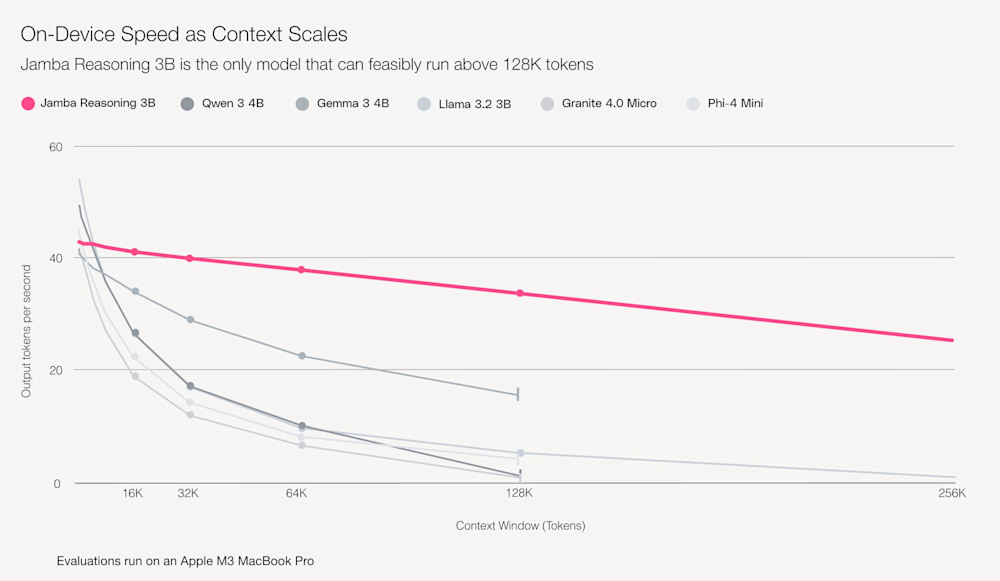
Фото: AI21
Гибридная архитектура Jamba Reasoning 3B также позволяет снизить требования к памяти и, соответственно, уменьшить потребность в вычислительных ресурсах.
В ходе тестирования модели на стандартном MacBook Pro специалисты AI21 выяснили, что она способна обрабатывать 35 токенов в секунду.
По словам Гошена, модель лучше всего подходит для задач, связанных с вызовом функций (function calling), генерацией на основе регламентов и маршрутизацией инструментов. Он пояснил, что простые запросы — например, поиск информации о предстоящей встрече и создание по ее итогам повестки дня — можно выполнять прямо на устройствах. Более сложные задачи, требующие глубоких рассуждений, можно оставить для кластеров GPU.
Небольшие модели в корпоративном секторе
Предприятия проявляют большой интерес к использованию комбинации небольших моделей, часть из которых разработана специально под их отрасль, а часть представляет собой сжатые версии больших языковых моделей (LLM).
В сентябре компания Meta выпустила MobileLLM-R1 — семейство моделей для логических рассуждений с количеством параметров от 140M до 950M. Эти модели оптимизированы для математических, кодинговых и научных задач, а не для чат-приложений. MobileLLM-R1 может работать на устройствах с ограниченными вычислительными ресурсами.
Модель Gemma от компании Google стала одной из первых компактных моделей на рынке, предназначенных для работы на портативных устройствах вроде ноутбуков и мобильных телефонов. Впоследствии линейка Gemma была расширена.
Такие компании, как FICO, также начали создавать собственные модели. FICO представила небольшие модели FICO Focused Language и FICO Focused Sequence, которые отвечают исключительно на финансовые вопросы.
Гошен подчеркнул, что главное отличие их модели заключается в том, что она еще меньше большинства аналогов, но при этом способна выполнять задачи на рассуждение без ущерба для скорости.
Бенчмаркинг
В ходе бенчмарк-тестирования Jamba Reasoning 3B продемонстрировала высокие результаты по сравнению с другими небольшими моделями, включая Qwen 4B, Llama 3.2B-3B от Meta и Phi-4-Mini от Microsoft.
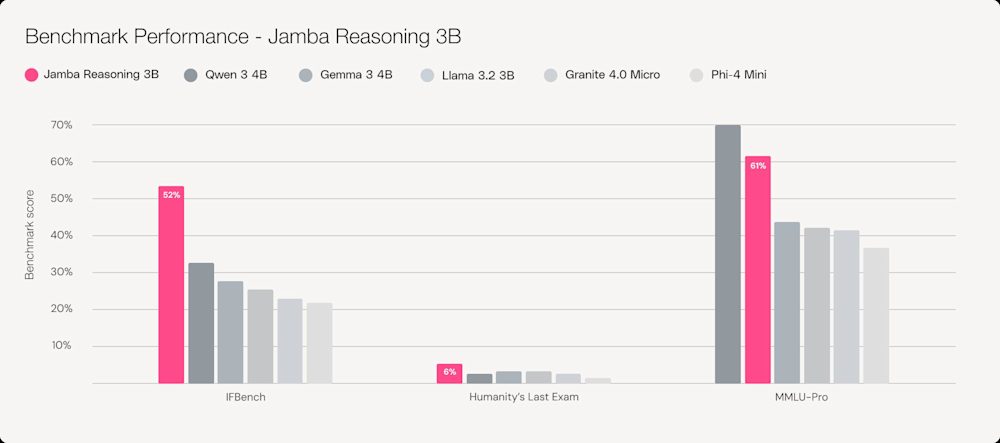
Фото: AI21
Модель превзошла все аналоги в тестах IFBench и Humanity’s Last Exam, хотя уступила второе место Qwen 4 на тесте MMLU-Pro.
Гошен отметил, что еще одним преимуществом таких компактных моделей, как Jamba Reasoning 3B, является их высокая управляемость и лучшие возможности обеспечения конфиденциальности для предприятий, поскольку данные для инференса не передаются на сторонний сервер.
«Я действительно верю, что мы движемся к миру, где можно оптимизировать процессы под нужды и опыт клиента, и модели, которые хранятся прямо на устройствах, играют в этом огромную роль», — резюмировал он.




