


Новый инструмент Experiments от Raindrop рассказывает о результатах работы обновлений ИИ-агентов


Кажется, почти каждую неделю за последние два года с момента запуска ChatGPT конкурирующие лаборатории или сама OpenAI выпускают новые большие языковые модели (LLM). Предприятиям приходится изо всех сил стараться поспевать за колоссальными темпами изменений, не говоря уже о том, чтобы понимать, как к ним адаптироваться — какую из этих новых моделей следует внедрить (и стоит ли вообще), чтобы задействовать их в своих рабочих процессах и создаваемых пользовательских ИИ-агентах?
Помощь подоспела: стартап в сфере наблюдаемости ИИ-приложений Raindrop запустил Experiments («ЭКСПЕРИМЕНТЫ») — новую аналитическую функцию, которую компания описывает как первый набор инструментов для A/B-тестирования, разработанный специально для корпоративных ИИ-агентов. Она позволяет компаниям видеть и сравнивать, как обновление агентов с переходом на новые базовые модели или изменение их инструкций и доступа к инструментам повлияет на их производительность при работе с реальными конечными пользователями.
Этот релиз расширяет существующие инструменты наблюдаемости Raindrop, предоставляя разработчикам и командам возможность отслеживать поведение и эволюцию своих агентов в реальных условиях.
С помощью Experiments команды могут отслеживать, как изменения — такие как новый инструмент, промпт, обновление модели или полный рефакторинг пайплайна — влияют на производительность ИИ при миллионах пользовательских взаимодействий. Новая функция уже доступна для пользователей тарифного плана Raindrop Pro (350 долларов в месяц) на сайте raindrop.ai.
Взгляд на разработку агентов сквозь призму данных
Сооснователь и технический директор Raindrop Бен Халак (Ben Hylak) отметил в видеоанонсе продукта (выше), что Experiments помогает командам увидеть, «как буквально всё изменилось», включая использование инструментов, намерения пользователей и частоту проблем, а также изучить различия по демографическим факторам, таким как язык. Цель состоит в том, чтобы сделать итерации моделей более прозрачными и измеримыми.
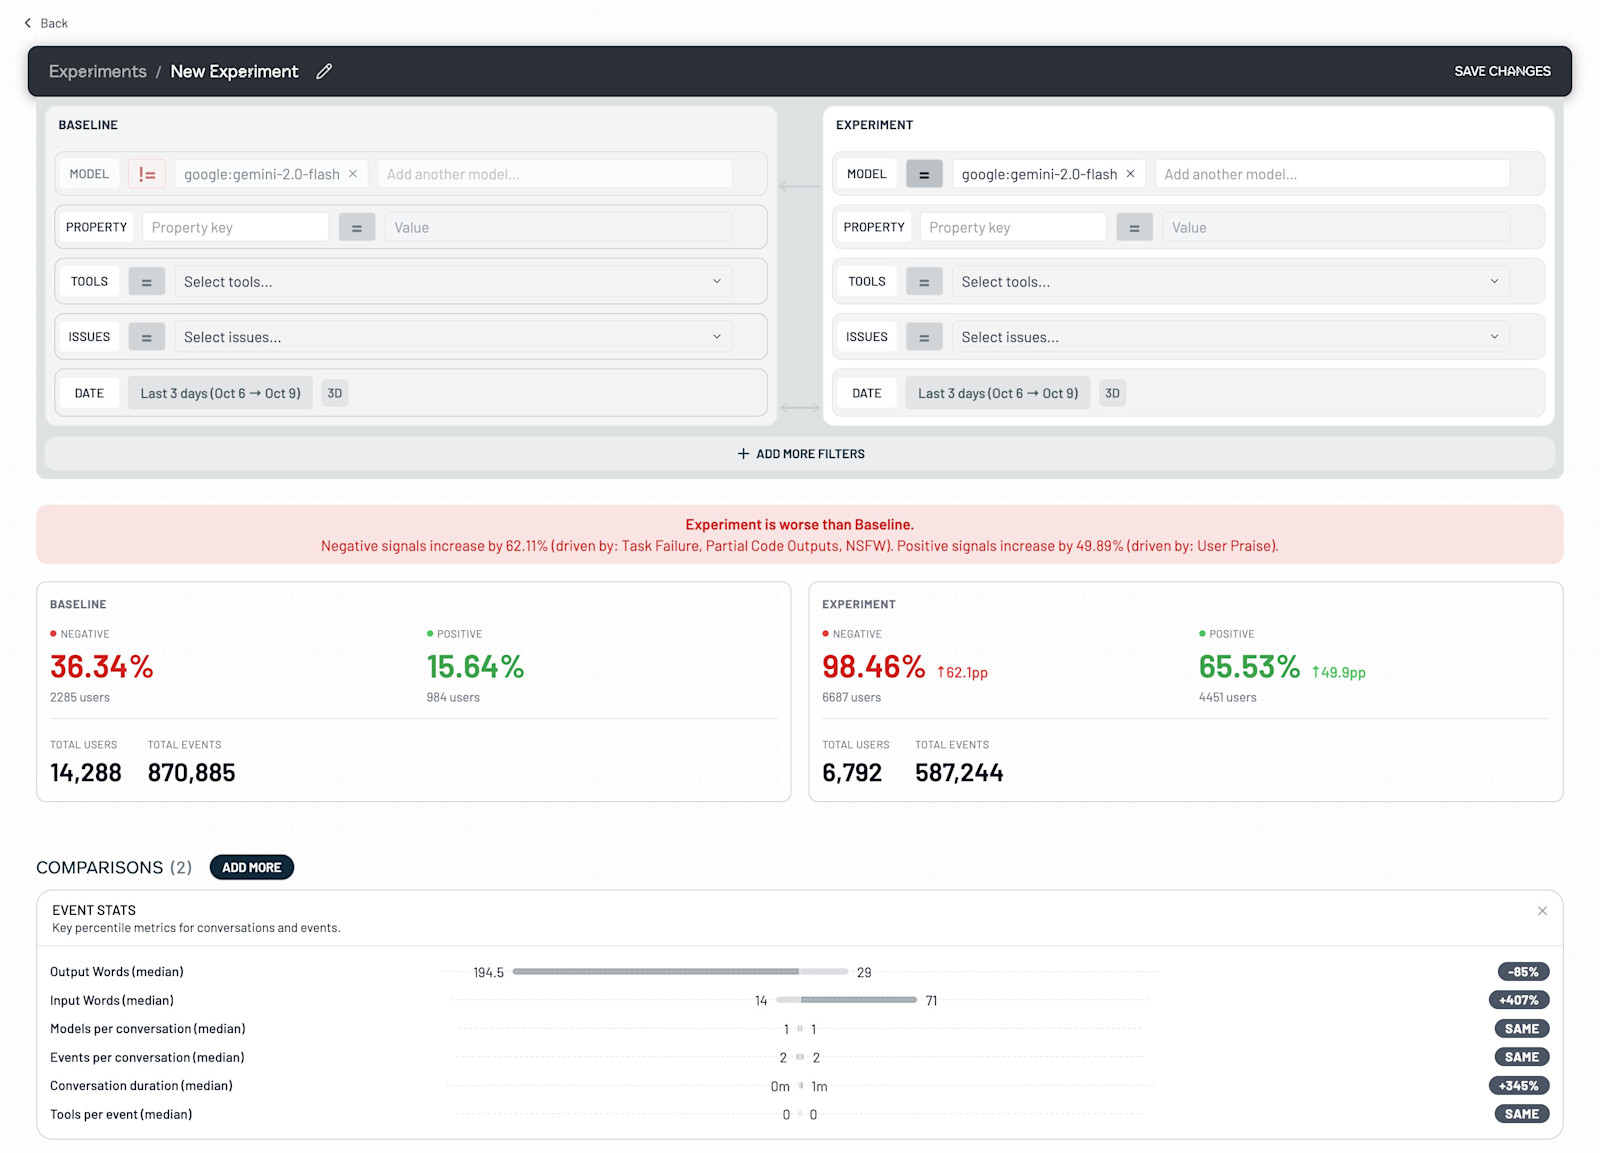
Интерфейс Experiments представляет результаты визуально, показывая, когда эксперимент работает лучше или хуже базового уровня. Увеличение негативных сигналов может указывать на более частые сбои в выполнении задач или частичный вывод кода, в то время как улучшение позитивных сигналов может отражать более полные ответы или лучший пользовательский опыт.
Делая эти данные простыми для интерпретации, Raindrop побуждает команды, работающие с ИИ, подходить к итерациям агентов с той же строгостью, что и к развертыванию современного программного обеспечения — отслеживать результаты, делиться инсайтами и устранять регрессии до того, как они усугубятся.
Предыстория: от наблюдаемости ИИ к экспериментированию
Запуск Experiments компанией Raindrop опирается на статус компании как одной из первых платформ наблюдаемости на базе ИИ, созданных для того, чтобы помочь предприятиям контролировать и понимать поведение их систем генеративного ИИ в продакшене.
Как сообщал VentureBeat ранее в этом году, компания, изначально известная как Dawn AI, появилась для решения того, что Халак, бывший дизайнер пользовательских интерфейсов Apple, назвал «проблемой черного ящика» производительности ИИ, помогая командам фиксировать сбои «по мере их возникновения и объяснять предприятиям, что пошло не так и почему».
В то время Халак описал, как «ИИ-продукты постоянно дают сбои — как в комичной, так и в пугающей форме», отметив, что в отличие от традиционного ПО, которое выдает четкие исключения, «продукты на базе ИИ сбоят безмолвно». Первоначальная платформа Raindrop была сосредоточена на обнаружении этих скрытых сбоев путем анализа таких сигналов, как отзывы пользователей, сбои задач, отказы и другие диалоговые аномалии среди миллионов ежедневных событий.
Сооснователи компании — Халак, Алексис Гауба (Alexis Gauba) и Зубин Сингх Котича (Zubin Singh Koticha) — создали Raindrop после того, как на собственном опыте столкнулись со сложностью отладки ИИ-систем в продакшене.
«Мы начинали с создания ИИ-продуктов, а не инфраструктуры, — рассказал Халак изданию VentureBeat. — Но довольно быстро мы поняли, что для развития чего-то серьезного нам нужны инструменты для понимания поведения ИИ, а таких инструментов не существовало».
С помощью Experiments компания Raindrop распространяет ту же миссию с обнаружения сбоев на измерение улучшений. Новый инструмент преобразует данные наблюдаемости в действенные сопоставления, позволяя предприятиям тестировать, действительно ли изменения в их моделях, промптах или пайплайнах делают их ИИ-агентов лучше или просто другими.
Решение проблемы «Тесты проходят, агенты сбоят»
Традиционные фреймворки оценки, хотя и полезны для бенчмаркинга, редко отражают непредсказуемое поведение ИИ-агентов, работающих в динамических средах.
Как объяснила сооснователь Raindrop Алексис Гауба в своем анонсе в LinkedIn: «Традиционные тесты (evals) на самом деле не отвечают на этот вопрос. Они отличные юнит-тесты, но вы не можете предсказать действия вашего пользователя, а ваш агент работает часами, вызывая сотни инструментов».
Гауба отметила, что компания постоянно слышала одно и то же разочарование от команд: «Тесты проходят, агенты сбоят».
Experiments призвана закрыть этот пробел, показывая, что именно меняется, когда разработчики выпускают обновления для своих систем.
Инструмент позволяет проводить параллельное сравнение моделей, инструментов, намерений или свойств, выявляя поддающиеся измерению различия в поведении и производительности.
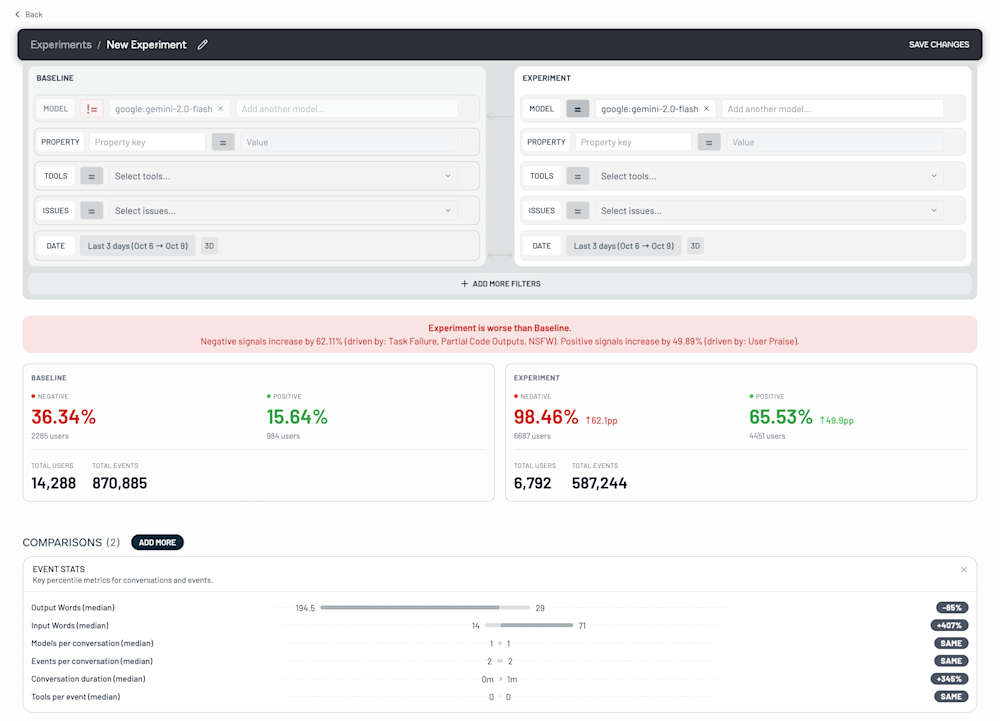
Рекламный скриншот одного из экранов нового инструмента Experiments от Raindrop. Источник: Raindrop AI
Создано для реального поведения ИИ
В видеоанонсе Raindrop охарактеризовала Experiments как способ «сравнить что угодно и измерить, как фактически изменилось поведение вашего агента в продакшене на фоне миллионов реальных взаимодействий».
Платформа помогает пользователям обнаруживать такие проблемы, как всплески сбоев задач, забывание или новые инструменты, вызывающие непредвиденные ошибки.
Её также можно использовать в обратном порядке — начиная с известной проблемы, такой как «агент застрял в цикле», и отслеживая, какая модель, какой инструмент или какой флаг вызывают её.
Оттуда разработчики могут углубиться в детальные трассировки, чтобы найти первопричину и быстро выпустить исправление.
Каждый эксперимент предоставляет визуальную разбивку таких метрик, как частота использования инструментов, уровень ошибок, продолжительность разговора и длина ответа.
Пользователи могут нажать на любое сравнение, чтобы получить доступ к исходным данным о событиях, что дает им четкое представление о том, как поведение агента менялось с течением времени. Общие ссылки (shared links) упрощают совместную работу с членами команды или составление отчетов о результатах.
Интеграция, масштабируемость и точность
По словам Халака, Experiments интегрируется напрямую с «теми платформами фьюча-флагов, которые компании знают и любят (например, Statsig!)», и разработана для бесшовной работы с существующими пайплайнами телеметрии и аналитики.
Для компаний без таких интеграций она все равно может сравнивать производительность в динамике — например, вчерашний день с сегодняшним — без дополнительной настройки.
Халак сообщил, что командам обычно требуется около 2000 пользователей в день для получения статистически значимых результатов.
Для обеспечения точности сравнений Experiments отслеживает достаточность размера выборки и предупреждает пользователей, если в тесте недостаточно данных для того, чтобы сделать обоснованные выводы.
«Мы помешаны на том, чтобы такие метрики, как сбой задач (Task Failure) и разочарование пользователя (User Frustration), были метриками, ради которых вы бы разбудили дежурного инженера», — пояснил Халак. Он добавил, что команды могут углубляться в конкретные разговоры или события, которые формируют эти метрики, обеспечивая прозрачность каждого совокупного показателя.
Безопасность и защита данных
Raindrop работает как облачная платформа, но также предлагает локальную (on-premise) маскировку персональных данных (PII) для предприятий, которым требуется дополнительный контроль.
Халак сообщил, что компания соответствует стандарту SOC 2 и запустила функцию PII Guard, которая использует ИИ для автоматического удаления конфиденциальной информации из сохраненных данных. «Мы очень серьезно относимся к защите клиентских данных», — подчеркнул он.
Цены и тарифные планы
Experiments является частью тарифа Pro от Raindrop, который стоит 350 долларов в месяц или 0,0007 доллара за взаимодействие. Уровень Pro также включает инструменты глубокого исследования, кластеризацию тем, настраиваемое отслеживание проблем и возможности семантического поиска.
Базовый тариф (Starter plan) Raindrop — 65 долларов в месяц или 0,001 доллара за взаимодействие — предлагает ключевую аналитику, включая обнаружение проблем, сигналы обратной связи от пользователей, оповещения в Slack и отслеживание пользователей. Оба тарифа поставляются с 14-дневной бесплатной пробной версией.
Более крупные организации могут выбрать корпоративный тариф (Enterprise plan) с индивидуальным ценообразованием и расширенными функциями, такими как вход по единому входу (SSO), настраиваемые оповещения, интеграции, маскировка PII на периферии и приоритетная поддержка.
Непрерывное совершенствование ИИ-систем
С помощью Experiments компания Raindrop позиционирует себя на стыке аналитики ИИ и наблюдаемости ПО. Её фокус на «измерении истинного положения дел» (measure truth), как заявлено в видеоролике продукта, отражает более широкую тенденцию в отрасли к подотчетности и прозрачности в операциях с ИИ.
Вместо того чтобы полагаться исключительно на автономные бенчмарки, подход Raindrop подчеркивает важность реальных пользовательских данных и контекстуального понимания. Компания надеется, что это позволит разработчикам ИИ двигаться быстрее, раньше находить первопричины и с уверенностью выпускать более эффективные модели.




