


Thinking Machines открывает исходный код своей первой мультимодальной языковой модели Inkling с акцентом на низкую стоимость и «устойчивость к цензуре»
Источник: VentureBeat · Carl Franzen


У предприятий, желающих перенести больше своих рабочих нагрузок на основе агентного ИИ на модели с открытыми весами, которые можно настраивать, контролировать и запускать локально или в виртуальных частных облаках, появился серьезный новый конкурент для рассмотрения.
Сегодня компания Thinking Machines — хорошо финансируемый американский ИИ-стартап, основанный бывшим техническим директором OpenAI Мирой Мурати (Mira Murati) — выпустила Inkling, свою первую крупную языковую модель под дружественной к бизнесу лицензией с открытым исходным кодом Apache 2.0. Она может похвастаться высокой (хотя и чуть уступающей передовым) производительностью для моделей с открытыми весами на сторонних бенчмарках, в частности в области программной инженерии (77,6% на SWE-bench Verified, где она опережает американского открытого соперника Nvidia Nemotron 3 с его 71,9%) и понимания речи (91,4% на VoiceBench по сравнению с 94,4% у Gemini 3.1 Pro при высоком уровне рассуждений).
Еще одно отличие: в Thinking Machines отмечают, что Inkling была разработана для того, «чтобы давать прямые ответы на темы, которые могут подвергаться цензуре». Это предлагает предприятиям, обеспокоенным фактической точностью ответов независимо от их спорности или деликатности, более надежный вариант.
Обладая 975 миллиардами параметров, Inkling представляет собой нативно мультимодальную систему типа «модель смеси экспертов» (MoE) с открытыми весами, способную рассуждать с использованием текста, изображений и аудио. Веса уже доступны на Hugging Face, а также через собственный интерфейс программирования приложений (API) для обучения моделей от компании — Tinker.
Созданная для балансировки стоимости и производительности с помощью инновационного механизма «контролируемых усилий на мышление», модель знаменует собой значительный отход от стратегий масштабирования «черного ящика», характерных для конкурирующих передовых систем.
Наряду с флагманской моделью компания Thinking Machines также анонсировала предварительную версию Inkling-Small — более легкую альтернативу с 276 миллиардами параметров, оптимизированную для рабочих нагрузок, где критически важны низкие задержки и минимальная стоимость.
Бенчмарки демонстрируют мощную, высококлассную модель, почти достигающую передового уровня
Хотя Inkling представляет собой грозный мультимодальный движок, она выходит на жестко конкурентный рынок моделей с открытыми весами 2026 года, для которого характерны высокоспециализированные архитектуры MoE. Вместо того чтобы пытаться доминировать в каждой таблице лидеров, Thinking Machines намеренно спроектировала Inkling (имеющую 975 миллиардов общих и 41 миллиард активных параметров) как универсального, сбалансированного генералиста.
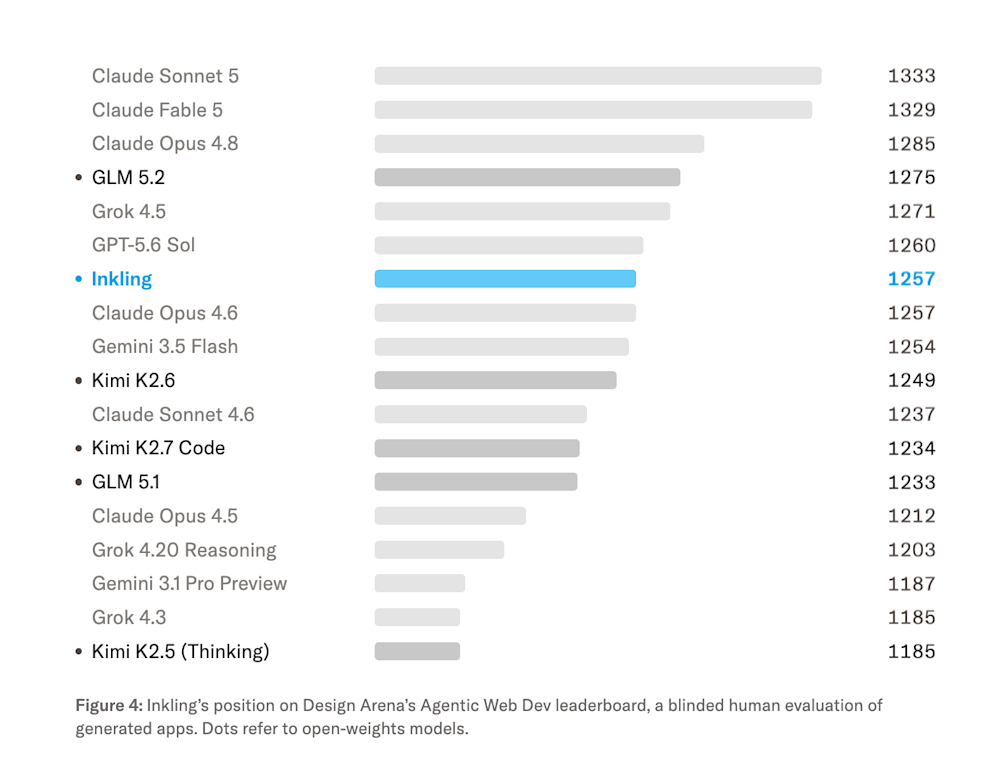
Например, она занимает позиции в верхней части среднего сегмента бенчмарка 1257 в таблице лидеров Design Arena Agentic Web Dev, измеряющей оценки людей в веб-дизайне интерфейсов.
Источник: Thinking Machines
Тем не менее ведущие ИИ-лаборатории Китая создали модели с элитными возможностями рассуждения и написания кода, бросив серьезный вызов универсальному подходу Inkling и в конечном итоге превзойдя ее в общих бенчмарках и тестах по программированию.
-
GLM 5.2: Широко признанная лучшей моделью рассуждений с открытыми весами среди доступных в наборе бенчмарков, GLM 5.2 превосходит Inkling в задачах чистого программирования, агентных задачах и сложных рассуждениях. Она набирает 62,1% в SWEBench Pro (Public) по сравнению с 54,3% у Inkling, а также впечатляющие 82,7 балла в Terminal Bench 2.1 против 63,8 у Inkling. GLM 5.2 также удерживает лидерство в текстовых рассуждениях, набирая 40,1% в HLE (только текст) против 30,0% у Inkling.
-
DeepSeek V4 Pro: DeepSeek сохраняет преимущество в ряде областей, связанных со строгим написанием кода и проверкой фактов, опережая Inkling в SWEBench Verified (80,6% против 77,6%) и SimpleQA Verified (57,0% против 43,9%). Однако Inkling успешно обходит DeepSeek V4 Pro в математическом решении задач, достигая 97,1% в AIME 2026 по сравнению с 96,7% у DeepSeek.
-
Kimi K2.6: Эта модель превосходит Inkling по нескольким техническим бенчмаркам, демонстрируя более высокие результаты в GPQA Diamond (91,1% против 87,9%), BrowseComp (83.2% против 77,1%) и HLE с инструментами (54,0% против 46,0%). Тем не менее Inkling оказывается более устойчивой в следовании общим инструкциям в чате, набирая 79,8% в IFBench по сравнению с 76,0% у Kimi K2.6.
По сравнению со своими основными конкурентами с открытыми весами из США, Inkling демонстрирует высокую степень паритета и часто превосходит их.
-
Nemotron 3 Ultra: Inkling стабильно превосходит этого американского соперника в задачах рассуждения и кодинга. Inkling показывает 97,1% в AIME 2026 и 77,6% в SWEBench Verified, побеждая показатели Nemotron в 94,2% и 70,7% соответственно. Кроме того, Inkling значительно лидирует в агентных рабочих процессах, набирая 74,1% в MCP Atlas против 44,7% у Nemotron.
В сравнении с закрытыми гигантами вроде Claude Fable 5, GPT 5.6 Sol и Gemini 3.1 Pro, Inkling отстает по пиковым возможностям рассуждения и автономности в разработке ПО, но остается весьма конкурентоспособной в плане мультимодальности.
-
Кодинг и рассуждения: Закрытые модели сохраняют уверенное лидерство. Claude Fable 5 (макс.) достигает 95,0% в SWEBench Verified и 53,3% в HLE (только текст), далеко опережая показатели Inkling в 77,6% и 30,0%. GPT 5.6 Sol доминирует в Terminal Bench 2.1 с результатом 89,5, с легкостью превосходя 63,8 у Inkling.
-
Нативная мультимодальность: Собственные визуальные и аудиовозможности Inkling держатся на достойном уровне. В визуальном бенчмарке MMMU Pro (Standard 10) результат Inkling в 73,3% выглядит конкурентоспособным, хотя и уступает Claude Fable 5 (84,2%) и GPT 5.6 Sol (83,0%). В обработке аудио Inkling набирает весьма респектабельные 77,2% в MMAU, оставаясь на расстоянии ударов от 82,5% у Gemini 3.1 Pro.
Если корпоративный рабочий процесс требует элитной автономности в разработке ПО или высочайшего уровня текстовых рассуждений, модели вроде GLM 5.2 или проприетарные системы наподобие Claude Fable 5 сохраняют преимущество.
Тем не менее Inkling занимает уникальную и очень устойчивую нишу: это самая мощная фундаментальная модель с открытыми весами, которая нативно объединяет текст, зрение и звук, одновременно предоставляя разработчикам прямой программный контроль над соотношением затрат и производительности.
Переход от статических рассуждений к контролируемому мышлению
Вместо того чтобы пытаться создать единственную «божественную модель», оптимизированную исключительно для доминирования в бенчмарках, компания Thinking Machines спроектировала Inkling с упором на адаптивность и эффективность в реальных рабочих процессах.
Главной особенностью этого релиза стали «контролируемые усилия на мышление» (controllable thinking effort) у Inkling. Разработчики могут программно настраивать бюджет рассуждений модели — масштабируя его от 0,2 до 0,99 — чтобы определять, насколько интенсивно ИИ должен «думать» перед генерацией ответа.
Как отметили в компании, «непрерывное усилие на мышление у Inkling позволяет вам выбрать нужную точку на кривой стоимости и производительности, достигая того же результата с меньшим количеством токенов».l
На практике это позволяет предприятиям развертывать Inkling с меньшими затратами токенов для более простых задач, одновременно увеличивая вычислительные ресурсы для сложных многоэтапных задач на рассуждение. Однако, поддерживая меньший уровень усилий на мышление и генерируя меньше токенов, ориентированное на экономию предприятие может добиваться высококачественных результатов и производительности на простых задачах при меньших денежных затратах или — в случае локального задействования моделей — меньших расходах на электроэнергию и вычислительные ресурсы.
В ходе крупномасштабного обучения модели с подкреплением (RL), охватившего 30 миллионов итераций, исследователи наблюдали эмерджентный феномен, который они назвали «компрессией цепочки мыслей» (chain of thought condensation). Со временем Inkling естественным образом научилась сжимать свои внутренние шаги рассуждений — отбрасывая грамматические излишки и связующие элементы — при этом приходя к тем же точным выводам, что привело к значительному снижению задержек.
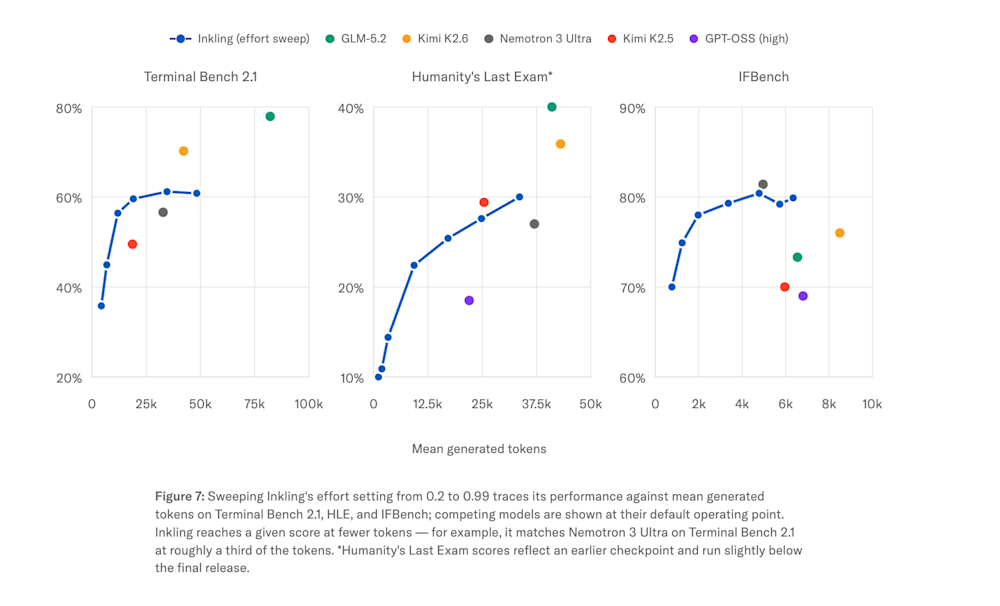
Сравнительный график производительности Thinking Machines Inkling и генерации токенов. Источник: Thinking Machines
Эпистемика и устойчивость к цензуре
Примечательным элементом релиза Thinking Machines является ее явный фокус на эпистемике модели — в частности, на ее калибровке, следовании инструкциям и устойчивости к цензуре.
В экосистеме, где модели с открытыми весами принимают либо чрезмерно ограничительные защитные барьеры, либо транслируют согласованные с государственными идеологиями штампы, Inkling была намеренно обучена давать прямые ответы на политически чувствительные или подвергаемые жесткой цензуре темы.
Чтобы подтвердить этот подход, компания Thinking Machines отправила Inkling на тестирование в рамках оценки Propaganda and Censorship Eval, разработанной ИИ-стартапом Cognition. Согласно опубликованным выводам, Inkling продемонстрировала «сильные паттерны несоблюдения цензуры», эффективно сопротивляясь идеологическому давлению или шаблонным отказам при столкновении с деликатными темами.
Несмотря на устойчивость к цензуре, модель сохраняет надежную защиту от откровенно вредоносных, опасных или незаконных запросов. В бенчмарке StrongREJECT, проверяющем реакцию на недвусмысленные вредоносные запросы, Inkling набрала 98,6%, что ставит ее в один ряд со строгими стандартами безопасности передовых систем. Кроме того, в бенчмарке FORTRESS модель успешно выдержала грань между безопасностью и избыточными отказами: она достигла 78,0% уровня отказов на состязательные запросы (такие как запросы, касающиеся оружия, кибератак или насилия), сохранив при этом 95,9% уровень выполнения на доброкачественных похожих запросах.
В Thinking Machines отметили, что типичные уязвимости моделей с открытыми весами все же остаются в архитектуре. Внутренние оценки безопасности выявили «эпизодическую тенденцию подчиняться ролевым и косвенно сформулированным промптам, касающимся вредоносных тем». Компания посоветовала корпоративным разработчикам относиться к встроенным отказам модели лишь как к одному из уровней безопасности, порекомендовав внедрять на последующих этапах внешние инструменты модерации (например, Llama Guard) для фильтрации состязательных обходов защиты и обеспечения специфических для конкретного сценария политик безопасности на уровне приложений.
Под капотом: архитектура и мультимодальность
Масштаб Inkling поражает воображение, оставаясь при этом разреженным. Архитектура MoE включает 975 миллиардов общих параметров, но во время генерации каждого токена задействуется лишь 41 миллиард. Модель поддерживает массивное окно контекста в 1 миллион токенов и отличается от типичных трансформеров использованием относительных позиционных вложений вместо стандартного для индустрии метода Rotary Positional Embedding (RoPE).
Верная своему основополагающему видению, компания обучила Inkling с нуля для нативной мультимодальности. В отличие от моделей, полагающихся на прикрученные внешние энкодеры, Inkling использует безонкодерный подход раннего слияния (early fusion). Она напрямую принимает аудио в виде дискретных спектрограмм dMel, а визуальные данные — в виде пиксельных патчей 40х40 через иерархический многослойный перцептрон (hMLP), проецируя все модальности в общее скрытое пространство.
Лицензирование: истинный Open-Source для бизнеса
Для корпоративных ИТ-команд и разработчиков самым прорывным аспектом Inkling может стать ее лицензия. Модель выпускается под пермиссивной лицензией Apache 2.0.
В экосистеме, где многие так называемые «открытые» модели от западных лабораторий привязаны к коммерческим лицензиям двойного назначения, ограничениям на допустимое использование или ограничениям по выручке, статус Apache 2.0 делает Inkling подлинно открытым фундаментом. Это дает разработчикам юридическую свободу загружать, модифицировать, интегрировать и коммерциализировать веса модели полностью без роялти.
Модель легко развертывается в основных библиотеках инференса с открытым исходным кодом — включая SGLang, vLLM, TokenSpeed и llama.cpp — и поставляется с нативной квантованной контрольной точкой NVFP4, оптимизированной для систем NVIDIA Blackwell.
Реакция сообщества: инженерный подвиг
Реакция ИИ-сообщества последовала незамедлительно: эксперты хвалят как открытость модели, так и качество ее инженерного исполнения.
В своем посте в X сооснователь Thinking Machines Джон Шульман (John Schulman) размышлял о быстром цикле разработки: «Inkling выходит сегодня с открытыми весами и доступна в Tinker. Было весело наблюдать, как собирается этот проект: претренировка началась прошлой зимой, и с середины января небольшая команда выстраивала обучение кодингу, рассуждениям и агентным возможностям. Мы многое узнали в процессе создания, и я надеюсь, что люди найдут ей хорошее применение».
Хорас Хе (Horace He), исследователь из Thinking Machines (ранее работавший над PyTorch), подчеркнул сложность задачи в другом посте в X: «Чтобы выпустить модель, действительно нужна целая деревня, особенно если речь идет о модели с открытыми весами. Прохождение всего процесса с нуля — от данных и претренировки до посттренировки и фактического релиза — заставляет глубоко уважать каждого, кто делает это!»
Более широкая экосистема с открытым исходным кодом также тепло приветствовала технические интеграции. Лисандр Дебю (Lysandre Debut), директор по открытому исходному коду в Hugging Face, поделился энтузиазмом по поводу оптимизации модели в собственном посте в X: «Больше всего меня поражает то, насколько проще стало ускорять модели… Мы заменили причинную свертку (causal Conv1D) модели на ядро `causal-conv1d`. Изменена всего одна строка, а прирост составил +4% токенов в секунду. Затем мы заменили реализацию внимания на FlashAttention-4. Еще одно одиночное изменение и еще +11%. Это суммарное увеличение пропускной способности примерно на 15% без изменения архитектуры модели или переобучения».
Тьечжен Ван (Tiezhen Wang), эксперт по развитию экосистемы и бывший сотрудник Google, отпраздновал релиз как грандиозную победу для open-source сообщества, перечислив в X впечатляющие спецификации модели, включая ее размер «975B общих, 41B активных», «нативную поддержку MTP» и столь желанную «лицензию Apache 2.0».
Предыстория: путь к Inkling
Чтобы понять значимость Inkling, нужно оглянуться на стремительную траекторию развития Thinking Machines за последние 18 месяцев.
Когда Мира Мурати покинула OpenAI в конце 2024 года, чтобы основать Thinking Machines вместе с ветеранами индустрии Джоном Шульманом и Барретом Зофом (Barret Zoph), заявленной целью был отход от создания изолированных автономных агентов. Вместо этого компания нацелилась на создание гибких мультимодальных систем, предназначенных для подлинного сотрудничества человека и ИИ, а также развития открытой науки.
К июлю 2025 года стартап привлек исторический посевной раунд в размере 2 миллиардов долларов под руководством Andreessen Horowitz при оценке в 12 миллиардов долларов. Тогда Мурати пообещала скорый выпуск продукта со «значительным компонентом открытого исходного кода» для поддержки исследователей и стартапов.
Философия компании начала отчетливее формироваться в октябре 2025 года с запуском Tinker — Python-ориентированного API для тонкой настройки больших языковых моделей, который предоставил исследователям детальный контроль над пайплайнами обучения без сложностей управления распределенными вычислениями.
В том же месяце исследователь Thinking Machines Рафаэль Рафаилов (Rafael Rafailov) выступил с острой критикой ИИ-индустрии на конференции TED AI. Он утверждал, что текущая траектория простого наращивания вычислительных мощностей моделей является фундаментально ошибочной, отметив, что современные системы срезают углы — например, заворачивая код в try/except-блоки — поскольку они обучены исключительно на выполнение задач, а не на подлинное обучение.
Рафаилов предположил, что первым искусственным суперразумом станет не «божественная модель», а «сверхчеловеческий ученик», способный к метаобучению и усвоению абстракций. Архитектура Inkling — в частности, ее контролируемые усилия на мышление и способность органично сжимать цепочку мыслей в процессе RL — ощущается как первая осязаемая реализация тезиса Рафаилова.
В мае 2026 года лаборатория продемонстрировала свое техническое мастерство, выпустив исследовательскую предварительную версию TML-Interaction-Small — системы, которая устранила «пошаговые» чаты, обрабатывая входные и выходные данные одновременно в виде 200-миллисекундных блоков. Этот прорыв в режиме «полного дуплекса» доказал, что компания способна создавать с нуля высокочувствительные, нативно мультимодальные модели.
Теперь, когда Inkling появилась в публичном поле, компания Thinking Machines выполнила свои фундаментальные обещания. Представив массивную, нативно мультимодальную модель подлинно с открытым исходным кодом, они не просто дают разработчикам новый инструмент — они пытаются кардинально переписать экономику и доступность разработки передового ИИ.




