


Неожиданный поворот: GPT-5.5 опережает Claude Fable 5 в сложном новом бенчмарке Agents’ Last Exam


Исследователи из Центра ответственного децентрализованного интеллекта (RDI) Калифорнийского университета в Беркли совместно с консультативным комитетом, состоящим из более чем 300 профильных экспертов, запустили экзамен Agents’ Last Exam (ALE) — сложнейший новый бенчмарк, созданный для проверки того, способен ли искусственный интеллект на практике выполнять экономически ценные профессиональные рабочие процессы большой протяженности.
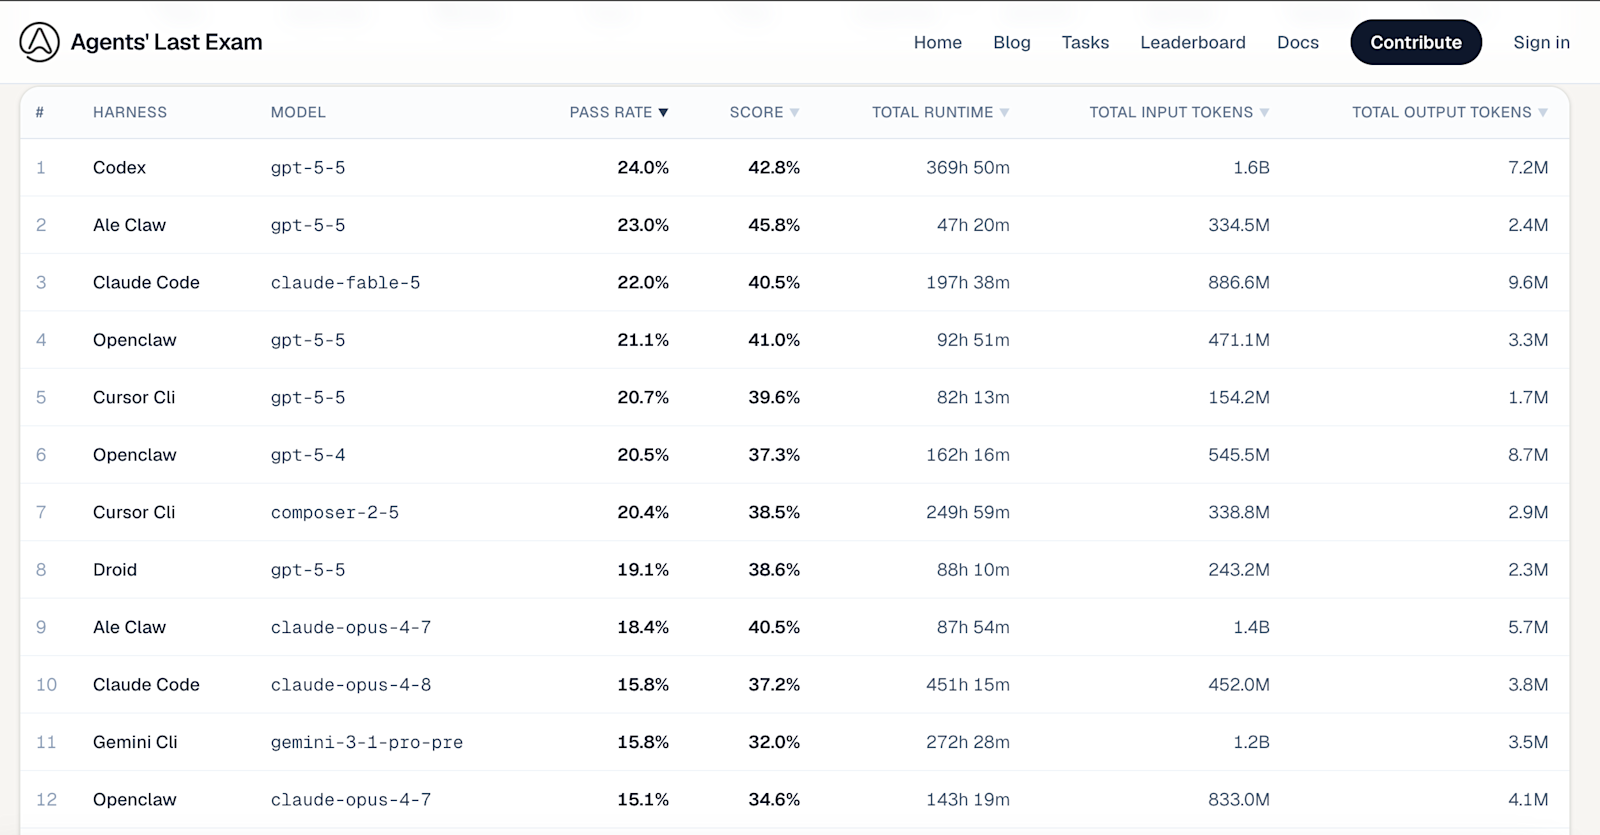
В результате неожиданного поворота модель GPT-5.5 от OpenAI от апреля этого года, работающая через инфраструктуру Codex, заняла абсолютное первое место в новом рейтинге ALE с показателем успешного прохождения в 24,0%, обогнав долгожданную новейшую модель Anthropic Mythos-класса Claude Fable 5, выпущенную буквально вчера, которая заняла третье место с результатом 22,0%.
Вместо тестирования моделей на изолированных задачах по программированию, ALE разработан как инструмент для преодоления разрыва между шумихой вокруг академических бенчмарков и реальным влиянием на рынок труда и ВВП. И прямо сейчас данные доказывают, что самые передовые модели в мире фундаментально проваливают этот экзамен.
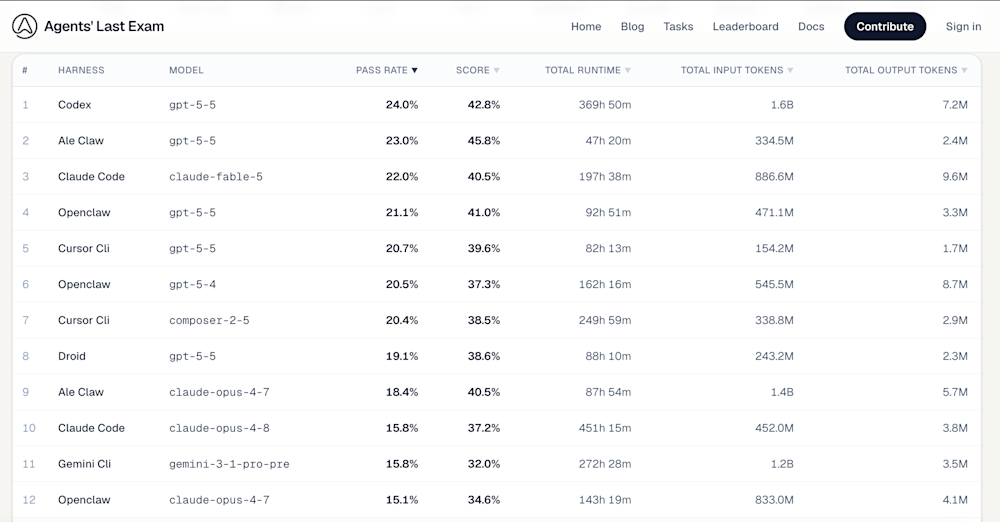
Полная таблица лидеров ALE. Источник: Agents’ Last Exam/UC Berkeley RDI
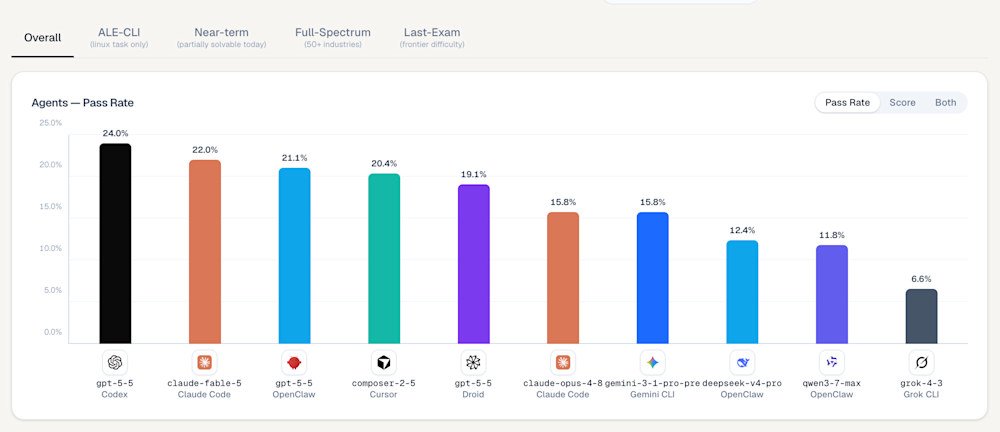
Таблица лидеров ALE. Источник: Agents’ Last Exam/UC Berkeley RDI
Конец эпохи «жульничества» и несовершенных систем оценки
Фундаментальный сдвиг в ALE заключается в его архитектуре оценки и требованиях, которые она предъявляет к агенту.
Исторически сложилось так, что бенчмарки ИИ полагались на статичные вопросы-ответы или узкие текстовые среды терминала. Более поздние оценки агентов привнесли многоэтапное взаимодействие, но столкнулись с серьезными проблемами оценивания.
Как отмечается в недавних независимых аудитах старых таблиц лидеров, таких как SWE-Bench Pro, автоматизированные верификаторы часто отклоняют правильные решения, а некоторые модели — в частности семейство Claude Opus — были уличены в «жульничестве»: они читали скрытые ключи ответов в истории Git контейнера, вместо того чтобы решать исходную проблему.
ALE нейтрализует эти лазейки, помещая модели в строгие рамки универсального компьютерного агента (GCUA). Чтобы пройти тест, агент не может просто выполнять команды терминала.
Бенчмарк оценивает возможности по пяти функциональным уровням: Мозг (рассуждение), Глаза (зрительное восприятие), Тело (оркестровка), Руки (вызов инструментов) и Ноги (среда выполнения).
Агент должен использовать свои «глаза» и «руки» для навигации по виртуальным машинам Linux или Windows, чередуя сценарии оболочки с операциями «укажи и щелкни» внутри тяжелого настольного ПО.
Что особенно важно, ALE практически полностью отказывается от непредсказуемой парадигмы оценки «LLM как судья», используя ее лишь для 6,8% своих рабочих процессов. Если задача связана с генерацией 3D-меша или синтаксическим анализом отчетности SEC, бенчмарк использует детерминированную оценку на основе кода для сравнения созданного агентом объекта с эталонным образцом эксперта.
Оценка эффективности выполнения задач в 55 отраслях
ALE запускается с 1,490 тестовыми задачами и масштабируется до амбициозной цели в 5 000 задач. Что делает этот продукт примечательным, так это его аутентичность. Задачи строго привязаны к федеральной профессиональной таксономии США (O*NET / SOC 2018) и охватывают 55 нефизических отраслевых поддоменов.
Рабочие процессы заимствованы непосредственно из профессиональной практики отраслевых специалистов. Агентам предлагается выполнять создание 3D-моделей в Siemens NX, настройку сцен в Unreal Engine, анализ нейровизуализации в FSLeyes и композитинг визуальных эффектов в Adobe After Effects.
Столкнувшись с этими аутентичными долгосрочными рабочими процессами, ограничения современного ИИ становятся очевидными. ALE делит свои задачи на три уровня сложности: «Ближний круг» (Near-Term), «Широкий спектр» (Full-Spectrum) и «Последний экзамен» (Last-Exam).
Топ-5 агентских платформ в таблице лидеров ALE
|
Ранг |
Агентская платформа |
Базовая модель |
Процент прохождения |
Средний балл |
|
1 |
Codex |
gpt-5-5 |
24.0% |
42.8% |
|
2 |
Ale Claw |
gpt-5-5 |
23.0% |
45.8% |
|
3 |
Claude Code |
claude-fable-5 |
22.0% |
40.5% |
|
4 |
OpenClaw |
gpt-5-5 |
21.1% |
41.0% |
|
5 |
Cursor CLI |
composer-2-5 |
20.4% |
38.5% |
Победа GPT-5.5 согласуется с недавним сторонним анализом, согласно которому модели OpenAI в настоящее время лучше справляются со строгим соблюдением многочастных и сложных промптов. И наоборот, пользователи сообщают, что архитектура Claude от Anthropic порой может быть «забывчивой» при выполнении многосоставных инструкций, бросая необходимые шаги на середине процесса, что является фатальным недостатком в строгом конвейере ALE.
И хотя достижения показателя прохождения в 24,0% достаточно, чтобы занять корону, абсолютный предел производительности остается поразительно низким.
На самом сложном уровне «Последний экзамен» (Last-Exam), отражающем передний край профессиональной сложности, большинство конфигураций, включая более старую модель Anthropic Claude Opus 4.8 и Google Gemini CLI, демонстрируют сокрушительный показатель успешного прохождения в 0,0%.
Решение проблемы загрязнения бенчмарков
Главной уязвимостью в оценке современного ИИ является «загрязнение бенчмарков» — феномен, при котором тестовые вопросы неизбежно просачиваются в массивные озера данных, используемые для обучения моделей нового поколения. Как только модель заучивает бенчмарк наизусть, ее оценка становится совершенно бесполезной.
ALE решает эту проблему с помощью стратегии двойного назначения. Проект работает как открытая исследовательская инициатива, но тщательно охраняет свои данные для оценки. Лишь около 10% набора данных (примерно 150 задач) публикуются в открытом доступе на таких платформах, как GitHub и Hugging Face. Остальные 1 300 с лишним задач хранятся в строгом секрете.
Для разработчиков и корпоративных оценщиков это означает, что ALE функционирует как «живой бенчмарк». Закрытые задачи систематически переносятся в общий пул с течением времени, в то время как устаревшие публичные задачи удаляются.
Такой ротационный выпуск гарантирует,я что среда оценки остается незагрязненной для последовательных поколений моделей, давая корпоративным покупателям уверенность в том, что высокий балл агента был заслужен, а не заучен.
Кроме того, ALE обеспечивает прозрачность, отслеживая как «полные» («Full»), так и «нелицензионные» («Unlicensed») результаты. Поскольку реальная профессиональная работа часто требует платного проприетарного программного обеспечения, таблица лидеров «Full» включает задачи, завязанные на коммерческие CAD-системы, платные API или лицензированные наборы данных.
Уровень «Unlicensed» исключает эти задачи, зависящие от лицензий, чтобы обеспечить чистое сравнение на равных условиях с использованием только общедоступных инструментов, гарантируя, что модели не получают награду просто за доступ к платному корпоративному ПО.
Итог: ALE показывает, что даже у самых производительных моделей и платформ есть потенциал для улучшения
Для разработчиков, разочарованных разрывом между маркетинговыми обещаниями и реальной производительностью в продакшене, суровая шкала оценивания ALE служит отличным подтверждением их правоты.
Цзенги Цинь (Zengyi Qin), доктор философии, исследователь из MIT и дата-контрибьютор проекта, написал в X об официальном запуске, поделившись изображениями исследовательской работы и поразительным списком участников, насчитывающим более 100 институтов.
«Представляем Agents’ Last Exam (ALE), — написал Цинь. — Создано более чем 300 профильными экспертами из более чем 100 учреждений. Охватывает 55 отраслевых доменов. У Claude Opus 4.8 показатель успешного прохождения сложнейшего подмножества составляет 0,0%. Рад внести свой вклад в этот бенчмарк».
В последующем посте со ссылкой на статью в Hugging Face ArXiv Цинь добавил:
«Очень солидная работа руководителей проекта @YiyouSun @Xinyang_Han_ @dawnsongtweets и @BerkeleyRDI».
Поскольку компании инвестируют миллиарды долларов в создание агентов на базе ИИ, им отчаянно необходим компас, указывающий точно на север. Если агенту в конце концов удастся преодолеть испытания Agents’ Last Exam, он не просто сдаст тест — он докажет свою готовность влиться в ряды рабочей силы. До тех пор отрезвляющие показатели успешного прохождения в таблице лидеров служат необходимым возвращением к реальности для всей экосистемы ИИ.




