


Qwen3-Coder-Next предлагает вайб-кодерам мощную модель с открытым исходным кодом и ультраразреженной структурой


Команда исследователей искусственного интеллекта Qwen из китайского гиганта электронной коммерции Alibaba за последний год зарекомендовала себя как один из мировых лидеров в области разработки открытого ИИ, выпустив множество мощных больших языковых моделей и специализированных мультимодальных моделей, которые приближаются, а в некоторых случаях превосходят производительность проприетарных американских лидеров, таких как OpenAI, Anthropic, Google и xAI.
Теперь команда Qwen возвращается на этой неделе с впечатляющим релизом, который соответствует повальному увлечению «вайб-кодингом» (vibe coding), возникшему за последние месяцы: Qwen3-Coder-Next — специализированная модель с 80 миллиардами параметров, созданная для обеспечения элитной агентской производительности при легких активных вычислительных затратах.
Модель выпущена под либеральной лицензией Apache 2.0, что позволяет использовать её в коммерческих целях как крупным предприятиям, так и независимым разработчикам. Веса модели доступны на Hugging Face в четырёх вариантах, а в техническом отчёте описаны некоторые подходы к её обучению и инновации.
Этот релиз знаменует собой серьезную эскалацию в глобальной гонке вооружений за создание идеального помощника по программированию после недели, когда эта сфера буквально взорвалась новыми участниками. От колоссального прироста эффективности инструмента Claude Code от Anthropic до громкого запуска приложения OpenAI Codex и быстрого принятия сообществом открытых фреймворков, таких как OpenClaw, конкурентная среда еще никогда не была столь перенасыщенной.
В этой обстановке с высокими ставками Alibaba не просто идет в ногу со временем — она пытается установить новый стандарт для интеллекта с открытыми весами.
Для лиц, принимающих решения в области языковых моделей, Qwen3-Coder-Next представляет собой фундаментальный сдвиг в экономике инженерии ИИ. Хотя модель содержит в общей сложности 80 миллиардов параметров, она использует ультраразреженную архитектуру «микросхем экспертов» (MoE — Mixture-of-Experts), которая активирует всего 3 миллиарда параметров за один проход вперед.
Такая конструкция позволяет ей обеспечивать возможности рассуждения, соперничающие с массивными проприетарными системами, сохраняя при этом низкие затраты на развертывание и высокую пропускную способность легкой локальной модели.
Устранение узкого места долгого контекста
Главным техническим прорывом, лежащим в основе Qwen3-Coder-Next, является гибридная архитектура, разработанная специально для обхода проблем квадратичного масштабирования, от которых страдают традиционные трансформеры.
По мере расширения контекстных окон — а эта модель поддерживает колоссальные 262 144 токена — традиционные механизмы внимания становятся непосильными с точки зрения вычислительных затрат.
Стандартные трансформеры страдают от «стены памяти», при которой стоимость обработки контекста растет квадратично с увеличением длины последовательности. Qwen решает эту проблему путем объединения Gated DeltaNet с Gated Attention.
Gated DeltaNet выступает в качестве альтернативы стандартному softmax-вниманию с линейной сложностью. Это позволяет модели поддерживать состояние в окне размером в четверть миллиона токенов без экспоненциальных задержек, типичных для рассуждений на больших горизонтах.
В сочетании с ультраразреженной архитектурой MoE это дает теоретическое увеличение пропускной способности в 10 раз для задач на уровне репозитория по сравнению с плотными моделями сопоставимой общей емкости.
Такая архитектура гарантирует, что агент сможет «прочитать» целую библиотеку Python или сложный фреймворк JavaScript и ответить со скоростью модели на 3B параметров, но при этом со структурным пониманием системы на 80B.
Чтобы предотвратить галлюцинации контекста во время обучения, команда использовала метод Best-Fit Packing (BFP) — стратегию, которая поддерживает эффективность без ошибок усечения, присущих традиционной конкатенации документов.
Обучение с упором на агентность
Слово «Next» в названии модели указывает на фундаментальный поворот в методологии обучения. Исторически модели кодирования обучались на статических парах код-текст — по сути, получая «образование только для чтения». Qwen3-Coder-Next разрабатывалась с использованием масштабного конвейера «агентного обучения».
В техническом отчете подробно описан конвейер синтеза, который создал 800 000 проверяемых задач по программированию. Это были не просто фрагменты кода; это были реальные сценарии исправления ошибок, извлеченные из пулл-реквестов GitHub и объединенные с полностью исполняемыми средами.
Инфраструктура обучения, известная как MegaFlow, представляет собой облачную систему оркестрации на базе Alibaba Cloud Kubernetes. В MegaFlow каждая агентская задача выражается в виде трехэтапного рабочего процесса: развертывание агента, оценка и постобработка. Во время развертывания модель взаимодействует с живой контейнеризированной средой.
Если она генерирует код, который не проходит модульный тест или приводит к сбою контейнера, она получает немедленную обратную связь в процессе обучения и с помощью обучения с подкреплением. Такое обучение по «замкнутому циклу» позволяет модели учиться на отзывах среды, что учит ее восстанавливаться после сбоев и уточнять решения в режиме реального времени.
Технические характеристики продукта включают в себя:
-
Поддержка 370 языков программирования: увеличение по сравнению с 92 в предыдущих версиях.
-
Вызов инструментов в стиле XML: новый формат qwen3_coder, разработанный для аргументов, насыщенных строками, который позволяет модели выдавать длинные фрагменты кода без накладных расходов на вложенные кавычки и экранирование, типичных для JSON.
-
Фокус на уровне репозитория: процесс промежуточного обучения был расширен примерно до 600 млрд токенов данных на уровне репозитория, что оказалось более эффективным для логики межфайловых зависимостей, чем использование только датасетов на уровне файлов.
Специализация с помощью экспертных моделей
Ключевым отличительным фактором в конвейере Qwen3-Coder-Next является использование специализированных экспертных моделей. Вместо обучения одной универсальной модели для всех задач команда разработала доменно-специфичных экспертов по веб-разработке и пользовательскому опыту (UX).
Эксперт по веб-разработке нацелен на полностековые задачи, такие как создание пользовательского интерфейса и компоновка элементов. Все примеры кода визуализировались в управляемой Playwright среде Chromium.
Для примеров на React развертывался сервер Vite, чтобы гарантировать правильную инициализацию всех зависимостей. Затем визуально-языковая модель (VLM) оценивала отрисованные страницы на предмет целостности макета и качества интерфейса.
Эксперт по пользовательскому опыту был оптимизирован на соблюдение формата вызовов инструментов в различных каркасах CLI/IDE, таких как Cline и OpenCode. Команда выяснила, что обучение на разнообразных шаблонах чатов с инструментами значительно повышает устойчивость модели к незнакомым схемам на этапе развертывания.
Как только эти эксперты достигали пиковой производительности, их возможности дистиллировались обратно в единую модель MoE 80B/3B. Это гарантирует, что облегченная версия для развертывания сохраняет детальные знания гораздо более крупных моделей-учителей.
Превосходство в бенчмарках при обеспечении высокой безопасности
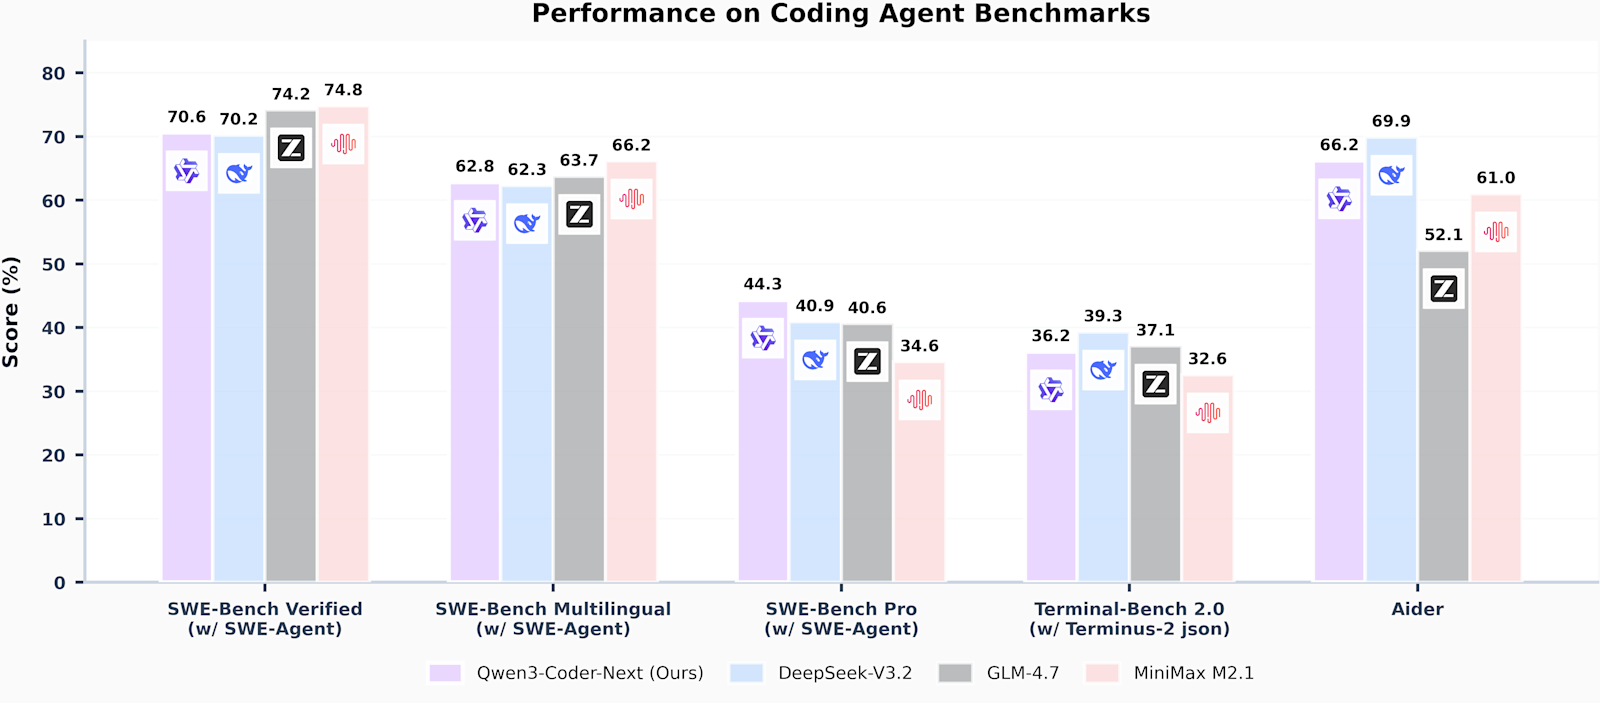
Результаты этого специализированного обучения очевидны по конкурентной позиции модели против гигантов индустрии. В бенчмарк-оценках, проведенных с использованием среды SWE-Agent, модель Qwen3-Coder-Next продемонстрировала исключительную эффективность относительно количества своих активных параметров.
В тесте SWE-Bench Verified модель набрала 70,6%. Этот результат весьма конкурентоспособен по сравнению со значительно более крупными моделями: он превосходит DeepSeek-V3.2, набирающую 70,2%, и лишь ненамного отстает от результата GLM-4.7, составляющего 74,2%.
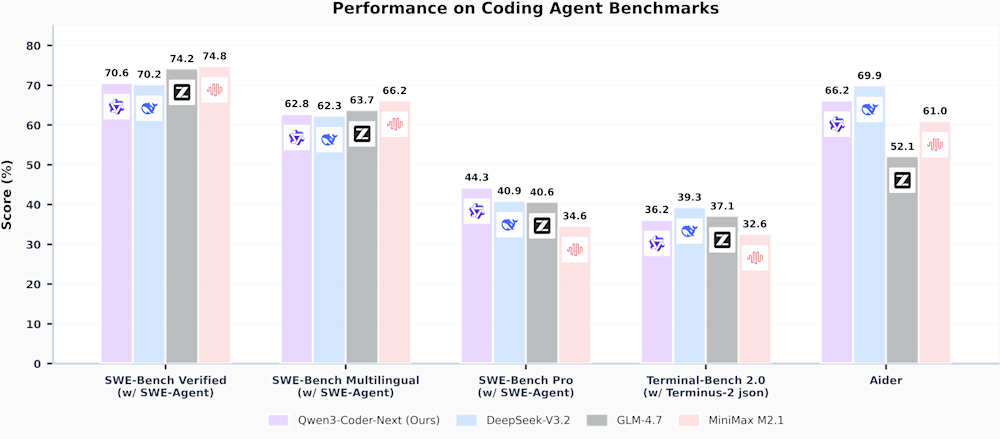
Бенчмарки Qwen3-Coder-Next. Источник: Alibaba Qwen
Что немаловажно, модель демонстрирует высокую внутреннюю осведомленность о безопасности. В тесте SecCodeBench, оценивающем способность модели устранять уязвимости, Qwen3-Coder-Next превзошла Claude-Opus-4.5 в сценариях генерации кода (61,2% против 52,5%).
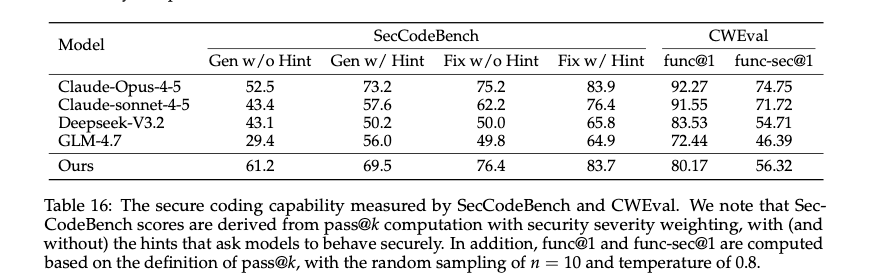
Сравнительная таблица результатов бенчмарка Qwen3-Coder-Next SecCodeBench. Источник: Alibaba Qwen
Стоит отметить, что она сохраняла высокие баллы даже при отсутствии каких-либо подсказок по безопасности, что указывает на то, что она научилась предвосхищать распространенные угрозы безопасности во время фазы агентского обучения на 800 тыс. задач.
В многоязычных тестах безопасности модель также продемонстрировала конкурентный баланс между генерацией функционального и безопасного кода, превзойдя как DeepSeek-V3.2, так и GLM-4.7 в бенчмарке CWEval с показателем func-sec@1 на уровне 56,32%.
Вызов проприетарным гигантам
Этот релиз представляет собой самый серьезный вызов доминированию моделей кодирования с закрытым исходным кодом в 2026 году. Доказав, что модель всего с 3 млрд активных параметров способна справляться со сложностями разработки программного обеспечения в реальном мире так же эффективно, как и «гигант», компания Alibaba фактически демократизировала агентский кодинг.
Моментом озарения («aha! moment») для индустрии стало осознание того, что длина контекста и пропускная способность являются двумя важнейшими рычагами для успеха агентов.
Модель, которая может за секунды обработать 262 тыс. токенов репозитория и проверить свою собственную работу в контейнере Docker, принципиально полезнее более крупной модели, которая работает слишком медленно или стоит слишком дорого для итераций.
Как заключает команда Qwen в своем отчете: «Масштабирование агентного обучения, а не только размера модели, является ключевым драйвером повышения возможностей реальных агентов программирования». С выходом Qwen3-Coder-Next эпоха «мамонтоподобных» моделей кодирования может подойти к концу, уступив место сверхбыстрым разреженным экспертам, которые способны думать так же глубоко, как и работать.




