


Qwen3.8-Max заявляет о себе громко: модель превосходит GPT-5.6 Sol Max и Fable 5 в задачах автономного использования компьютера
Источник: VentureBeat · Carl Franzen


Знаменитая команда исследователей ИИ Qwen китайского гиганта электронной коммерции и облачных вычислений Alibaba минувшей ночью представила Qwen3.8-Max — новую флагманскую мультимодальную большую языковую модель (LLM) с архитектурой «микро-экспертов» (MoE), насчитывающую 2,4 триллиона параметров. Модель нацелена на один из самых конкурентных сегментов рынка передового ИИ: автономную разработку программного обеспечения и долгосрочные корпоративные задачи.
Если опубликованные компанией бенчмарки подтвердятся в ходе независимого тестирования, Qwen3.8-Max не просто составит конкуренцию ведущим проприетарным моделям сегодняшнего дня — она превзойдет некоторые из них по ряду ключевых показателей в области агентных вычислений.
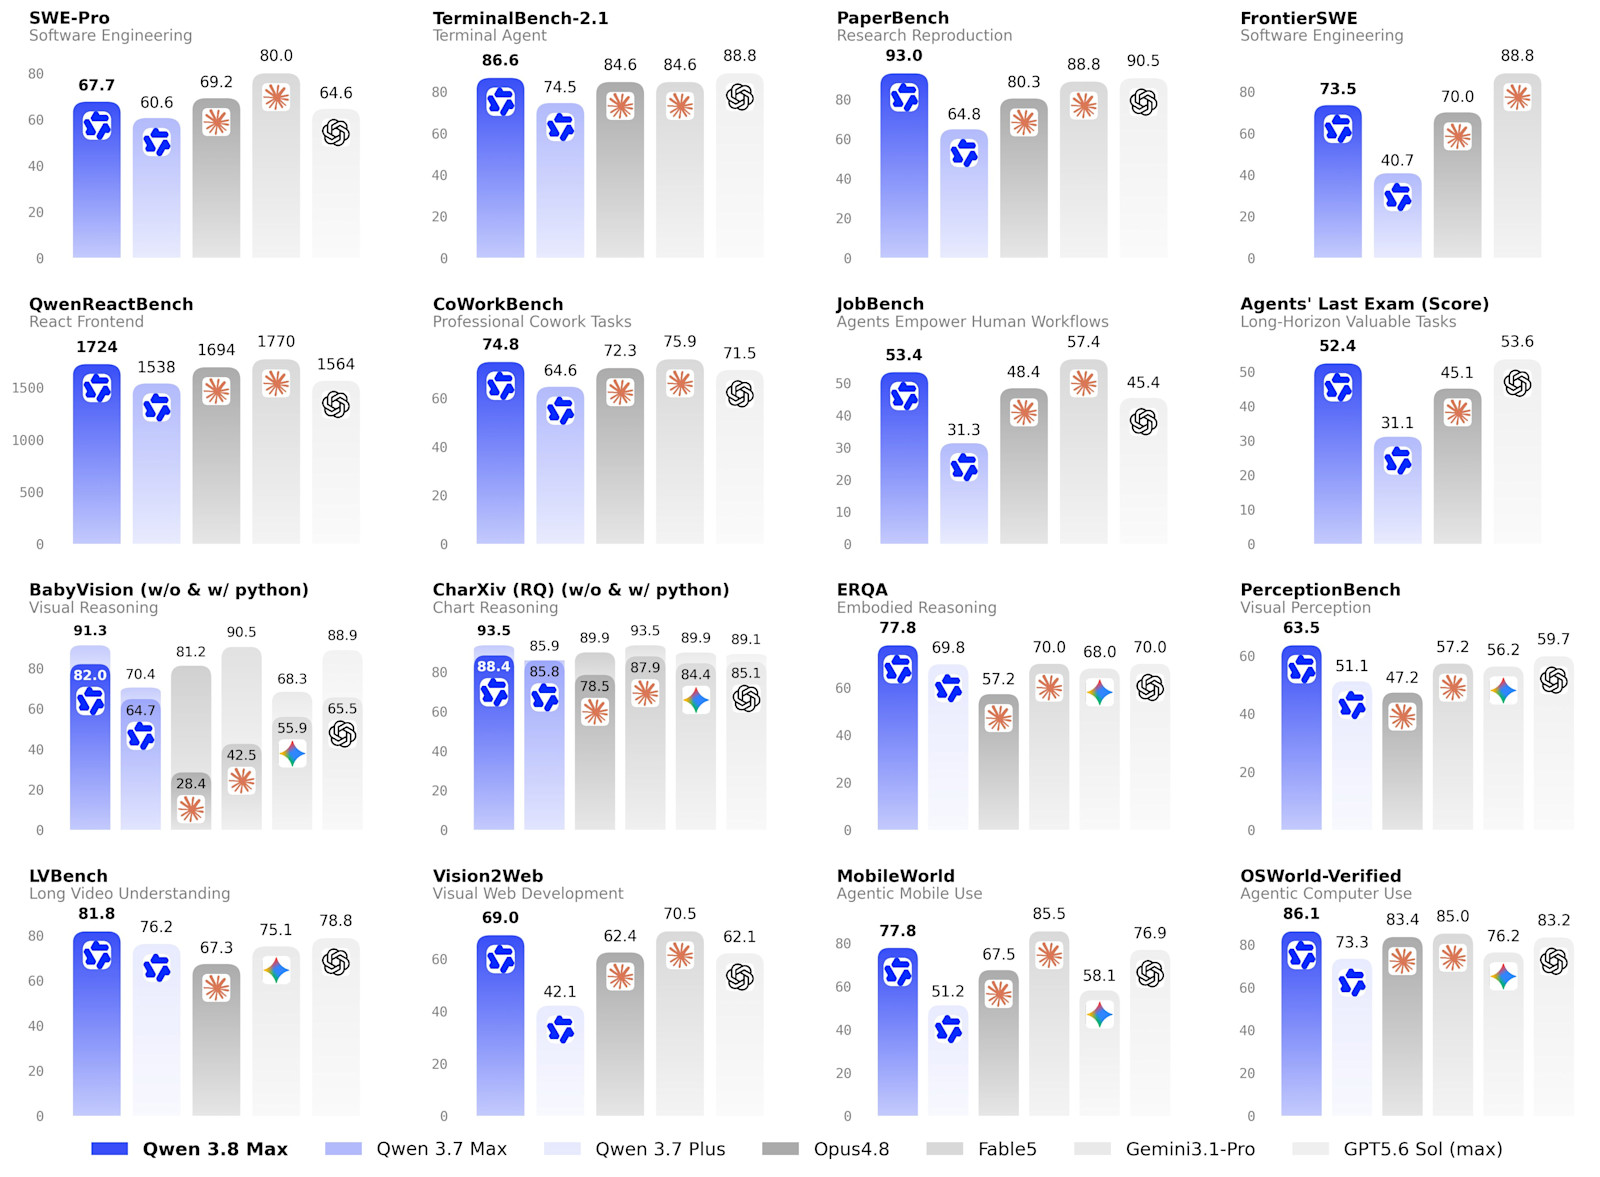
Что особенно примечательно, по данным Qwen, модель набирает 86,1 балла в бенчмарке OSWorld-Verified, который оценивает способность агентов использовать операционную систему компьютера и приложения в ней, опережая GPT-5.6 Sol Max (83,2) и Fable 5 (85,0).
Она также показала самый высокий результат в PaperBench — бенчмарке от OpenAI, измеряющем способность агентов воссоздавать научные исследовательские работы по экспериментальным данным, а также заняла лидирующие позиции или осталась крайне конкурентоспособной в тестах на разработку программного обеспечения, воспроизведение исследований, мультимодальные рассуждения и визуальную веб-разработку.
Этот релиз также сигнализирует о потенциально значительном стратегическом сдвиге для Alibaba: компания заявляет, что открытые веса Qwen3.8-Max будут выпущены на следующей неделе одновременно с Qwen3.8-27B.
Если это произойдет на условиях либеральной лицензии, это станет первым случаем, когда модель Qwen класса Max станет доступна для развертывания на собственных серверах — шаг, способный существенно изменить корпоративное внедрение.
Тем не менее, остается одно важное условие: Alibaba пока не раскрыла условия лицензирования, оставляя открытой возможность того, что релиз будет использовать более ограничительную пользовательскую лицензию (как мы недавно видели в случае с открытой передовой моделью Kimi K3 китайского конкурента Moonshot), а не широко разрешительную, такую как Apache 2.0.
Иное определение «передового уровня»
За последний год конкурентная среда среди базовых моделей стала значительно более узкоспециализированной.
OpenAI в основном сосредоточила свою серию GPT на общих рассуждениях, мультимодальном взаимодействии и корпоративной продуктивности.
Серия Claude от Anthropic сделала акцент на написании кода и надежных рассуждениях с длинным контекстом. Google продолжает продвигать Gemini в направлении мультимодальной продуктивности и нативных веб-рабочих процессов.
Модель Kimi K3 от Moonshot AI недавно вошла в этот ряд, объединив производительность передового уровня с релизом открытых весов.
Qwen3.8-Max пытается объединить многие из этих сильных сторон в единую модель, нацеленную непосредственно на корпоративную автоматизацию.
Вместо упора на диалоговый интеллект Alibaba позиционирует модель как автономного коллегу, способного выполнять проекты, длящиеся днями, а не минутами.
По заявлению компании, Qwen3.8-Max способна автономно завершать софтверные проекты продолжительностью более 10 дней, воспроизводить научные работы, включающие тысячи строк кода, выполнять итеративную оптимизацию проектирования микросхем и непрерывно пересматривать планы с использованием циклов мультимодальной обратной связи.
Эти демонстрации по-прежнему подготовлены самой компанией и еще не получили широкого воспроизведения независимыми экспертами. Тем не менее они иллюстрируют растущую тенденцию в отрасли: передовые модели все больше конкурируют по своей способности завершать рабочие процессы целиком, а не отвечать на отдельные промпты.
Бенчмарки все больше поощряют автономное выполнение задач
Набор бенчмарков, выпущенный вместе с Qwen3.8-Max, отражает этот сдвиг.
Вместо того чтобы фокусироваться исключительно на традиционных экзаменах на рассуждение или задачах на кодинг, многие из ключевых оценок измеряют выполнение долгосрочных задач.
В бенчмарке OSWorld-Verified, оценивающем агентов для работы с компьютером в среде рабочего стола, Qwen3.8-Max набирает 86,1 балла, опережая GPT-5.6 Sol Max (83,2), Fable 5 (85,0) и Gemini 3.1 Pro (76,2).
Сравнение бенчмарков Qwen3.8-Max на гистограмме. Источник: Alibaba Qwen
Модель также лидирует в:
-
PaperBench: 93,0
-
TerminalBench 2.1: 86,6
-
Vision2Web: 69,0
-
LVBench: 81,8
-
ERQA: 77,8
В остальных тестах она сохраняет конкурентоспособность с проприетарными лидерами, хотя в некоторых категориях уступает.
Например, в профессиональном бенчмарке по разработке программного обеспечения SWE-Pro самую высокую оценку демонстрирует модель от OpenAI, в то время как Opus 4.8 продолжает лидировать в некоторых тестах по разработке ПО и в Agents’ Last Exam.
Вместо доминирования в каждом отдельном бенчмарке, Qwen предлагает один из самых сбалансированных профилей производительности из доступных в настоящее время.
Этот баланс в конечном итоге может иметь для корпоративных покупателей большую ценность, чем победы в изолированных тестах.
Многие организации все чаще оценивают модели по тому, насколько надежно они справляются с разнородными рабочими процессами — написанием кода, чтением документов, навигацией по интерфейсам, созданием отчетов, инспекцией изображений и координацией нескольких подзадач, — а не по оптимизации под одну узкую способность.
Где Qwen3.8-Max выглядит наиболее сильной
Если предположить, что опубликованные результаты Alibaba подтвердятся на практике, для Qwen3.8-Max выделяется несколько корпоративных сценариев использования, к которым она особенно хорошо подходит.
1. Долгосрочная разработка ПО
Основная демонстрация Alibaba связана с автономной разработкой программного обеспечения продолжительностью более десяти дней.
Хотя предприятиям следует относиться к этим демонстрациям как к заявлениям вендора до их независимого воспроизведения, они согласуются с растущим интересом к постоянным кодинг-агентам, работающим непрерывно, а не в интерактивном режиме.
Организации, экспериментирующие с автономными инженерными командами, CI/CD-автоматизацией, поддержкой репозиториев, регрессионным тестированием или реализацией функций, могут найти Qwen особенно привлекательной, если ее агентские возможности окажутся стабильными вне лабораторных условий.
2. Агенты для работы с компьютером
Наиболее сильным отличительным признаком может стать работа с компьютером.
OSWorld быстро превратился в один из самых тщательно отслеживаемых бенчмарков в индустрии, поскольку он измеряет способность модели взаимодействовать с операционными системами, а не просто генерировать текст.
Модели, способные надежно ориентироваться в десктопном ПО, могут автоматизировать бесчисленные рутинные бизнес-процессы, включая обработку документов, интеграцию корпоративного ПО, внутренние операции и устаревшие рабочие процессы, где API могут отсутствовать.
Лидирующие позиции в OSWorld могут поэтому трансформироваться в реальные операционные преимущества, если показатели бенчмарка перенесутся на производственные среды.
3. Автоматизация исследований
Лидерство Qwen в PaperBench говорит о высоком потенциале для организаций, занимающихся научными вычислениями, обзором литературы, воспроизведением экспериментов и техническим анализом.
Научно-исследовательские институты, фармацевтические компании и команды промышленных НИОКР все чаще используют LLM не только для суммаризации, но и для выполнения воспроизводимых вычислительных рабочих процессов. Модели, способные удерживать контекст в ходе длительных сессий, становятся в таких условиях крайне ценными.
4. Мультимодальные промышленные рабочие процессы
В отличие от ранних мультимодальных систем, которые в основном анализируют загруженные изображения, Qwen описывает визуальное восприятие как непрерывный механизм обратной связи, интегрированный в планирование и выполнение.
Такая архитектура может оказаться особенно полезной в производстве, логистике, инженерном контроле и экспертной оценке дизайна, где визуальные данные постоянно влияют на оперативные решения, а не служат разовыми промптами.
Экономика может оказаться не менее важной
Пожалуй, сильнейшее конкурентное давление исходит не от результатов бенчмарков, а от ценообразования через интерфейс программирования приложений (API) на платформе QwenCloud (базирующейся в Китае):
Qwen3.8-Max запускается по цене $2/$6 за миллион входных/выходных токенов. Это модель сред ценового диапазона, однако она значительно превосходит по ценовой доступности ведущие американские проприетарные аналоги, с которыми ее сравнивают: ее стоимость составляет менее 1/3 от совокупной цены входа/выхода Claude Opus 5 и менее 1/4 от цены GPT-5.6 Sol Max.
|
Модель |
Вход ($/1M) |
Выход ($/1M) |
Итого ($/1M) |
Источник |
|
MiMo-V2.5 Flash |
$0.10 |
$0.30 |
$0.40 |
|
|
deepseek-v4-flash |
$0.14 |
$0.28 |
$0.42 |
|
|
deepseek-v4-pro |
$0.435 |
$0.87 |
$1.305 |
|
|
GPT-5.6 Luna |
$0.20 |
$1.20 |
$1.40 |
|
|
MiniMax-M3 |
$0.30 |
$1.20 |
$1.50 |
|
|
LongCat-2.0 — лимитированная акция |
$0.30 |
$1.20 |
$1.50 |
|
|
Gemini 3.1 Flash-Lite |
$0.25 |
$1.50 |
$1.75 |
|
|
Qwen3.7-Plus |
$0.40 |
$1.60 |
$2.00 |
|
|
MiMo-V2.5 |
$0.40 |
$2.00 |
$2.40 |
|
|
Gemini 3.5 Flash-Lite |
$0.30 |
$2.50 |
$2.80 |
|
|
LongCat-2.0 — стандарт |
$0.75 |
$2.95 |
$3.70 |
|
|
MiMo-V2.5 Pro (≤256K) |
$1.00 |
$3.00 |
$4.00 |
|
|
GLM-5.2 |
$1.40 |
$4.40 |
$5.80 |
|
|
Grok 4.5 |
$2.00 |
$6.00 |
$8.00 |
|
|
MiMo-V2.5 Pro (>256K) |
$2.00 |
$6.00 |
$8.00 |
|
|
Qwen3.8-Max |
$2.00 |
$6.00 |
$8.00 |
|
|
Gemini 3.6 Flash |
$1.50 |
$7.50 |
$9.00 |
|
|
Qwen3.7-Max |
$2.50 |
$7.50 |
$10.00 |
|
|
Gemini 3.5 Flash |
$1.50 |
$9.00 |
$10.50 |
|
|
Gemini 3.1 Pro Preview (≤200K) |
$2.00 |
$12.00 |
$14.00 |
|
|
GPT-5.6 Terra |
$2.00 |
$12.00 |
$14.00 |
|
|
GPT-5.4 |
$2.50 |
$15.00 |
$17.50 |
|
|
Kimi K3 |
$3.00 |
$15.00 |
$18.00 |
|
|
Gemini 3.1 Pro Preview (>200K) |
$4.00 |
$18.00 |
$22.00 |
|
|
Claude Opus 5 |
$5.00 |
$25.00 |
$30.00 |
|
|
GPT-5.5 |
$5.00 |
$30.00 |
$35.00 |
|
|
GPT-5.5 Instant (chat-latest) |
$5.00 |
$30.00 |
$35.00 |
|
|
Sakana Fugu Ultra (≤272K) |
$5.00 |
$30.00 |
$35.00 |
|
|
GPT-5.6 Sol — Стандартный режим |
$5.00 |
$30.00 |
$35.00 |
|
|
Claude Fable 5 / Claude Mythos 5 |
$10.00 |
$50.00 |
$60.00 |
|
|
GPT-5.6 Sol — Быстрый режим |
$10.00 |
$60.00 |
$70.00 |
Более низкие затраты на инференс играют все большую роль, поскольку агентные системы потребляют значительно больше токенов, чем обычные чат-боты — реальность, которая, судя по всему, повлияла на решение OpenAI в конце прошлой недели снизить цены на API для своей линейки средне- и бюджетных моделей GPT-5.6 (Terra и Luna) на 20% и 80% соответственно.
Действительно, как могут подтвердить разработчики таких систем, многочасовые автономные рабочие процессы, итеративное планирование и непрерывная самокоррекция способны генерировать миллионы токенов в ходе выполнения всего одной задачи.
Для предприятий, развертывающих сотни или тысячи агентов одновременно, затраты на инференс часто становятся одной из крупнейших операционных статей расходов. Поэтому небольшое снижение цен за токен быстро накапливается в существенную экономию.
Сравнение с американскими передовыми моделями
Несмотря на сравнения по заголовкам бенчмарков, Qwen3.8-Max не следует автоматически рассматривать как замену ведущим американским моделям.
Вместо этого ее сильные стороны предполагают иные стратегии развертывания.
Семейство GPT от OpenAI продолжает преуспевать как универсальная корпоративная платформа для рассуждений с развитым инструментарием, интеграцией в экосистему и масштабным коммерческим внедрением. Организации, уже вложившиеся в экосистемы Microsoft или корпоративные предложения OpenAI, могут продолжать ценить эти операционные преимущества, даже если Qwen лидирует в отдельных агентских бенчмарках.
Claude Opus от Anthropic по-прежнему широко считается одним из сильнейших ассистентов для кодинга, особенно для аккуратной разработки ПО и рассуждений на основе длинного контекста. Некоторые компании могут предпочесть Claude для разработки с участием человека, где надежность и предсказуемое поведение перевешивают сырую автономность.
Google Gemini продолжает дифференцироваться за счет глубокой интеграции с Workspace, мультимодальных возможностей и сервисов Google Cloud, что делает ее привлекательной для организаций, уже стандартизированных на корпоративном стеке Google.
Там, где Qwen выглядит наиболее убедительно, — это предприятия, отдающие приоритет автономному выполнению задач, расширенному горизонту планирования и выгодной экономике инференса без ущерба для производительности передового уровня.
Вопрос об открытых весах остается без ответа
Главная неизвестная, окружающая Qwen3.8-Max, имеет мало общего с бенчмарками.
Alibaba заявляет, что открытые веса появятся на следующей неделе. Однако ни анонс, ни предоставленная документация не уточняют лицензию, которая будет регулировать использование этих весов.
Это различие может оказаться критически важным.
Либеральная лицензия, такая как Apache 2.0, значительно расширит корпоративное внедрение, позволив организациям развертывать модель на собственных мощностях, дообучать ее и интегрировать в проприетарные продукты с относительно небольшими ограничениями.
Кастомная лицензия — по аналогии с подходами, использованными в нескольких недавних релизах передовых моделей — может наложить ограничения на коммерческое развертывание, распространение, сферу применения или модификацию модели. Такие ограничения сузят привлекательность для предприятий, ищущих долгосрочные инвестиции в инфраструктуру, независимо от технических показателей модели.
Недавний релиз модели Kimi K3 от Moonshot AI иллюстрирует, почему это различие имеет значение. Хотя Kimi K3 сделала свои весы общедоступными для всех, ее лицензионные условия включали особые пункты, в том числе требования о раскрытии информации и наличии коммерческой лицензии для тех, кто предлагает модель в качестве услуги (MaaS).
Пока Alibaba не опубликует лицензию на Qwen3.8-Max, организациям, рассматривающим возможность саморазвертывания, следует воспринимать новость об открытых весах как многообещающую, но неполную.
Все более переполненный передний край
Qwen3.8-Max появляется в один из самых динамичных периодов в истории базовых моделей.
За считанные недели разработчики увидели крупные релизы от Moonshot AI, OpenAI, Anthropic и других компаний, каждая из которых делает акцент на разных сильных сторонах: рассуждениях, кодинге, мультимодальности, автономных агентах или экономической эффективности.
Вклад Alibaba примечачен тем, что он сочетает в себе конкурентоспособную производительность в бенчмарках, агрессивное ценообразование, контекстное окно в миллион токенов и заявленное обязательство выпустить веса для своей флагманской модели.
Станет ли она предпочтительной платформой для корпоративных автономных агентов, в конечном итоге будет зависеть не столько от позиций в таблицах лидеров, сколько от более широкой независимой валидации, надежности в продакшене и лицензионных условий, сопровождающих предстоящий релиз весов.
Именно эти факторы, а не только графики бенчмарков, определят, станет ли Qwen3.8-Max подлинной альтернативой ведущим американским проприетарным моделям или просто еще одним впечатляющим участником во все более переполненной гонке передовых систем ИИ.




