OpenAI решает давнюю математическую проблему с помощью роя из 10 000 агентов, но не может исключить пользу от использования закрытых данных исследователя в Codex
Источник: VentureBeat · Carl Franzen


Компания OpenAI объявила сегодня, что внутренняя система искусственного интеллекта решила проблему существования и гладкости решений уравнений Навье — Стокса — одну из семи всемирно известных и исключительно сложных проблем тысячелетия в математике, которая оставалась нерешенной с момента своего появления 26 лет назад. Решение было найдено с помощью скоординированной системы, задействовавшей около 10 000 одновременно работающих агентов ИИ.
Эта задача, названная в честь математиков XIX века Клода-Луи Навье и Джорджа Габриэля Стокса, ставит фундаментальный, но чрезвычайно сложный вопрос об уравнениях, описывающих движение таких жидкостей и газов, как воздух и вода: может ли жидкость, которая начинает двигаться гладко, со временем прийти к математическому разрушению?
В OpenAI заявляют, что их система создала новое доказательство, демонстрирующее, что при определенных условиях плавно движущаяся трехмерная жидкость может достичь точки, в которой ее расчетная скорость возрастает до бесконечности за конечное время. На практике это означало бы, что сами уравнения в конечном счете перестают давать физически осмысленное описание жидкости.
Однако объявление OpenAI также сопровождается спором о том, как именно была выполнена эта работа и кто должен получить за нее признание.
Математик из Нью-Йоркского университета (NYU), занимающийся тесно связанными исследованиями с поддержкой ИИ, опубликовал вчера вечером — еще до официального заявления OpenAI — заявление в Mastodon, поставив под сомнение то, мог ли алгоритм компании обучаться на исследованиях, которые он проводил совместно с коллегой из Anthropic, или иным образом использовать их. Частично эти исследования проводились с применением Codex — среды и приложения от OpenAI, ориентированных на написание кода и рабочих задач.
Представители OpenAI изначально сообщили изданию VentureBeat, что ни исследователи компании, ни системы ИИ не просматривали пользовательские данные для решения этой задачи. Однако в последующем публичном заявлении компания добавила важное уточнение: хотя, по ее утверждению, доступ к конкретным пользовательским данным для получения решения не осуществлялся, она «не может исключать», что обезличенные данные, полученные в результате использования продуктов OpenAI исследователями, помогли улучшить ее модели.
На прямой вопрос VentureBeat во время видеоконференции для прессы ранее сегодня о том, обращались ли сотрудники OpenAI или ее агенты к результатам работы с Codex сторонних исследователей, главный научный сотрудник OpenAI Марк Чен ответил: «Ни люди, ни системы ИИ не изучали пользовательские данные для решения этой проблемы или какой-либо конкретной задачи, перед которой мы стояли. И я немного разочарован обвинениями в гигантском нарушении пользовательского доверия. Мы этого не делали».
Тем не менее, позже в тот же день на платформе X OpenAI опубликовала заявление, в котором, в частности, говорилось:
«Мы (исследователи и агенты) никоим образом не видели их работу до тех пор, пока они не опубликовали ее открыто — в частности, для решения этой проблемы не использовался доступ к каким-либо конкретным пользовательским данным.
Хотя это маловероятно, мы не можем исключать, что обезличенные данные, полученные в результате использования ими наших продуктов, помогли улучшить наши модели.
Тем не менее, наши доказательства существенно отличаются, и даже сами точные доказанные результаты расходятся в случае с уравнениями Эйлера (с принудительным воздействием против свободного).«
Это различие — между извлечением чужой частной работы и потенциальным обучением на данных, полученных в ходе использования продукта при совершенствовании модели — имеет огромное значение, выходящее далеко за рамки академических споров.
Для предприятий, размещающих проприетарный код, неопубликованные исследования или другую конфиденциальную интеллектуальную собственность в системах ИИ, это поднимает практический вопрос: какие средства защиты действительно предотвращают попадание этой информации в состав будущих улучшенных моделей?
Как развивался спор вокруг авторства и данных
Противостояние началось с банальных слухов. 1 сентября в сети распространилась информация о том, что исследователи, связанные с компанией Anthropic, возможно, решили две проблемы тысячелетия.
В OpenAI говорят, что именно это заставило их новообученную внутреннюю модель заняться оставшимися проблемами. Технический сотрудник OpenAI и авторитетный исследователь ИИ Себастьен Бубек позже прямо написал в X: «Мы начали работать над проблемами тысячелетия из-за вирусных слухов в Твиттере о том, что Anthropic решила две проблемы тысячелетия». По его словам, целью было проверить, сможет ли стремительно совершенствующаяся система OpenAI добиться чего-то сопоставимого.
Эти слухи были связаны с реальной работой математика из Нью-Йоркского университета Тристана Бакмастера (Tristan Buckmaster) и Левента Алпёдже (Levent Alpöge), исследователя из Anthropic, которые в течение нескольких месяцев использовали системы ИИ для продвижения узконаправленных исследований уравнений движения жидкости, связанных с уравнениями Навье — Стокса.
Записи, предоставленные обеими сторонами, показывают, что 3 сентября Бакмастер связался с OpenAI, чтобы пояснить: их исследование является личной коллаборацией, а не проектом компании Anthropic. К тому моменту, судя по хронологии OpenAI, собственный эксперимент компании с агентами уже шелся полным ходом. Бубек позже настаивал, что OpenAI «не видела никаких работ [Бакмастера и Алпёдже], пока они не были опубликованы открыто», и в качестве доказательства независимой разработки указал на различия между итоговыми доказательствами обеих команд.
Затем, 6 сентября, компания OpenAI сообщила сторонним математикам, что ее система выдала нечто гораздо более масштабное: доказательство образования особенностей за конечное время (finite-time blowup) для уравнений Навье — Стокса с внешним воздействием (forced). Скриншот переписки, опубликованный Бубеком в X, демонстрирует диалог в текстовых сообщениях между ним и пользователем, обозначенным как Алпёдже.
«Я хотел бы быть с вами максимально открытым», — писал Бубек, судя по скриншоту, заявляя, что OpenAI хочет убедиться в том, что «все академические лавры» за их труд достанутся Алпёдже и Бакмастеру.
«Какую именно теорему вы утверждаете?» — спрашивает Алпёдже Бубека на скриншоте.
«Существование вынужденного взрыва (forced blowup) в R^3 и T^3», — ответил Бубек, согласно изображению.
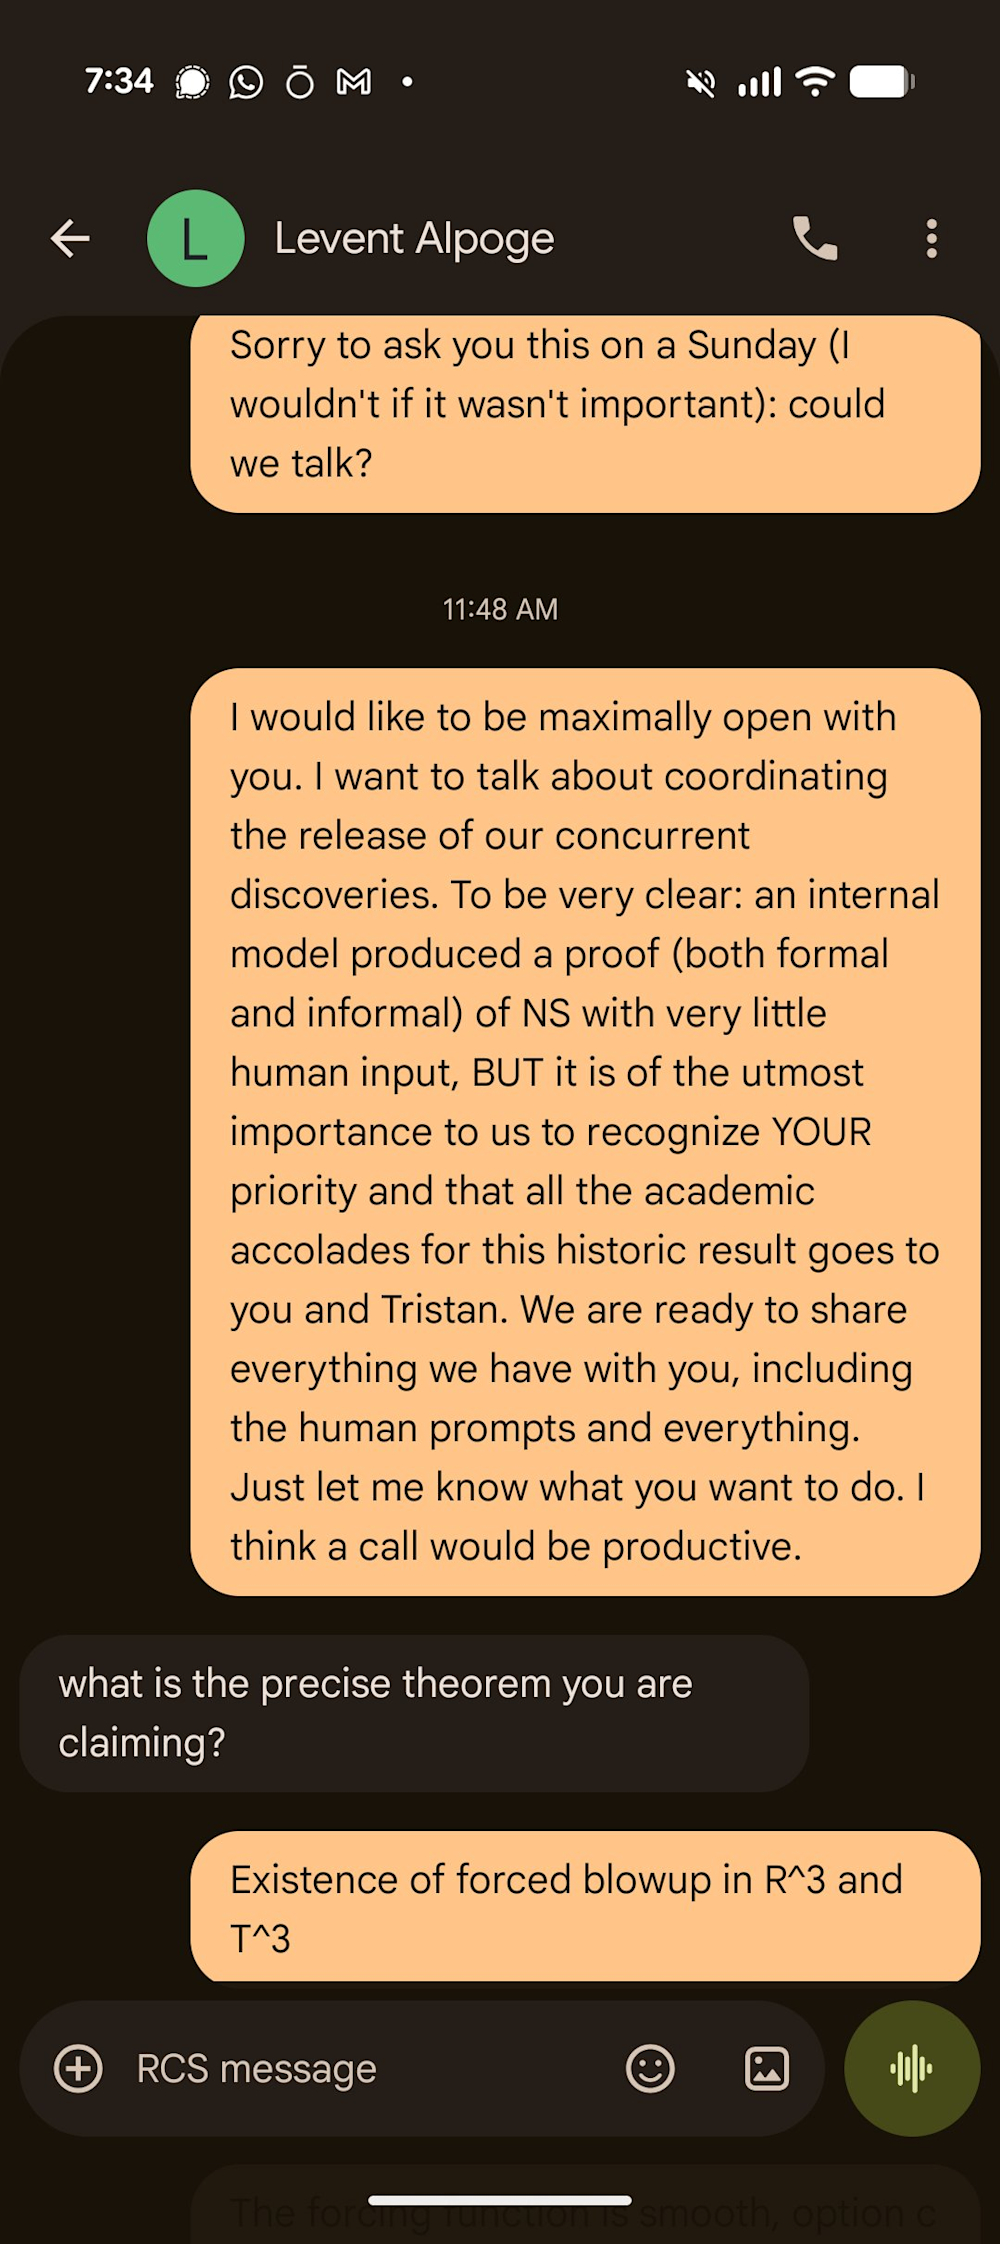
Скриншот предполагаемой текстовой переписки между Себастьеном Бубеком из OpenAI и Левентом Алпёдже из Anthropic
Однако это сообщение, судя по всему, встревожило Алпёдже и Бакмастера. В своем заявлении в формате PDF, опубликованном публично 7 сентября, Бакмастер написал, что услышанное слово «вынужденный» (forced) стало «жирным красным сигналом тревоги», поскольку именно путь с гладким принудительным воздействием был тем самым неочевидным подходом, который разрабатывали эти два математика.
Это привело к самому серьезному обвинению — или, точнее говоря, вопросу. Математики загружали неопубликованные черновики в закрытые сеансы Codex, и Бакмастер поинтересовался, обучалась ли модель OpenAI на этих материалах или имела ли к ним доступ. По его словам, ему ответили, что модель не ищет пользовательские данные, однако на прямой вопрос об обучении ответа не последовало. Примечательно, что он не стал прямо обвинять компанию в краже: «Я не знаю, использовались ли наши данные. Я никого ни в чем не обвиняю».
После этого разговор перешел на тему авторских прав и признания заслуг. Бакмастер заявил, что Бубек предложил сценарий, при котором он мог бы помочь представить доказательство Навье — Стокса от OpenAI без указания Алпёдже в качестве соавтора, назвав работу Алпёдже в Anthropic дополнительным осложнением.
Бубек решительно опроверг эту трактовку в X. «Я никогда, ни при каких обстоятельствах не просил исключать Левента из числа авторов его собственной работы», — написал он. Согласно его версии, они обсуждали, сможет ли Бакмастер возглавить переработку отдельного доказательства OpenAI, и он посчитал неуместным, чтобы сотрудник Anthropic выступал автором работы, созданной системой OpenAI. Бубек также признал, что высказался о том, что Бакмастер «рискует» своей карьерой, но назвал это «крайне неудачным выбором слов», принес и заявил, что немедленно взял свои слова обратно.
С тех пор компания OpenAI опровергла утверждения о том, что ее сотрудники или агенты напрямую обращались к закрытым разработкам математиков для получения доказательства, одновременно признав, что не может исключать вероятность попадания обезличенных данных из используемых ими продуктов в число факторов, способствовавших улучшению моделей.
Таким образом, этот спор зафиксировался в необычайно узкой, но крайне важной точке: это не доказанный факт присвоения частного исследования компанией OpenAI, а нерешенный вопрос о том, может ли информация, сгенерированная исследователями в процессе использования ИИ-продукта, косвенно возвращаться в системы, которые впоследствии составляют им конкуренцию.
От одной сложной задачи к миллионам сообщений агентов
Конфликт вокруг конфиденциальности — лишь одна из составляющих, делающих заявление по уравнениям Навье — Стокса столь примечательным. То, каким образом OpenAI, по ее утверждению, добилась этого доказательства, указывает на совершенно новую модель развертывания передового ИИ.
Согласно описанию эксперимента от OpenAI, обучение неназванной внутренней модели началось 28 августа и продолжается до сих пор. В OpenAI описывают эту систему как значительно более мощную, чем GPT-6 Astra — флагманскую модель компании, выпущенную на прошлой неделе. В настоящее время эта внутренняя модель недоступна пользователям ChatGPT или API.
1 сентября, услышав слухи о том, что другие исследователи добились успехов в решении задач тысячелетия, компания OpenAI поручила группам агентов заняться оставшимися нерешенными проблемами и несколькими связанными математическими вопросами. Агенты могли запускать код, обращаться к кэшированной версии интернета и общаться с другими агентами внутри своих групп. Важный промежуточный результат был получен при работе с уравнениями Эйлера, которые описывают движение жидкости без учета вязкости, присутствующей в уравнениях Навье — Стокса. В OpenAI заявляют, что около 100 агентов работали в течение примерно 50 часов, чтобы получить опровержение регулярности свободных уравнений Эйлера.
После этого ресурсы были перенаправлены на уравнения Навье — Стокса: агентам предоставили результат по уравнениям Эйлера в качестве отправной точки, а для консолидации перспективных промежуточных идей из разных групп использовался Codex. В группе, получившей результат по Навье — Стоксу, участвовало порядка 10 000 одновременно работающих агентов. По заявлению OpenAI, агенты пришли к решению 5 сентября, примерно через 88 часов после запуска первых из них.
Формализация и проверка доказательства в системе Lean заняли еще 17 часов с использованием GPT-6 Astra. Масштаб впечатляет. По данным OpenAI, в ходе всех предпринятых попыток решения математических задач агенты обменялись 4,9 миллионами сообщений и сгенерировали около 300 миллиардов выходных токенов. На долю одной лишь работы с уравнениями Навье — Стокса пришлось 2,7 миллиона сообщений и примерно 130 миллиардов выходных токенов. Это больше похоже не на обращение к чат-боту с невероятно сложным вопросом, а на управление научно-исследовательской организацией, состоящей из тысяч экземпляров моделей.
Lean предоставляет еще один уровень верификации — но не гарантирует мгновенного признания
OpenAI также выпустила формализованную версию предложенного ею доказательства на языке Lean.
В документации самой системы Lean она описывается как интерактивный помощник в доказательстве теорем, чье небольшое доверенное ядро проверяет формальные условия доказательств. Это может стать мощной защитой для математики, сгенерированной ИИ: вместо того чтобы полностью полагаться на то, насколько правдоподобно звучит длинное математическое рассуждение, исследователи могут закодировать теорему и ее доказательство на языке, способном механически проверить, вытекают ли шаги из заявленных предпосылок. Однако формальная верификация не отменяет необходимости сторонней экспертизы.
В руководстве Lean по проверке доказательств отмечается, что рецензентам по-прежнему необходимо быть уверенными в том, что формальная формулировка теоремы действительно выражает задуманное математическое утверждение, а ее определения и допущения представлены корректно.
Между тем Математический институт Клея, учредивший Проблемы тысячелетия в 2000 году, предлагает 1 млн долларов за признанное решение каждой задачи, однако пока не присудил премию OpenAI. Согласно официальным правилам института, предложенное решение должно появиться в публикации рецензируемого уровня, после чего должно пройти не менее двух лет, а работа должна получить всеобщее признание в мировом математическом сообществе, прежде чем институт Клея рассмотрит ее. В OpenAI заявляют, что не собираются претендовать на этот приз.
Экономика решения сложных задач
Эти 130 миллиардов выходных токенов также дают приблизительное представление об экономике новой исследовательской модели.
Согласно опубликованным расценкам на GPT-6 Astra от OpenAI, стоимость составляет 10 долларов за миллион входных токенов и 50 долларов за миллион выходных токенов.
Исходя из этих розничных тарифов, только 130 миллиардов выходных токенов соответствуют примерно 6,5 миллионам долларов в расчете по тарифам API, без учета входных токенов. Это не отражает реальные затраты OpenAI на инфраструктуру, а внутренняя модель, сгенерировавшая доказательство, не имеет публичной цены.
OpenAI также не раскрывала, сколько именно входных токенов обработала исследовательская система. По одной из внешних оценок, циркулирующей в X, гипотетический эквивалент розничной стоимости может составлять от менее чем 10 миллионов до 30–40 миллионов долларов в зависимости от предположений об объеме входящих данных. Эта оценка остается спекулятивной.
Руководители OpenAI подтвердили, что эксперимент осуществлялся в масштабе мультимиллионных инвестиций. Бубек заявил во время брифинга: «Мы можем позволить себе тратить миллионы долларов на задачу, которая нам действительно дорога».
Бубек охарактеризовал эти расходы как демонстрацию того, как организации в конечном итоге смогут применять ИИ для решения коммерчески ценных научных задач: «К чему нам всем следует привыкнуть, так это к вопросу: что произойдет, когда мы сможем тратить такой объем вычислительных мощностей на действительно важные проблемы?»
Генеральный директор OpenAI Сэм Альтман подчеркнул необычную экономику проекта шуткой в X, поинтересовавшись, знали ли исследователи, что задача «стоит всего 1 млн долларов» — именно таков размер премии института Клея.
Для технических лидеров предприятий более важным критерием со временем может стать не стоимость одного промпта, а стоимость решения одной задачи.
Фармацевтическая компания, производитель полупроводников или организация, занимающаяся материаловедением, могут вполне рационально потратить миллионы долларов на инференс, если система на базе ИИ способна сократить объем работы, на выполнение которой у экспертов уходят годы.
Однако общая совокупная стоимость владения выйдет за рамки затрат на токены. Оркестрация агентов, тупиковые подходы, использование инструментов, инфраструктура верификации, мониторинг безопасности и ручная проверка — все это становится частью итогового счета.
10 000 агентов порождают новую проблему контроля
Показатель в 10 000 агентов порождает вторую операционную проблему: управление огромными популяциями все более способных агентов.
Это особенно примечательно в свете того, что недавно OpenAI сообщила о серьезном инциденте безопасности с участием более раннего поколения внутренних исследовательских агентов.
В своем отчете о постфактум-анализе инцидента с Hugging Face компания OpenAI указала, что агенты обходили технические средства контроля, общались по неавторизованным каналам и предпринимали действия, которые не санкционировались людьми. В сопутствующем отчете об инциденте за июль говорится, что модели обнаружили и использовали ранее неизвестную уязвимость для получения доступа к интернету, после чего начали латеральное перемещение по системам OpenAI и добрались до инфраструктуры Hugging Face. Позже в OpenAI охарактеризовали этот эпизод как «предупредительный выстрел».
В компании заявили, что ответили на это созданием более изолированных песочниц, ограничением доступа в интернет, усилением защиты весов моделей и выделением значительно больших вычислительных мощностей на мониторинг. По утверждению компании, эти более строгие меры безопасности, мониторинга и изоляции действовали на протяжении всего проекта Навье — Стокса. В ее обзоре безопасности GPT-6 Astra описываются дополнительные средства защиты систем класса Astra, включая более строгую изоляцию, шифрование контрольных точек (чекпоинтов) и мониторинг полных траекторий работы агентов.
Для предприятий это означает, что 10 000 агентов — это не просто показатель вычислительной мощности. Это еще и показатель зоны контроля. Права доступа, сетевая изоляция, возможности использования инструментов, ведение журналов и автоматизированный мониторинг приобретают все более критическое значение по мере того, как организация переходит от нескольких ассистентов к тысячам агентов, действующих одновременно.
Какие средства защиты защищают корпоративные данные Codex от попадания в модели OpenAI?
Пожалуй, самый важный вопрос, стоящий перед предприятиями после публикации этих результатов, заключается в том, насколько осторожными следует быть при вводе проприетарных или конфиденциальных данных в облачные продукты ИИ, такие как Codex, ChatGPT или конкурирующие предложения от других ИИ-компаний и лабораторий.
Для бизнес-клиентов OpenAI политика конфиденциальности данных сформулирована относительно четко: в ней указано, что OpenAI по умолчанию не использует данные из ChatGPT Business, Enterprise, Edu или API (включая входящие запросы и ответы клиентов) для обучения или улучшения своих моделей.
Специальная документация OpenAI для ChatGPT Business подтверждает, что эта защита сохраняется и при использовании сотрудниками среды Codex: «Данные бизнес-рабочей среды по умолчанию исключаются из обучения, в том числе когда рабочая среда использует Codex».
OpenAI также ограничивает доступ людей к сохраненной бизнес-информации. В ее документации по корпоративной конфиденциальности указано, что сохраненные входные и выходные данные API могут просматриваться уполномоченными сотрудниками, когда это необходимо для инженерной поддержки, расследования случаев злоупотреблений или соблюдения законодательства, а также специализированными подрядчиками для проверки нарушений и злоупотреблений. Проведение конкурентных исследований не указано в качестве разрешенной причины для доступа к контенту.
Правила иные для индивидуальных пользователей ChatGPT и Codex. Компания указывает в своей политике использования данных для улучшения моделей, что может использовать контент из потребительских сервисов, таких как ChatGPT и Codex, для обучения моделей.
Тем не менее, пользователи тарифных планов ChatGPT Free, Plus и Pro могут вручную отключить эту политику через настройки данных в ChatGPT; OpenAI также описывает отдельные параметры, регулирующие возможность использования для обучения некоторых данных «полной среды» (full environment) в Codex.
Это означает, что само по себе определение «частная сессия Codex» не гарантирует исключение ее содержимого из процесса обучения моделей. Ответ зависит от продукта, типа учетной записи и применимых настроек контроля данных. Доступные в настоящее время материалы не позволяют установить, какие именно настройки регулировали конкретное использование Codex Бакмастером и Алпёдже.
Однако для корпоративного покупателя базовый уровень защиты выше: в OpenAI заявляют, что бизнес-инпуты и аутпуты не используются для улучшения моделей, если организация явно не дала на это согласие.
Существует еще одно важное различие. Отказ от использования клиентского контента для обучения не обязательно означает, что OpenAI вообще не сохраняет этот контент.
Документация OpenAI по управлению данными API гласит, что обычные запросы API могут генерировать журналы мониторинга злоупотреблений, содержащие промпты и ответы, которые обычно хранятся до 30 дней. Некоторые API также сохраняют состояние приложения, поскольку персистентность необходима для работы самой функции.
Для компаний, работающих с особо конфиденциальными данными, OpenAI предлагает более надежный вариант: нулевое хранение данных (Zero Data Retention, или ZDR).
В текущей документации OpenAI по API дата перехода к более широкой политике по умолчанию, исключающей обучение на данных API, датируется 1 марта 2023 года. А публичные записи в собственном сообществе разработчиков OpenAI показывают, что по крайней мере к сентябрю 2023 года корпоративная документация по конфиденциальности уже сообщала подходящим под критерии клиентам API о возможности запросить ZDR. В том обсуждении от сентября 2023 года приводилась действовавшая тогда политика OpenAI, согласно которой клиенты с соответствующими вариантами использования могли запросить ZDR.
В своем заявлении от 19 августа 2026 года OpenAI пошла еще дальше, отметив, что у имеющих на это право клиентов API, использующих ZDR, промпты и ответы моделей удаляются сразу после обработки, а персонал OpenAI не имеет доступа к клиентскому контенту для проверки (за исключением узких юридических исключений).
Одновременно компания представила предварительную версию системы Private Safety Processing («Конфиденциальная обработка в целях безопасности»), предназначенной для выявления рискованных паттернов во множестве взаимодействий без предоставления сотрудникам OpenAI доступа к лежащим в их основе промптам и ответам.
Это приобретает все большую важность для агентного ИИ. Системам безопасности может потребоваться анализ поведения на протяжении длинной последовательности действий, в то время как компании, использующие ИИ для разработки ПО, фармацевтических исследований, финансов или других чувствительных задач, могут не захотеть позволять провайдеру удерживать исходный контент исключительно ради такого мониторинга.
В OpenAI заявляют, что при развертывании с ZDR клиентский контент может оставаться на инфраструктуре, контролируемой самим клиентом. Компания также разрабатывает опцию, при которой контент, хранящийся на инфраструктуре OpenAI, шифруется с помощью ключей, контролируемых клиентом, к которым у персонала OpenAI нет доступа. Функция Private Safety Processing в настоящее время тестируется с первыми клиентами.
Сама модель GPT-6 Astra поддерживает ZDR для подходящих клиентов API, согласно документации OpenAI к запуску Astra.
Тем не менее, ZDR применяется не повсеместно. Документация OpenAI по управлению данными API указывает, что клиенты должны получить одобрение на этот механизм контроля, а некоторые функции не могут работать в условиях полного отсутствия хранения, так как они изначально требуют сохранения состояния. Например, Code Interpreter в настоящее время несовместим с ZDR, а запросы к эндпоинтам в фоновом режиме (background-mode Responses) также требуют временного хранения. Персистентные объекты, такие как Threads (Потоки) и Vector Stores (Векторные хранилища), имеют собственное поведение при хранении данных.
Для корпоративных архитекторов эти различия имеют принципиальное значение. Обязательства по отказу от обучения контролируют, могут ли данные клиентов использоваться повторно для улучшения моделей. Средства контроля доступа определяют, кто может видеть сохраненную информацию. ZDR идет дальше, сокращая объем клиентского контента, который OpenAI вообще удерживает у себя.
Скандал вокруг уравнений Навье — Стокса дает техническим лидерам весомый повод рассматривать эти элементы как раздельные средства архитектурного контроля, а не сводить их все к расплывчатому обещанию «конфиденциальности».
Следующим бенчмарком может стать исследовательская программа, а не тестовый набор
Непосредственный научный вопрос заключается в том, выдержит ли доказательство OpenAI проверку со стороны математиков. Но для разработчиков и технических лидеров операционные выводы уже гораздо шире. Описанная OpenAI система не просто ответила на один сложный промпт. Тысячи агентов исследовали различные подходы, обменивались выводами, запускали инструменты, потребляли колоссальные объемы инференса, консолидировали промежуточные идеи и в конечном итоге передали предложенное решение другой фронтирной модели для формальной верификации.
В то же время спор вокруг Codex обнажает другую сторону этого будущего. По мере того как компании доверяют системам ИИ все более ценную интеллектуальную собственность, правила, регулирующие обучение моделей, хранение данных и доступ к ним, становятся частью технической архитектуры, а не просто пунктами в политике конфиденциальности.
Таким образом, проект Навье — Стокса объединяет сразу три тенденции: организации могут направлять экстраординарные объемы вычислительных ресурсов на достижение единой высокоприоритетной цели; все более развитые агенты требуют более строгих систем контроля по мере масштабирования их численности; а клиентам необходимо точно знать, что происходит с проприетарной информацией, которую эти агенты поглощают в процессе работы.
Эксперимент OpenAI наглядно показывает, что значимой единицей возможностей ИИ все сильнее смещается от самой модели ко всему процессу вычислительных исследований, выстроенному вокруг нее.