


Дебютирует MiniMax M3, опережающий GPT-5.5 и Gemini 3.1 Pro по ключевым результатам тестов всего за 5-10% от их стоимости


В сфере корпоративного ИИ произошли громкие новости: в воскресенье вечером по североамериканскому восточному времени китайский ИИ-стартап MiniMax выпустил долгожданную большую языковую модель M3, которая объединяет возможности кодинга и автономных агентов передового уровня, контекстное окно на 1 миллион токенов и встроенную мультимодальность. При этом стоимость модели составляет лишь малую часть от цен на ведущие проприетарные аналоги, а тарифы по новым подписочным планам начинаются всего с 20 долларов в месяц.
Руководство компании также объявило о планах выпустить модель под лицензией с открытым исходным кодом, включая «открытые веса» (open weights), что позволит полностью скачивать ее для нужд предприятий и настраивать без каких-либо комиссий в течение ближайших 10 дней. На данный момент она доступна через API MiniMax по специальной льготной цене 0,3 доллара за 1 миллион входных токенов и 1,20 доллара за миллион выходных токенов (при свежем кэше) на следующую неделю — это значительно превосходит проприетарных американских гигантов, таких как Google, OpenAI и Anthropic, по стоимости, а также затмевает производительность новейших моделей последних на отдельных бенчмарках.
Даже по полной цене в 0,6 / 2,40 доллара за миллион входных и выходных токенов MiniMax-M3 обходится всего в 8–20% от стоимости ведущих проприетарных моделей США.
Традиционная матрица, определяющая разработку больших языковых моделей, долгое время диктовала жесткий выбор: разработчики программного обеспечения могли либо получать доступ к закрытым интеллектуальным системам высшего уровня через ограничительные API, либо развертывать гибкие и экономичные открытые модели, которые уступают в многошаговых рассуждениях, сложных задачах по программированию и обработке массивов данных. MiniMax-M3 кардинально меняет эту парадигму.
Объединив эти две исторически разделенные возможности передового уровня, M3 представляет уровень комплексной полезности, ранее доступный только в дорогих экосистемах с закрытым исходным кодом, фактически поднимая планку систем с открытыми весами и при этом радикально минимизируя вычислительные затраты, необходимые для выполнения сложных циклов разработки.
Сводка цен на API передовых ИИ-моделей от VentureBeat
|
Модель |
Вход |
Выход |
Общая стоимость |
Источник |
|
MiMo-V2.5 Flash |
$0.10 |
$0.30 |
$0.40 |
|
|
deepseek-v4-flash |
$0.14 |
$0.28 |
$0.42 |
|
|
deepseek-v4-pro |
$0.435 |
$0.87 |
$1.305 |
|
|
MiniMax-M3 |
$0.30 |
$1.20 |
$1.50 (только в течение ограниченного времени) |
|
|
Gemini 3.1 Flash-Lite |
$0.25 |
$1.50 |
$1.75 |
|
|
MiMo-V2.5 |
$0.40 |
$2.00 |
$2.40 |
|
|
Grok 4.3 low context |
$1.25 |
$2.50 |
$3.75 |
|
|
GLM-5 |
$1.00 |
$3.20 |
$4.20 |
|
|
Kimi-K2.6 |
$0.95 |
$4.00 |
$4.95 |
|
|
GLM-5.1 |
$1.40 |
$4.40 |
$5.80 |
|
|
Grok 4.3 high context |
$2.50 |
$5.00 |
$7.50 |
|
|
Qwen3.7-Max |
$2.50 |
$7.50 |
$10.00 |
|
|
Gemini 3.5 Flash |
$1.50 |
$9.00 |
$10.50 |
|
|
Gemini 3.1 Pro Preview ≤200K |
$2.00 |
$12.00 |
$14.00 |
|
|
GPT-5.4 |
$2.50 |
$15.00 |
$17.50 |
|
|
Gemini 3.1 Pro Preview >200K |
$4.00 |
$18.00 |
$22.00 |
|
|
Claude Opus 4.8 |
$5.00 |
$25.00 |
$30.00 |
|
|
GPT-5.5 |
$5.00 |
$30.00 |
$35.00 |
Новая техника разреженной аттенции MiniMax (MSA) помогает удерживать низкую стоимость модели
В основе эффективности модели лежит архитектурный отход от классических сетей на базе трансформеров. Стандартные механизмы внимания масштабируются квадратично ($O(N^2)$), а это значит, что вычислительные и финансовые затраты взрывообразно растут по мере увеличения текстовых входов.
Для борьбы с этим «вшитым изъяном» инженерная команда внедрила MiniMax Sparse Attention (MSA) — четкую и расширяемую схему разреженной аттенции.
Чтобы визуализировать это нововведение, представьте традиционное полное внимание как редактора, который читает всю библиотеку с нуля каждый раз, когда ему нужно проверить одно предложение. MSA выступает в роли интеллектуального клерка по индексации, использующего фазу предварительной фильтрации для разбиения матриц «ключ-значение» (KV) на высокоточные блоки.
На уровне операторов MSA использует подход «KV outer gather Q» («внешний сбор KV запросом»). Система обрабатывает блоки KV как внешний цикл, динамически агрегируя только те специфические запросы, которые попадают в них. Поскольку каждый блок данных считывается ровно один раз, а доступ к памяти остается строго непрерывным, использование оборудования взлетает до небес.
В ходе внутренних испытаний MSA работает более чем в 4 раза быстрее альтернативных решений с открытым исходным кодом, таких как Flash-Sparse-Attention или flash-moba.
При управлении максимальной длиной контекста в 1 миллион токенов потребность M3 в вычислениях на один токен падает всего до 1/20 от модели предыдущего поколения, что приводит к 9-кратному ускорению на этапе предварительного заполнения (prefilling) и 15-кратному приросту во время декодирования.
Вместо того чтобы взять предобученную текстовую сеть и объединить ее с отдельной моделью компьютерного зрения, MiniMax спроектировала M3 как изначально мультимодальную систему с «нулевого шага».
Компания переработала свои механизмы приема данных, чтобы объединить естественно чередующиеся последовательности текста, изображений и визуальных компонентов, увеличив общий объем обучающего корпуса до более чем 100 триллионов токенов.
Это глубокое выравнивание данных позволяет модели переводить сложные визуальные геометрии — например, программные графики или карты координат — в структурный код без потери контекстной точности. На стандартизированных оценках M3 подтверждает этот инженерный путь.
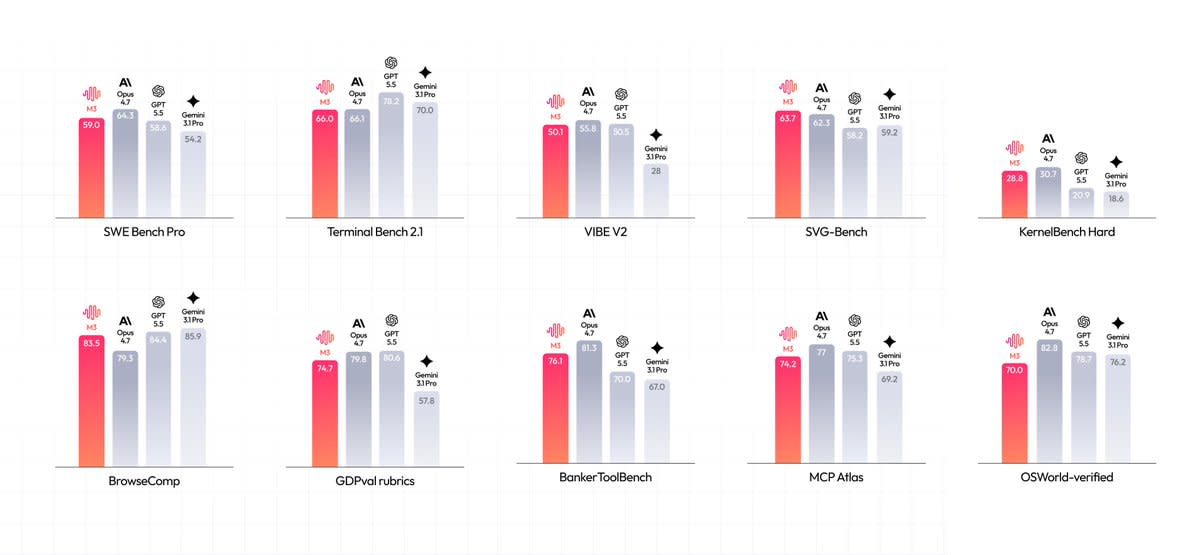
Модель набирает 59,0% на SWE-Bench Pro (метрика автономных агентов), опережая закрытые модели, такие как GPT-5.5 и Gemini 3.1 Pro. Она достигает 66,0% на Terminal Bench 2.1, 74,2% на MCP Atlas и 83,5 на BrowseComp, превосходя показатель Claude Opus 4.7 в 79,3 балла в автономном поиске в сети и извлечении информации.
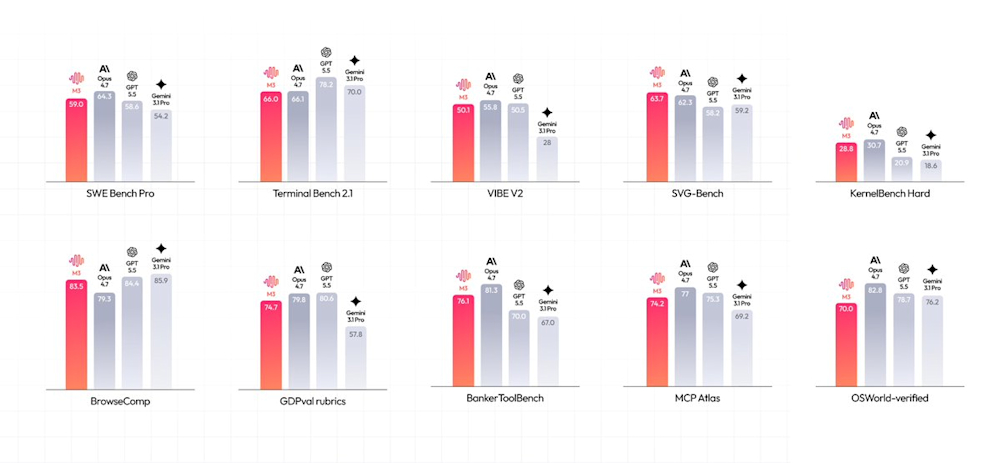
Сравнительная диаграмма бенчмарков MiniMax-M3. Источник: MiniMax
Тем не менее, при сопоставлении с выпущенной на прошлой неделе новой премиальной передовой моделью Anthropic — Claude Opus 4.8 — конкурентный потолок эффективной разреженной аттенции M3 становится очевидным в сопоставимых агентских бенчмарках с интенсивным использованием инструментов.
В области чистого изменения кода на SWE-Bench Pro результат M3 в 59,0% отстает от лидирующего порога Opus 4.8 в 69,2%.
Аналогичный разрыв в производительности проявляется и в средах автоматизированных систем через Terminal-Bench 2.1: в то время как показатель выполнения командной строки M3 в 66,0% фактически идет ноздря в ноздрю с базовым уровнем предыдущего поколения Opus 4.7 (66,1%), он уступает обновленной архитектуре Opus 4.8, которая достигает 74,6%.
Более того, оценки непрерывного взаимодействия с графическим интерфейсом в песочнице OSWorld-Verified оценивают уровень автоматизированного использования ПК у M3 на отметке 70,0% по сравнению с более высоким показателем в 83,4%, обеспеченным Opus 4.8.
Эти стандартизированные оценки иллюстрируют структурные компромиссы, определяющие современную экосистему: системы с закрытым исходным кодом, такие как Opus 4.8, сохраняют абсолютное преимущество по маржинальности в векторах гиперсложных рассуждений, однако M3 обеспечивает высокоэффективную базовую линию локальной автоматизированной работы высшего уровня без наценки за подписку на закрытые API.
При сопоставлении с мощными метриками инференса недавно созданной модели с открытыми весами DeepSeek-V4 Pro Max, M3 держится на равных в основных категориях агентов, демонстрируя при этом небольшие преимущества в специализированном синтезе кода.
В матрице программной инженерии SWE-Bench Pro эффективность разрешения M3 в 59,0% чуть превосходит результат DeepSeek-V4 Pro Max, составляющий 55,4%.
Тем не менее, конкурентная борьба в средах командной строки ужесточается: в оценках Terminal Bench модель DeepSeek-V4 Pro Max вырывается вперед с точностью выполнения 67,9% против 66,0% у M3.
В веб-оркестрации и симуляциях серфинга в открытом мире обе архитектуры достигают виртуального статистического паритета: M3 регистрирует 83,5% на BrowseComp по сравнению с 83,4% у DeepSeek.
Аналогично, в фреймворке использования инструментов MCP Atlas M3 добивается небольшого перевеса на уровне 74,2% против 73,6% у DeepSeek.
Это тесное соответствие показывает, что, хотя DeepSeek обрабатывает массивный общий объем параметров в 1,6 триллиона с использованием специализированных режимов повышенной сложности рассуждений, механизм блочно-фильтруемой разреженной аттенции от MiniMax обеспечивает напрямую конкурирующую эффективность выполнения без необходимости масштабного увеличения активируемых параметров.
ИИ-агент MiniMax Code предлагает возможности «Агентской команды»
MiniMax воплощает эти архитектурные достижения в немедленную пользу благодаря обновленному набору продуктов, разделенному на автономные приложения, настраиваемые уровни подписки и инфраструктуру для разработчиков. Флагманской реализацией для конечных пользователей является MiniMax Code — продукт на базе ИИ-агента, созданный для максимального раскрытия многошаговых возможностей M3.
Работая через веб-интерфейс или нативные десктопные приложения, MiniMax Code запускает «Агентскую команду» (Agent Team), способную разбивать масштабные инженерные задачи на многоэтапные параллельные рабочие процессы.
Система опирается на состязательный цикл «Продюсер + Верификатор». Пока один экземпляр агента генерирует код, второй экземпляр-верификатор агрессивно тестирует и анализирует результаты выполнения, позволяя сети самокорректироваться и работать автономно в течение нескольких дней без участия человека. Благодаря встроенной визуальной привязке MiniMax Code поддерживает прямое управление компьютером.
Разработчик может отправить голосовую подсказку через телефон сразу для нескольких приложений, чтобы модель открыла локальный клиент корпоративного ERP и пакетно заполнила таблицы данных прямо из открытой таблицы Excel.
Для пользовательских настроек разработчики могут напрямую подключать M3 к существующим рабочим процессам с помощью ключа API (sk-cp), совместимого с популярными альтернативными средами IDE, такими как Claude Code, Cursor, Roo Code и Cline. API представляет переключаемый «режим мышления» (thinking mode).
При включении M3 направляет вычислительную мощность на глубокие рассуждения и долгосрочное планирование; при выключении модель работает с минимальной задержкой для быстрого дополнения текста. Сопутствующий тарифный план Token Plan реализует агрессивную ценовую стратегию, построенную вокруг общих мультимодальных квот. При ежегодной оплате доступны три варианта:
-
Plus ($20 в месяц): Предоставляет около 1,7 млрд токенов в месяц и поддерживает 3–4 одновременных агента.
-
Max ($50 в месяц): Предоставляет около 5,1 млрд токенов в месяц, управляет 4–5 одновременными агентами и добавляет 3 автоматических видеоклипа в день через Hailuo 2.3.
-
Ultra ($120 в месяц): Предоставляет около 9,8 млрд токенов в месяц, обеспечивает работу 6–7 одновременных агентов и расширяет возможности видео до 5 клипов в день.
Открытые веса делают M3 гораздо более привлекательным для корпоративного использования
Обещание MinMax выпустить M3 по лицензии с открытыми весами — с публикацией весов и технической документации на HuggingFace и GitHub в течение 10 дней — имеет огромный стратегический вес для менеджеров корпоративной инфраструктуры.
Тем не менее, еще предстоит точно определить, под какой именно лицензией будут доступны веса и будет ли разрешено их использование потребителями (например, под лицензией MIT, Apache 2.0 или новой лицензией OpenMDW). Если да, то расчет выглядит следующим образом:
|
Функция / Атрибут модели |
Закрытые провайдеры API (например, GPT-5.5, Opus 4.7) |
Передовые открытые веса (MiniMax M3) |
|
Конфиденциальность данных и границы |
Требует внешних запросов к API; потенциальные векторы передачи данных. |
Полная локальная изоляция; работает полностью внутри закрытых пользовательских кластеров. |
|
Кастомная оптимизация |
Ограничено базовыми обертками для тонкой настройки или промпт-инжинирингом. |
Полный контроль над конвейером; архитектура позволяет глубоко кастомизировать адаптеры и веса. |
|
Постоянство векторов затрат |
Привязано к бессрочным моделям ценообразования API на основе токенов. |
Вычислительные потребности сокращены в 20 раз; снижается аппаратный потолок. |
Поставляя веса базовой модели напрямую в сообщество, MiniMax отходит от закрытого подхода, которому отдают предпочтение ведущие американские ИИ-лаборатории.
Для корпоративных пользователей, связанных строгими правилами комплаенса и конфиденциальности, открытые веса означают возможность запускать M3 локально на внутреннем оборудовании.
Такая настройка полностью устраняет риск утечки данных, связанный с публичными API. Кроме того, она позволяет инженерным командам проводить специализированные процедуры тонкой настройки (fine-tuning), модифицировать внутренние архитектуры или внедрять кастомные системные промпты глубоко в слои модели, превращая коробочное решение в высокоцелевой корпоративный актив.
Первые реакции сообщества исключительно положительны
Экосистема разработчиков отреагировала на эксплуатационные бенчмарки M3 незамедлительно, выделив его долгосрочное автономное поведение и профиль соотношения цены и производительности.
Главной точкой обсуждения стал 12-часовой тест на автоматизированную верификацию, в рамках которого перед M3 была поставлена задача воспроизвести работу-победителя премии ICLR 2025 Outstanding Paper Award под названием «Динамика обучения при тонкой настройке языковых моделей» (Learning Dynamics of LLM Finetuning).
Как подчеркнул исследователь MiniMax @MikaStars39 в X:
«M3 работал автономно почти 12 часов, самостоятельно создав 18 коммитов и 23 экспериментальных графика, и заставил основные эксперименты работать:
-
он совпал с прогнозируемыми тенденциями вероятности на этапе SFT;
-
четко зафиксировал эффект сжатия (squeezing effect), являющийся центральным для экспериментов DPO;
-
подтвердил метод снижения рисков Extend, предложенный в оригинальной статье».
Одновременно с этим создатели инструментов для разработчиков обратили внимание на практические экономические преимущества нового механизма внимания модели. Официальная команда разработчиков помощника для написания кода с помощью ИИ-агентов Cline опубликовала предупреждение, подтверждающее совместимость с первого дня:
«Новый MiniMax-M3 — их первая модель с контекстом в 1 млн токенов, мультимодальностью и возможностями агентского кодинга. Поздравляем @MiniMax_AI с прорывом в архитектуре разреженной аттенции, снизившим вычислительные затраты и стоимость до 1/20 по сравнению с предыдущим поколением».
Это резкое падение затрат на выполнение меняет то, как разработчики смотрят на взаимосвязь между финансовыми инвестициями и возможностями. Технический обозреватель @jumperz обрисовал этот сдвиг, отметив, как M3 ломает исторический паттерн в ценообразовании машинного обучения:
Решая ограничения масштабирования контекста с помощью фундаментальных оптимизаций на уровне внимания, а не грубого аппаратного масштабирования, компания MiniMax установила высокоэффективную базу с открытым исходным кодом. M3 демонстрирует, что следующий этап развития агентов будет определяться не только большими наборами данных, но и эффективными архитектурными решениями, делающими производительность передового уровня доступной для более широкого сообщества открытого ПО.
Для предприятий, создающих автономную разработку программного обеспечения или агентскую инфраструктуру, MiniMax M3 обеспечивает максимальную отдачу от вложенных средств («bang for the buck»).
Хотя DeepSeek-V4 Pro имеет микроскопическое ценовое преимущество в $0,195 за миллион токенов, MiniMax M3 оправдывает свою небольшую надбавку за счет предоставления более высоких показателей автономного решения задач программной инженерии (59,0% в SWE-Bench Pro).
Что еще более важно, поскольку M3 является моделью с открытыми весами, расчеты выходят далеко за рамки таблицы API. Развертывая веса M3 локально внутри частных корпоративных облаков, организации полностью обходят отслеживание исходящего облачного трафика данных, устраняют структурную зависимость от одного поставщика (vendor lock-in) и могут внедрять собственные модели кэширования префиксов на внутреннем оборудовании. Такой технический подход превращает высокоэффективный бюджет выполнения в постоянный, находящийся в частной собственности корпоративный актив.




